
资讯文章
APM 工具买回来用不起来?三个落地断层与对应的验收口径
APM 工具买回来用不起来,多数不是功能不够,而是选型标准与落地标准不是一套。本文把落地过程拆成三个断层:埋点覆盖率上不去、指标建了一堆没人看、告警响了没人认领,并给出对应的验收口径——关键交易链路覆盖率、看板使用率与告警有效率、从告警到责任人的分钟数,最后附一张上线 30 天与 90 天的验收清单。
应用告警太多修不过来?从「告警」到「工单」的闭环改造
应用告警太多修不过来,往往不是因为告警不准,而是因为告警没有接上流程。本文把“告警→工单”拆成闭环四步:分级、派单、跟踪、复盘,说明每一步的验收口径和常见卡点,并结合 Gartner 2026 事件智能定位与 Cortex XCOR 的 AI SRE 实测数据,指出真正拉开差距的是事件能不能在监控、CMDB、ITSM 之间自动流转。
Kafka消费积压怎么处理?消息队列监控与扩容判断
Kafka消费积压怎么处理?本文从Consumer Lag、生产速率、消费速率、Partition和消费者处理耗时入手,判断积压根因,并分析什么时候应该扩容消费者。
接口突然变慢怎么排查?应用性能问题的分层定位法
接口突然变慢怎么排查?本文从网络、应用、Redis、MySQL到基础设施四层定位性能瓶颈,并结合APM、应用监控、数据库监控等方法,快速找到接口变慢的根因。
SkyWalking等开源APM够用吗?算完三年总账再决定
SkyWalking等开源APM免费就代表三年成本更低吗?本文从软件、服务器、存储、实施、运维人力、扩容、二次开发和故障成本等维度拆解APM三年TCO,并通过真实故障PoC比较开源APM与商业APM的定位效率、维护工时和长期投入,帮助企业建立更完整的APM选型方法。
Datadog、New Relic还是国产APM?国内企业选型全对比
Datadog、New Relic与国产APM该怎么选?从技术栈兼容性、诊断深度、部署、监控范围四大维度对比,附带权重评分模型,帮国内企业完成APM选型评估。
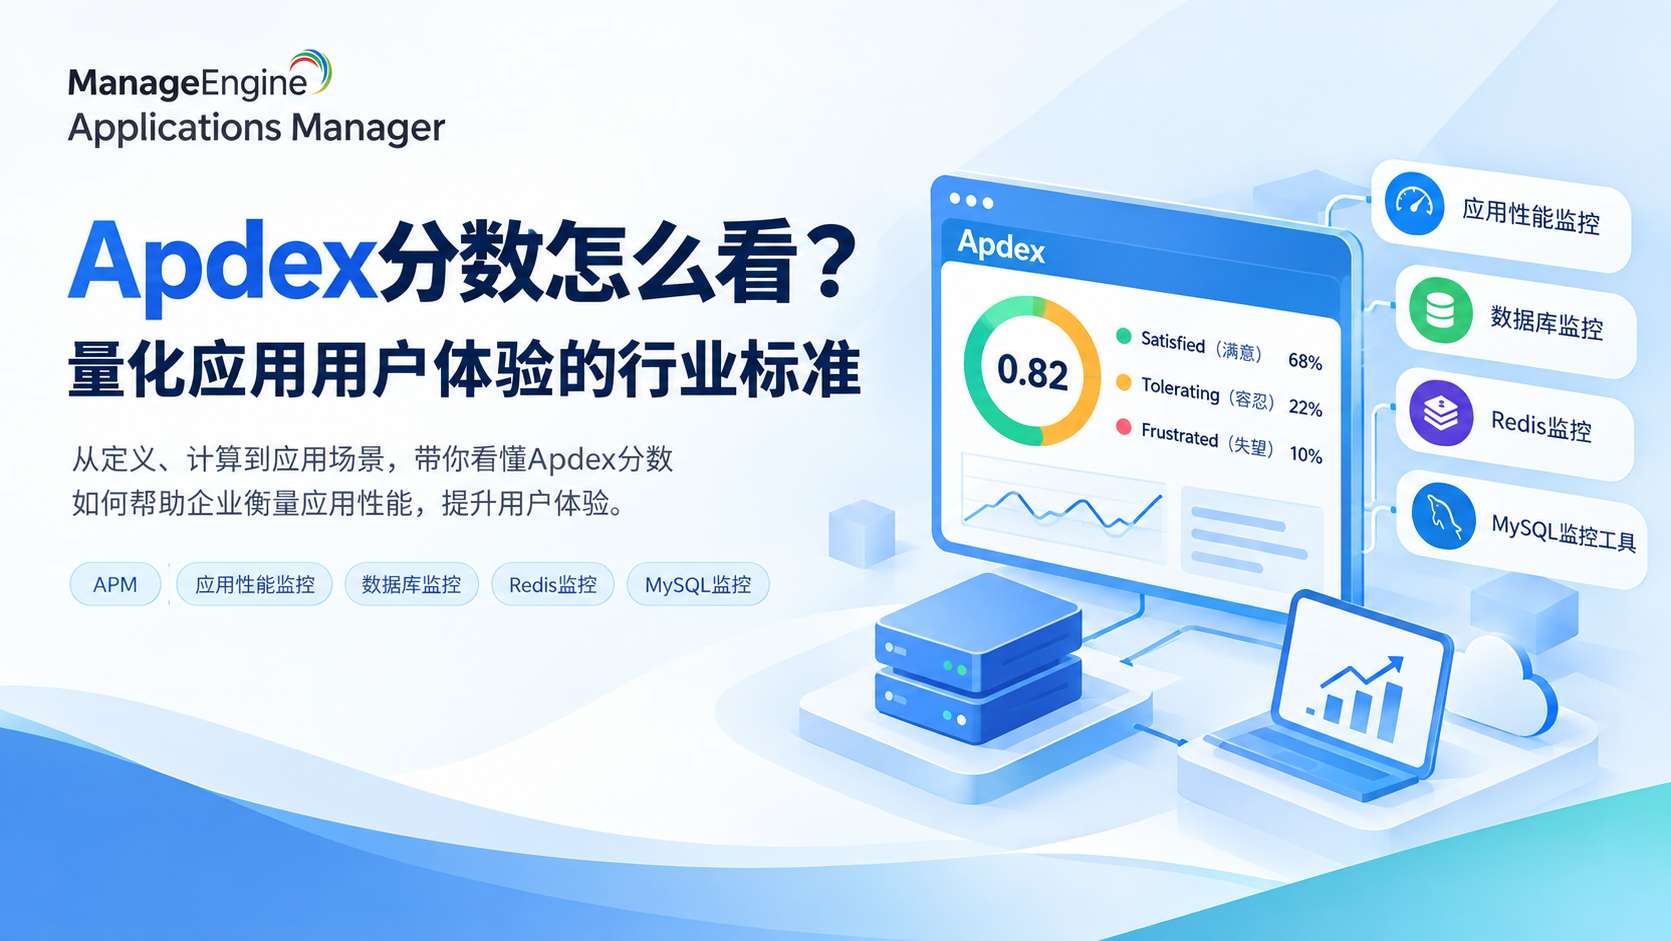
Apdex分数怎么看?量化应用用户体验的行业
Apdex分数怎么看?本文介绍Apdex是什么、Apdex计算公式、T值与4T标准,以及如何结合APM工具、应用监控和数据库监控分析用户体验与应用性能。
DORA指标怎么自动化采集?DevOps效能度量的四步实操
DORA 四大指标(部署频率、变更前置时间、变更失败率、服务恢复时间)如何自动化采集?本文给出「四步采集法」:统一定义、打通数据源、自动关联、基线与看板,并说明应用监控在其中的关键作用。
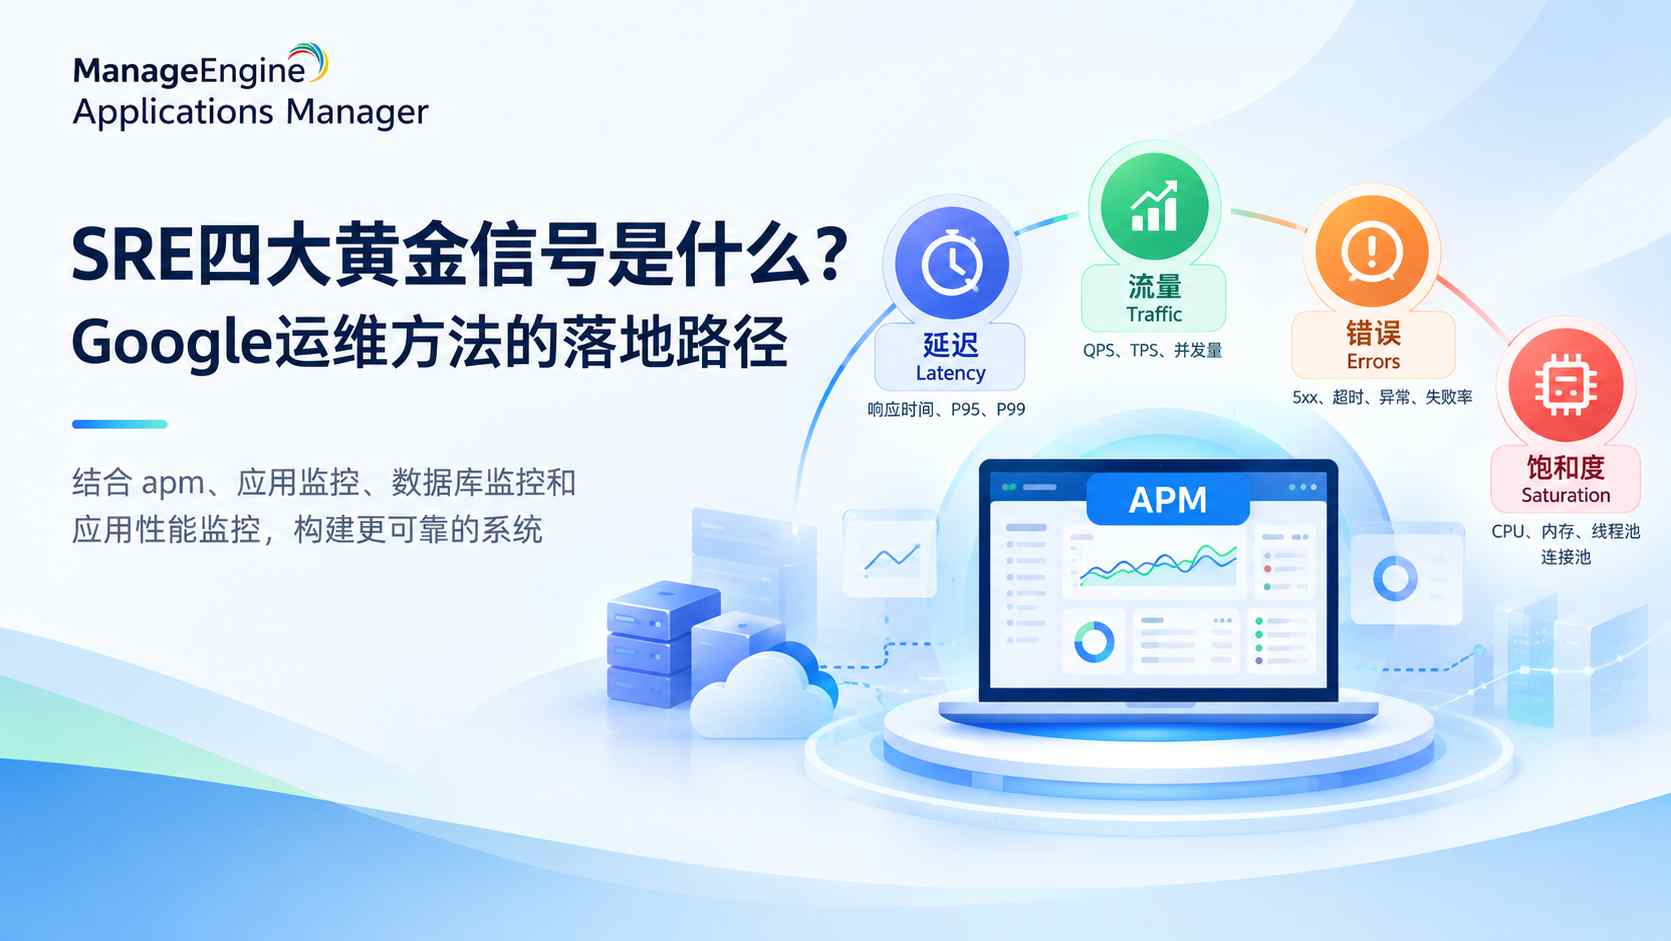
SRE四大黄金信号是什么?Google运维方法的落地路径
SRE四大黄金信号包括延迟、流量、错误和饱和度。本文介绍四大信号的核心指标及企业落地方法,并结合apm、应用监控、数据库监控和应用性能监控,帮助运维团队建立从应用到数据库的统一监控体系。
什么是RUM?真实用户监控与合成监控的区别和选择
RUM(真实用户监控)采集真实用户端性能,合成监控用脚本主动探测可用性。本文用对照表讲清两者区别,并给出「合成做守门员、RUM 做体检」的互补落地建议。
指标、日志、追踪有什么区别?可观测性三大支柱入门
指标、日志、追踪是可观测性三大支柱,分别回答系统健康度、发生了什么、卡在哪一步。本文用对照表讲清三者区别,并给出指标→日志→追踪的落地采集四步,适合运维与 SRE 入门。
什么是可观测性?与传统监控的三大区别,一次讲透
可观测性的核心定义:只靠指标、日志、追踪三类输出数据,就能推断系统内部真实状态。本文逐条拆解它与传统监控的三大区别——预设问题还是任意提问、看组件健康还是看业务链路、告警驱动还是数据驱动,并给出"三问递进法"的落地路径。附对照表与三个避坑要点,含零售企业大促案例(故障定位从 40 分钟压缩到 8 分钟)。适用于向微服务或容器化演进的应用团队,含 5 条高频问题解答。
AIOps智能告警与根因分析实战指南
本文全面介绍如何使用ManageEngine Applications Manager构建AIOps智能告警与根因分析体系,内容涵盖传统静态告警的痛点剖析、动态基线与告警压缩降噪实战方法、基于拓扑关联与时间线比对的根因分析技术、从故障发现到自动自愈的闭环自动化设计与风险分级、AIOps三步落地路径与MTTD MTTR效果评估指标,帮助企业运维团队从告警海洋中解放出来,将告警量压缩90%以上,实现故障的精准发现与快速定位,稳步迈向智能运维。
JVM监控与Java应用性能优化实战指南
本文全面介绍如何使用ManageEngine Applications Manager构建JVM监控与Java应用性能优化体系,内容涵盖JVM内存、GC、线程、类加载四层核心指标体系,堆内存趋势与GC停顿分析方法,死锁检测与线程池水位监控实战,内存泄漏、线程池耗尽等常见Java性能问题的诊断路径,以及基于性能基线的JVM调优闭环与容器环境特殊注意事项,帮助Java开发与运维团队快速定位并解决应用性能问题,实现从被动救火到主动预防的Java性能管理升级。
电商大促应用性能保障实战指南
本文全面介绍如何使用ManageEngine Applications Manager构建电商大促场景下的应用性能保障体系,内容涵盖大促流量特征与全链路监控需求分析、大促前容量评估与全链路压测验证方法、大促中实时大屏监控与分级告警应急响应机制、下单支付黄金链路分层监控与大促专属阈值设定、大促后数据复盘与容量模型优化,帮助电商企业运维团队实现从容量规划到应急指挥的完整大促保障闭环,确保大促期间核心交易链路稳定运行,为业务高峰提供坚实的应用性能监控支撑。