
应用性能监控:换了新 CPU,应用为什么还慢

AI 摘要
随着新一代至强平台在数据中心陆续落地,不少单位进入服务器换代周期,但换机后常见的落差是:硬件跑分上去了,应用响应时间几乎没动。原因在于一次请求的耗时由四段组成——CPU 计算、GC 停顿、数据库等待、下游调用,换 CPU 只压缩第一段。本文拆解换机后最常见的三个断层(堆还按老机器配、数据库没跟着升级、下游没扩容),给出升级验收要看的五个指标与基线记录方法,每个指标都附“不达预期时先查什么”。
答案先说:应用响应时间没降之所以在换机后让人失望,是因为硬件解决的是“算得快”,而应用慢通常慢在“等得久”——等 GC、等数据库、等下游接口。这三类等待不会因为换了新 CPU 而缩短,甚至有些会变得更明显。
这个话题最近又热了起来:随着至强 6+ 平台在国内外数据中心陆续落地,一批单位进入服务器换代窗口。但很多团队做完迁移、跑完冒烟测试才发现,业务接口的 P95 响应时间和升级前几乎一样——钱花了,感知没有变化。
问题不在硬件,而在验收方式:大多数团队验收只看“CPU 使用率降了没”,不看“耗时花在了哪”。本文换一个视角,把一次请求的耗时拆开,看换机到底压缩了哪一段、没动哪三段。

核心要点
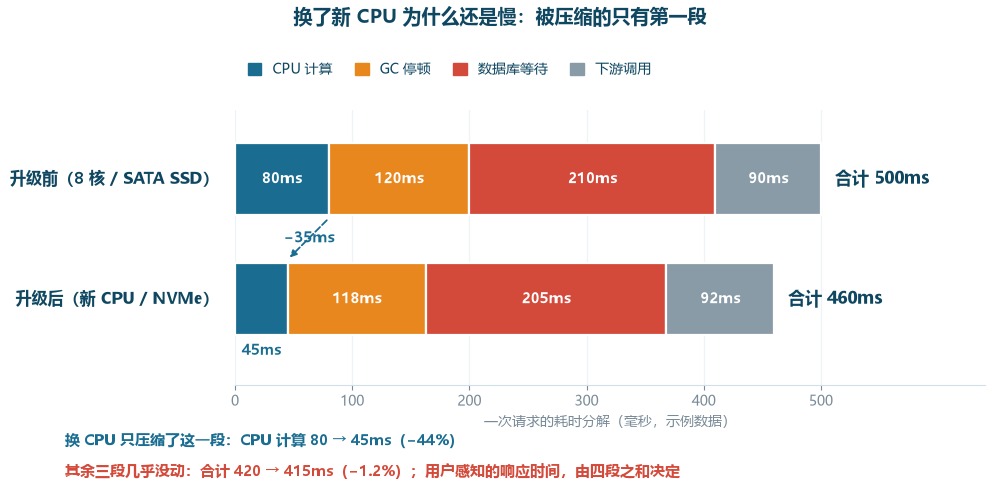
- 一次请求的耗时 = CPU 计算 + GC 停顿 + 数据库等待 + 下游调用,换 CPU 只压缩第一段;第一段往往只占两成。
- 断层一:堆与新生代还按老机器的规格配,核心数上去了,GC 反而更频繁、停顿更长。
- 断层二:应用层快了,数据库没跟着升级,连接池先被打满,慢 SQL 集中暴露。
- 断层三:本机 30ms、下游 200ms,用户感知由后者决定,换机改善不了下游。
- 验收必须先记基线:响应时间 P95、GC 停顿、慢 SQL、池等待、下游耗时占比,五个指标一张表。
先把一次请求拆开:慢在哪一段
用户点一次按钮,到页面出结果,这段响应时间在系统内部要穿过四段:CPU 计算(业务逻辑、序列化、加解密)、GC 停顿(JVM 回收内存时暂停工作线程)、数据库等待(SQL 执行、拿连接、等锁)、下游调用(远程接口、消息队列、缓存)。用户感知到的,是四段之和。
换新 CPU 直接改善的只有第一段。用一组示例数字看就很直观:升级前一次请求 500ms,其中 CPU 计算 80ms、GC 停顿 120ms、数据库等待 210ms、下游调用 90ms。新机器把 CPU 段压到 45ms,其余三段纹丝不动,总耗时 500ms 变成 460ms——硬件规格翻了倍,用户只感到快了 8%。
所以换机前要先回答一个问题:CPU 计算到底占这次请求的多大比例?如果只占 15%,那么就算计算段提速一倍,整体也只快 7%。这个比例不需要猜,应用性能监控 里的事务追踪会把每一段的耗时拆出来;Google SRE 也把延迟、流量、错误、饱和度列为监控的四个黄金信号,其中“延迟”要看的是分段耗时,不是机器负载。
断层一:机器快了,JVM 没跟着快
最常见的断层出在 JVM 配置上。很多应用的堆大小、新生代比例,是当年按 4 核 8G 的机器定的;换到 32 核的新机器后,操作系统多了,堆还是 4G。结果就是:对象分配速率没变,但回收停顿被更长的 I/O 等待和更高的并发同时放大,GC 停顿在响应时间里的占比不降反升。
典型的表现是:CPU 使用率上去了,吞吐量却没上去。这不是 CPU 在干业务,而是在跑垃圾回收。确认方法很直接:打开 JVM 监控,看停顿时间与频率两条曲线——Young GC 每秒多次、Full GC 每小时一次且停顿一两秒,堆使用曲线呈密集锯齿,就说明堆的规格已经跟不上了。
修复动作有三件:按新机器的内存重设堆与新生代比例;评估切换到 G1 或 ZGC 这类以停顿为目标设计的收集器;排查大对象与缓存无上限增长。具体调到多少,Oracle 的 GC 调优指南里给了完整的方法论——它强调的第一步不是调参数,而是先明确“可接受的停顿目标”,这恰好也是业务方该在升级前就给出的输入。
断层二:磁盘快了,慢 SQL 才浮出来
第二个断层更有迷惑性:换了新机器之后,慢 SQL 的数量反而变多了。原因通常是两个。其一,老的机械盘或 SATA 盘太慢,把一部分“缺索引”的查询掩盖在 IO 等待里,换到 NVMe 之后数据库返回变快,这些查询被执行得更频繁,问题反而集中暴露。
其二,应用服务器升级了,数据库还是老实例。应用层处理变快意味着单位时间打进来的请求更多,数据库的连接池先被打满,请求在池外排队——表现为应用 CPU 空闲、响应时间却很高,数据库侧活跃连接数顶在池上限。
确认与修复都落在 数据库性能监控上:看慢 SQL 排行与执行计划,把 TOP5 逐条加索引或改写;连接池大小按新机器的并发能力重算,而不是沿用老配置。注意顺序:先解决索引与 SQL,再动连接池——池子调大只是让更多慢查询并发跑,数据库整体反而更慢。
断层三:本机快了,下游没跟上
第三个断层在系统边界外。一个典型的业务接口,本机计算 30ms,要调两个下游服务、查一次缓存,下游合计 200ms。换机之后本机变成 15ms,用户感知的响应时间只少了 15ms——剩下 215ms 由下游决定,而下游不在这次采购清单里。
这类断层单看本机指标是发现不了的:CPU、内存、线程全部空闲,一切正常,用户却在投诉。唯一的确认方式是看调用链:事务监控把一次请求在各个服务之间的跳转串起来,耗时集中在哪个 span、哪个下游变慢了一目了然;W3C Trace Context 定义的追踪上下文传播格式,正是为了让这些分段耗时能跨服务、跨语言地对得上。
修复手段按优先级排:给慢下游扩容或加缓存;给不重要的调用改异步;给必须同步的调用设合理的超时与重试,避免下游抖动把线程池拖垮。这些动作没有一个需要买新硬件,却往往比换机本身对响应时间的贡献更大。
升级验收:五个指标,先记基线再对比
换机不是上线就结束,验收要做在数据上。前提是升级前就把基线记下来——峰值时段的响应时间 P95、GC 停顿、慢 SQL 条数、池等待、下游耗时占比。没有基线,升级后就只能靠感觉。五个指标对照如下:
| 验收指标 | 升级前先记基线 | 升级后应看到 | 不达预期先查 |
|---|---|---|---|
| ① 响应时间 P95 | 峰值时段均值与 P95 | 降幅与 CPU 段占比同量级 | 慢请求是否集中在同一接口 |
| ② GC 停顿占比 | 每秒次数 + 最长停顿 | 停顿总量下降,最长 < 200ms | 堆与新生代是否仍按老机器配 |
| ③ 慢 SQL 条数 | 每分钟条数 + TOP5 | 条数下降或执行计划改善 | 数据库是否还是老实例 |
| ④ 池等待 | 平均等待 + 排队长度 | 等待时间明显下降 | 池大小与并发是否匹配 |
| ⑤ 下游耗时占比 | 调用链各段占比 | 自身段变短,下游段不变 | 下游是否需要同步扩容 |
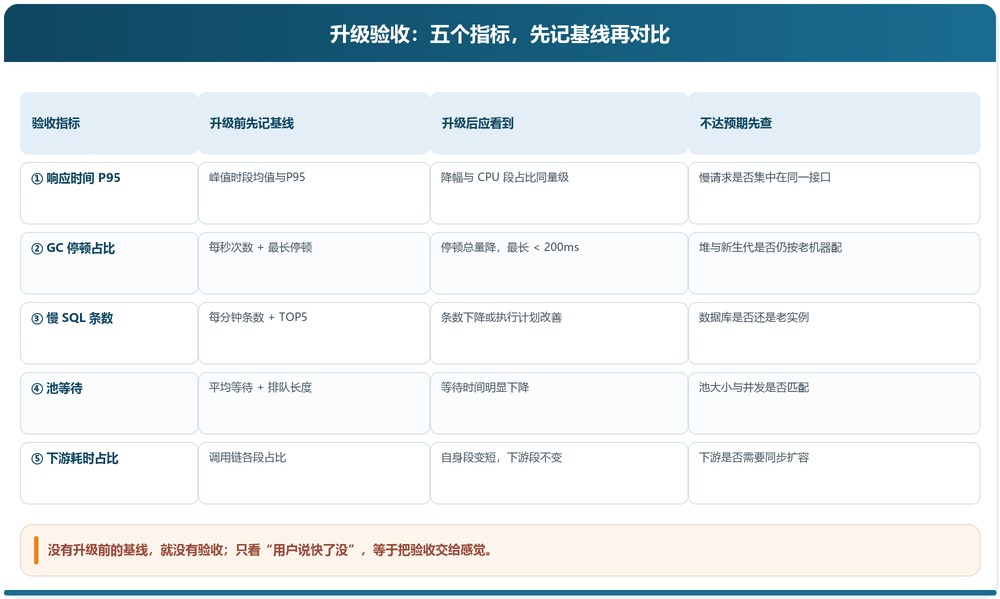
这张表的用法是逐行打钩:五项里任何一项不达预期,都能在“先查什么”一列找到下一个动作,而不是回到“要不要再加机器”的老路上。多数情况下,答案就在 GC 配置、SQL 索引和下游扩容里,三件事的成本加起来不到一次换机的一成。
最后把工具的位置说清楚:硬件升级解决“算得快”,ManageEngine Applications Manager解决“看得清”。它不能替代换机的决策,但能告诉你这次换机到底改善了多少、下一笔预算该花在哪一段。
参考来源
1. Oracle《Java Platform, Standard Edition HotSpot Virtual Machine Garbage Collection Tuning Guide, Release 21》:堆与新生代配置、收集器选型、停顿目标的权威方法论。
2. Google《Site Reliability Engineering》Monitoring Distributed Systems 一章:延迟、流量、错误、饱和度四个黄金信号,以及“分段看延迟”的监控思路。
3. W3C《Trace Context》推荐标准:分布式追踪上下文在服务间传播的统一格式,是调用链分段耗时能跨服务对齐的基础。
说明:文中耗时数字为示意值,用于说明比例关系;实际数值随业务与部署差异很大,请以自身监控基线为准。
一句话总结:换机只压缩了“算”的那一段,“等”的三段要靠 GC 调优、SQL 与索引、下游治理来解决——先记基线,再谈验收,钱才不会白花。
延伸阅读
想把这三个断层一次看清?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 换了新 CPU,为什么压测数据几乎没变?
答:先看压测场景打的是哪一段:如果压的是“等得久”的链路(数据库、下游接口),CPU 段的改善对总耗时贡献很小。正确顺序是先用事务追踪拆出各段耗时占比,再决定升级哪一层;只看 CPU 使用率高就换机,常常换错对象。
- GC 停顿多久算异常?
答:没有统一数字,但有共同口径:以“停顿时间占响应时间的比例”衡量。 Young GC 频繁到每秒多次、Full GC 单次超过 1 秒,通常意味着堆规格或收集器已经不适合当前负载,需要按官方调优指南的方法重配。
- 只升级应用服务器、不升级数据库,有意义吗?
答:有意义,但要预期“瓶颈转移”:应用层变快后,单位时间打到数据库的请求更多,连接池与慢 SQL 的问题会提前暴露。所以换机验收要把数据库侧指标(活跃连接、慢 SQL、锁等待)一起看,否则容易误判为“换机没用”。
- 响应时间看平均值还是 P95?
答:验收和容量规划都应以 P95 / P99 为准。平均值会被大量快请求稀释,掩盖少数极慢请求;而用户投诉和“越用越卡”的体验,几乎都来自长尾那部分。平均值可以看趋势,不能作为验收结论。
- 没有 APM 工具,靠日志能定位这三个断层吗?
答:能定位一部分:GC 日志可确认断层一,数据库慢查询日志可确认断层二;但断层三(下游等待)需要跨服务的分段计时,散落的日志很难按同一次请求对齐。没有追踪能力时,可以先做下游接口的独立压测来近似确认。
