
应用性能监控数据可信吗?AI 时代的三个校验方法

AI 摘要
AI 摘要:2026 年 10 月 1 日,Google 暂停了开源软件漏洞奖励计划的产品漏洞提交,原因是 AI 生成的无效报告淹没了人工验证渠道。这件事对运维的启示很直接:当内容的生成成本趋近于零,验证能力就成了可信度的底线——监控数据也一样。本文给出三个校验方法:来源可溯、口径一致、异常可解释,每个方法回答一个问题、给出一个不合格信号和一种最低成本的落地做法,最后附一张可直接对照的三校验清单。
答案先说:应用性能监控的数据能不能信,不取决于工具高端与否,而取决于三条校验有没有做过:来源可溯、口径一致、异常可解释。三条都过,数据才能拿去做决策;缺任何一条,看板越漂亮越危险。
这不是危言耸听。2026 年 10 月 1 日起,Google 暂停了开源软件漏洞奖励计划(OSS VRP)的产品漏洞提交,官方给出的原因是自动化提交数量激增、绝大多数无效——大量由 AI 生成、看起来很专业的报告。当内容的生成成本趋近于零,验证就成了最稀缺的资源,监控数据正处在同样的位置。
ManageEngine Applications Manager在这类场景里的位置,不是替你判断对错,而是让每一条指标都能回答三个问题:它从哪来、按什么口径统计、异常时对应什么事件。
核心要点
- 监控数据也在「AI 化」:自动生成的看板、自动归因的告警越来越多,可信度要靠校验,不能默认信任。
- 三校验:来源可溯(这条数据怎么来的)→ 口径一致(同一指标在不同视图里是否同义)→ 异常可解释(波动能否对应到事件)。
- Google 暂停 OSS VRP 的教训同样适用于监控:生成端成本趋零之后,验证能力就是可信底线。
- 口径不一致最常见也最贵:平均值、Apdex、p95 给出三个答案时,先查口径,再怀疑系统。

一份 AI 报告,为什么会拖垮一个赏金计划
先把锚点事件说清楚。10 月 1 日,Google 宣布暂停开源软件漏洞奖励计划(OSS VRP)的产品漏洞类提交,官方原因是「自动化提交数量激增,绝大多数无效」,承诺 2027 年一季度给出调整方案。被淹没的验证团队面对的,是一批格式完整、术语专业、细看却是模型幻觉的报告。
机制并不复杂:大模型把「写一份像样的报告」的成本压到零,而验证每份报告的人工成本一点没降。同类的事今年接连发生——curl 年初关闭了赏金通道,英特尔 9 月取消了赏金现金奖励。当生成端免费,验证端就是整个系统的瓶颈。
把这个结论平移到应用性能监控上:自动生成的看板、自动归因的告警、自动汇总的周报越来越多,它们同样「看起来很专业」——可信吗?答案取决于有没有做过校验。
监控数据的「AI 化」:三种常见的不可信
第一种是来源不清。助手根据「你可能关心的指标」自动生成看板,图很漂亮,但没人核对过这条数据从哪个采集点来、经过什么转换。第二种是口径不一。同一个「响应时间」,在概览页是平均值,在报表里是 p95,在告警里又是另一个时间窗,三个数字都「对」,答案完全不同。第三种是异常无解。曲线上每个毛刺都找不到对应事件,解释全靠当事人回忆「那天我们是不是发过版」。
这三种不可信不是 AI 时代才有的,但 AI 把它们放大了:自动生成让「没人核对」变成常态,自动归因让错误结论更有说服力。要校验的不是某个数字,而是数据进入决策前的三个环节。
校验一 · 来源可溯:这条数据是怎么来的
要回答的问题只有一个:这条数据从哪个采集点来、经过什么转换、延迟多少。这是应用监控可解释性的起点——合格的标志,是任何人在任何看板上点开一个数字,都能在两步之内看到它的出处。
落地做法是给每个新指标登记采集链路:采集点、采样方式、聚合周期、入库时间。来源记录最完整的是全链路追踪——分布式追踪实战指南讲的调用链,本质上就是给每一次请求留下完整的来源路径。
不合格的信号很好认:排查会上有人问「这个响应时间是哪台采集器报的」,全场没人答得上来。这种时候做的任何归因,都建立在没法验证的地基上。
校验二 · 口径一致:同一个词是不是同一个意思
要回答的问题是:同一指标在不同视图里,时间窗、聚合方式、过滤条件是否一致。口径定义在可观测性体系里属于语义约定层——指标、日志、追踪有什么区别?可观测性三大支柱入门讲清了指标、日志、追踪三者的边界,而语义约定的意义,正是让「同一个词」在跨系统时仍是同一个意思。
最典型的分歧在响应时间上:平均值适合看趋势,Apdex 量化的是满意比例,p95 反映的是最慢的那批真实请求。三个口径各有用途,但放在一起看时必须知道彼此的差异,Apdex 分数怎么看?量化应用用户体验的行业方法专门讲过这套量化方法。看板上不标口径,是分歧最常见的来源。
口径敏感的例子在缓存层更明显。Redis 的缓存命中率,在redis monitor里按键空间与过期策略统计,而应用侧看到的命中率可能还包含本地缓存——两边的「命中率」字面相同、口径不同,对不上时先查定义,再查系统。
校验三 · 异常可解释:波动能不能对应到事件
要回答的问题是:曲线上每一次明显的波动,能不能对应到一次发布、一次配置变更、一次扩缩容或者一次外部事件。能对应,数据才是「可解释的」;不能对应,就只能说「数据在动」,说不出「发生了什么」。
最低成本的做法是把变更时间线叠加到曲线上——里程碑标记:标注应用性能,追踪关键变更影响做的就是这件事:把发布与变更钉进时间轴,波动与事件一眼对齐。这一步做完,根本原因分析才有可靠的起点,否则每次归因都在重演「靠回忆破案」。
不合格的信号同样好认:复盘会上花在「还原当时发生了什么」上的时间,比花在「怎么避免再发生」上的还多。
三校验对照表与用法
把三个校验合成一张表,用法是逐行自评:哪一行的「不合格信号」命中了,就先补那一行的落地做法,再谈别的。
| 校验项 | 要回答的问题 | 常见不合格信号 | 最低成本的落地做法 |
|---|---|---|---|
| 来源可溯 | 这条数据从哪个采集点来、延迟多少 | 看板上的数字,没人说得清出处 | 指标上线时登记采集链路 |
| 口径一致 | 同一指标在不同视图里是否同义 | 平均值、Apdex、p95 各说各话 | 看板上直接标注口径 |
| 异常可解释 | 波动能否对应到变更或外部事件 | 每个异常都要靠人回忆「那天改了什么」 | 把变更时间线叠到曲线上 |
| 责任到人 | 三项校验分别由谁负责 | 出了问题才临时找人核对 | 把指标 owner 写进清单 |
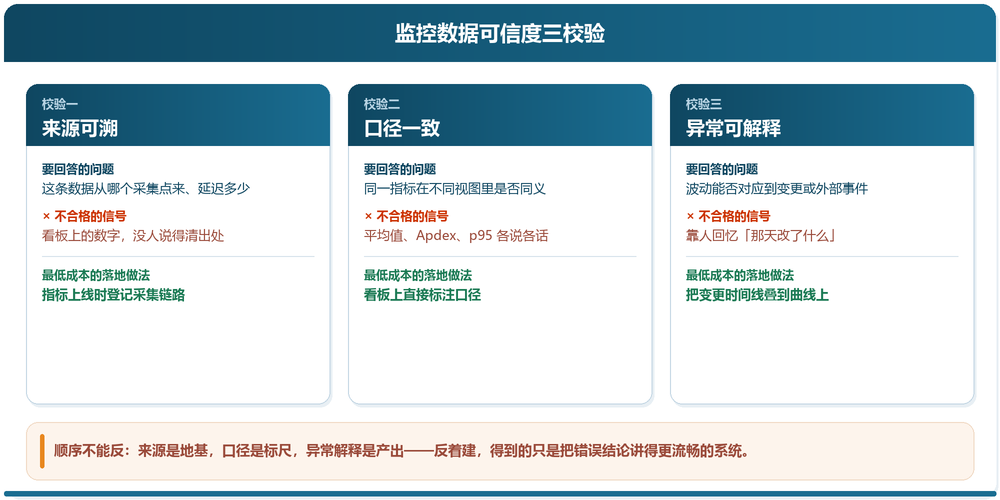
这张表的顺序有讲究:来源是地基,口径是标尺,异常解释是产出。顺序反了——先追求自动归因、再回头补来源与口径——得到的只是一个把错误结论讲得更流畅的系统。
与告警治理的分工
如果团队的痛点是告警太吵,应用性能监控告警配置实战:从阈值设定到告警降噪的 5 个关键步骤讲的是「信号怎么变干净」;本文讲「数据本身能不能信」——一个管去噪,一个管验真,顺序上先验真。数据不可信时调阈值,只是把噪声换个形状;口径统一之后,很多「误报」会自动消失。
在apm系统的日常使用里,建议把三校验做成季度动作:每季度抽二十个高频指标走一遍来源、口径、异常解释,没通过的记进下季度整改清单。校验不追求一次做完,追求每次都有增量。
参考来源
1. OpenTelemetry Semantic Conventions(跨系统遥测数据的命名与语义约定)
2. ISO/IEC 25010 系统与软件质量模型(性能效率与可维护性的评价维度)
说明:文中三校验为通用实践归纳;OSS VRP 暂停事件依据 Google 官方公告页与公开报道;产品能力以官方页面为准。
一句话总结:数据可信不是工具送来的默认属性,而是三项校验的结果:来源可溯、口径一致、异常可解释。生成成本趋零的时代,验证能力才是应用性能监控的可信底线。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- AI 生成的监控看板和分析结论能直接用吗?
答:能参考,不能直接用。自动生成解决的是「从零搭起来」的效率问题,但生成环节不负责核对来源与口径。建议把 AI 生成物当作草稿:上线前过一遍来源可溯与口径一致两项校验,通过再交给团队使用。
- 同一指标两个视图不一致,信哪个?
答:先别急着选边,先查口径:时间窗、聚合方式、过滤条件三处差异对齐之后,两个数字要么一致,要么差异可以解释。仍然对不上的,查采集链路是否有丢点或重复计数。经验上,多数「数据不准」最后都被证明是口径问题而不是采集问题。
- 监控数据要保留多久才够支撑复盘?
答:建议三层:原始明细保留两周到一个月,用于精确排查;聚合后的分钟级数据保留一年,用于同比环比与季节性分析;变更与事件记录与指标同周期保留——没有变更时间线,异常可解释这项校验就永远做不完。
- 怎么向上证明监控数据是准的?
答:不要拿「系统很稳定」来证明,拿校验记录来证明:抽十个业务关心的指标,逐条给出采集来源、口径定义和最近一次异常的事件对应关系。能出示这三样,可信度就不用靠印象维持。
- 三校验要投入多少人力?
答:起步阶段两个人一天可以完成一轮抽查:一个人核对来源与口径,一个人补变更时间线。之后每次新指标上线多花十分钟登记链路,每季度一轮增量校验,持续成本很低。
