
接口突然变慢怎么排查?应用性能问题的分层定位法

AI 摘要
接口突然变慢不必急于重启服务,本文介绍四层分层定位法,从用户网络层、应用层、依赖层、基础设施层逐层排查性能问题,同时给出标准化五步排查流程。借助APM、调用链、数据库与缓存监控,沿证据链缩小故障范围,高效定位接口变慢真实根因。
接口突然变慢,先别急着重启服务。ManageEngine Applications Manager 可以把应用、数据库、服务器等监控数据放到同一条排障路径里。真正高效的排查,不是“看一个指标找答案”,而是先判断慢在哪一层,再用调用链、依赖指标和基础资源逐层收窄范围。
关键要点
1、接口变慢优先采用四层分层定位思路:用户/网络层 → 应用层 → 依赖层 → 基础设施层,先定位再优化,避免盲目扩容资源。
2、性能分析不要只看平均值,P95、P99长尾指标更能真实反映用户遇到的慢请求。
3、接口慢很多时候根因在下游依赖:Redis缓存退化、数据库慢SQL、锁等待,多个组件故障会互相传导。
4、CPU、内存指标正常不等于服务健康,线程池、连接池、GC、磁盘IO等待会造成请求排队超时。
5、严格执行五步排查流程,故障处理前保留Trace、SQL、指标现场证据,防止重启丢失故障现场。

先判断:接口到底慢在哪一层?
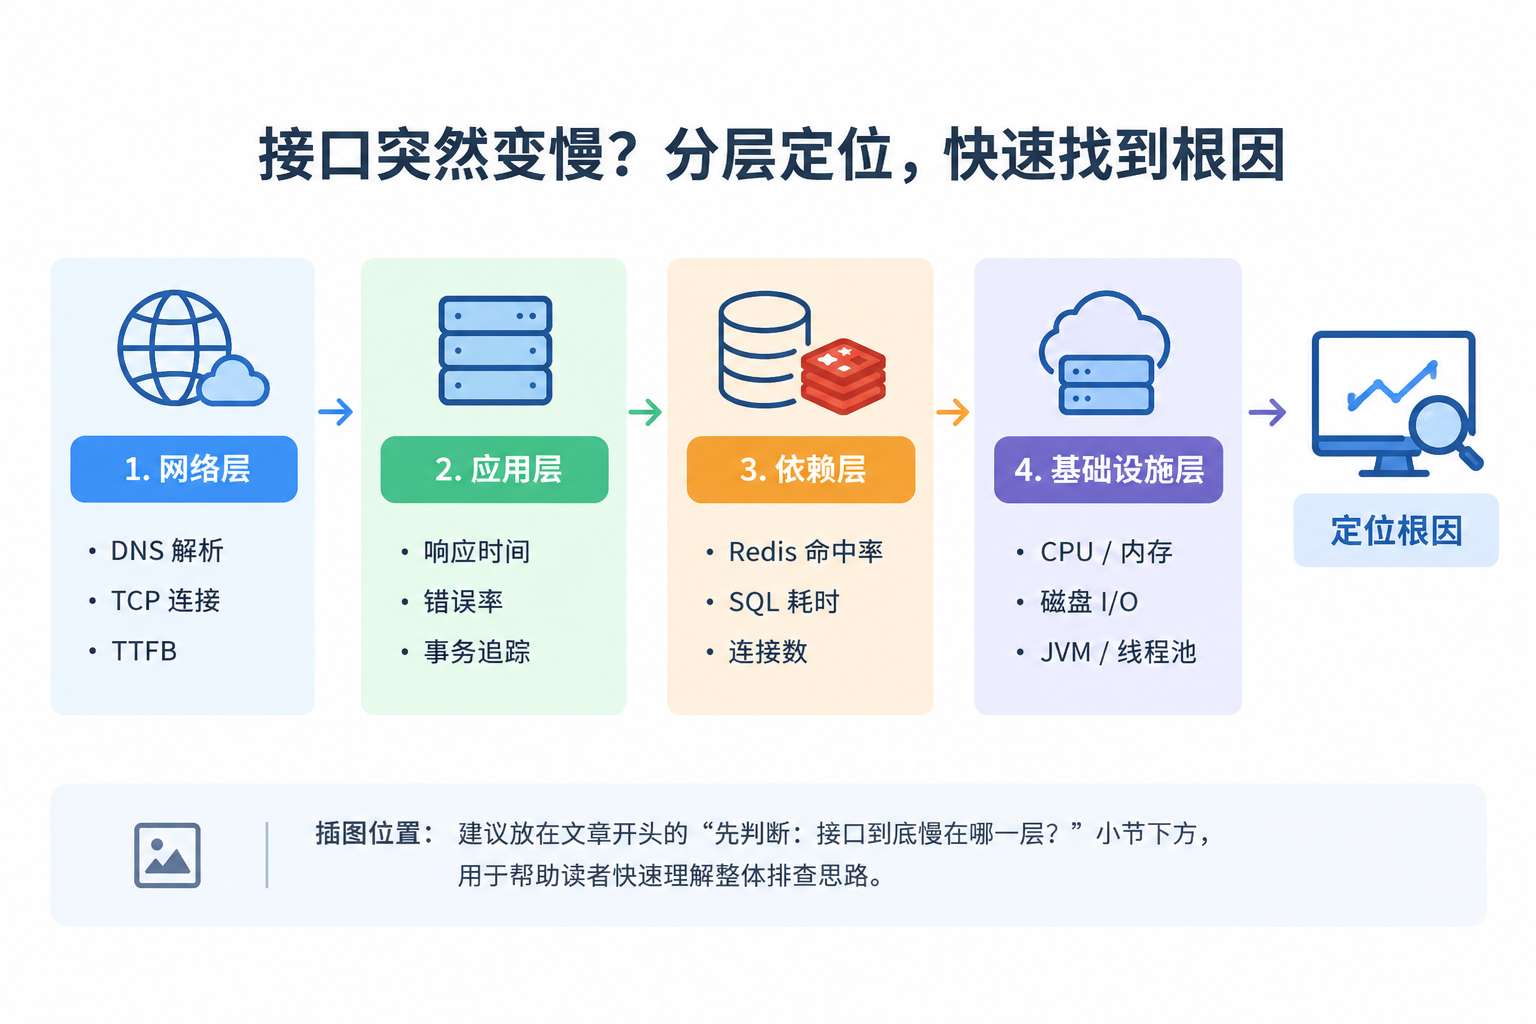
把问题拆成四层:用户/网络层、应用层、依赖层、基础设施层。每层回答一个问题:
| 层级 | 先看什么 | 典型结论 |
|---|---|---|
| 用户/网络层 | DNS、TCP、TLS、TTFB、页面/接口响应 | 网络或入口链路异常 |
| 应用层 | P95/P99、吞吐、错误率、事务耗时、Trace | 代码或服务调用变慢 |
| 依赖层 | Redis命中率、SQL耗时、连接数、锁等待 | 缓存/数据库拖慢请求 |
| 基础设施层 | CPU、内存、磁盘I/O、JVM、线程池 | 资源饱和或容量不足 |
先做“定位”,再做“优化”。否则很容易出现数据库明明正常,却先去扩容数据库;CPU只有40%,却因为连接池耗尽导致请求大量排队。
第一层:先排除“入口看起来慢”
如果用户反馈“接口很慢”,第一步不是登录服务器,而是确认请求到底在哪里花了时间。
对于网站场景,可以通过网站监控观察DNS解析、TCP连接、TLS握手、TTFB和完整加载时间;对于API,则重点记录客户端到网关、网关到服务之间的延迟。
一个实用判断是:TTFB慢,优先查服务端;TTFB正常但整体响应慢,再查前端资源、网络传输或第三方依赖。
同时关注P95、P99,而不是只看平均值。平均响应时间1秒,不代表没有用户遇到5秒甚至10秒的长尾请求。
第二层:应用层看“慢在哪一步”
进入应用监控后,重点看三个信号:响应时间、错误率和吞吐量。如果只有某一个接口的P99突然升高,而整体CPU、内存正常,问题往往更接近应用代码、线程池或下游调用。
这时需要借助APM和分布式追踪,把一次慢请求拆成:
网关 → API服务 → 业务方法 → Redis → MySQL → 第三方服务。
例如一个订单接口总耗时3秒,Trace显示应用本身只执行了200毫秒,但SQL等待了2.4秒,那么优化代码并不是优先动作。
这里的核心是应用性能监控要能继续下钻:从接口到事务,从事务到代码,再到具体依赖。否则监控只能告诉你“哪里红了”,却无法回答“为什么红”。
第三层:数据库和缓存往往才是隐藏瓶颈
接口变慢经常不是应用服务本身的问题,而是下游依赖开始等待。
先看数据库监控中的查询耗时、活跃连接、锁等待、慢查询数量。如果是MySQL环境,可以使用mysql监控工具定位慢SQL、执行计划和连接异常。
再看缓存层。Redis问题不一定表现为Redis宕机,更常见的是命中率下降、连接数异常、内存压力、键淘汰或复制延迟。通过redis监控可以确认缓存是否正在退化;需要更细粒度排查时,再结合redis monitor关注具体指标和趋势。
典型链路是:
Redis命中率下降 → 更多请求落到MySQL → 数据库连接数上升 → SQL等待变长 → API P99飙升。
所以不要把“接口慢”“Redis慢”“MySQL慢”当成三个独立事件,它们可能只是同一次故障在不同层的表现。
第四层:最后再看CPU、内存和资源饱和
只有当前三层没有找到明显根因时,再深入基础设施。重点检查CPU、内存、磁盘I/O、网络、JVM GC、线程池和数据库连接池。
尤其注意“资源使用率不高但服务很慢”的情况:CPU 40%并不能证明应用健康。线程池队列堆积、连接池达到上限、磁盘I/O等待或GC停顿,都可能让请求排队。
因此,基础设施指标最好与应用性能监控、数据库监控放在同一时间窗口内比较,而不是单独看一张服务器仪表盘。
把排查流程固定成“五步”
第一步,确认影响范围:哪个接口、哪个时间段、哪些用户受到影响。
第二步,确认异常层级:网络、应用、缓存/数据库还是基础设施。
第三步,锁定慢请求:用P95/P99和Trace找到异常事务。
第四步,验证下游依赖:检查Redis、MySQL、消息队列和第三方服务是否同步异常。
第五步,保留证据再处理:记录异常时间、关键指标、Trace、SQL和资源状态,避免“重启后问题消失、现场也没了”。
ManageEngine Applications Manager 的价值,不是替你猜根因,而是把应用、数据库、服务器、网站等数据串起来,让排查从“凭经验猜”变成“沿证据链下钻”。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 为什么平均响应时间正常,用户还是说接口慢?
因为平均值会掩盖长尾。建议重点观察P95、P99,并按接口、地域、实例和时间段拆分。
- CPU不高,为什么API还是超时?
可能是线程池、数据库连接池、网络I/O、锁等待或GC停顿导致排队。CPU只是其中一个信号。
- Redis命中率下降,一定是Redis本身故障吗?
不一定。也可能是业务缓存策略变化、热点Key失效或上游请求模式改变,需要结合应用和数据库数据一起判断。
- 数据库监控应该重点看哪些指标?
优先关注查询耗时、慢查询、活跃连接、锁等待、吞吐量和资源使用,并结合业务接口定位影响最大的SQL。
- APM工具在接口排障中最重要的能力是什么?
不是监控指标越多越好,而是能否从异常接口继续下钻到事务、调用链、代码和数据库等依赖,形成完整证据链。
相关阅读
• Datadog、New Relic还是国产APM?国内企业选型全对比
• SkyWalking等开源APM够用吗?算完三年总账再决定
