
应用性能监控:双11 大促前的四道性能防线

AI 摘要
双11 大促当天的应用故障,多数不是"容量不够",而是平时被平均值掩盖的长尾问题,在高利用率下被排队效应成倍放大。本文给出大促前的四道防线:容量水位与全链路压测、长尾慢接口治理、数据库连接池与慢 SQL、可一键执行的降级预案;并附大促当天要盯的五个数字(P95、错误率、连接池水位、GC 停顿、下游耗时占比)与"越线先查什么"对照表。
答案先说:大促保障的重点不是"多加机器",而是"提前看到高水位下的系统"。系统在 85% 利用率下的行为,和在 40% 利用率下完全是两回事——排队延迟不是线性增长,而是越接近上限涨得越快。大促保障的核心动作只有一个:把系统在预发或压测环境里真实地推到目标水位,看清楚会发生什么。
每年大促复盘,最常见的结论都不是"机器买少了",而是:某个平时 300ms 的接口在峰值冲到 3 秒、数据库连接池比预想早半小时打满、一个下游抖动把整个线程池拖住。这些问题的共同点是——它们在平峰期全都"看不见"。
本文结合 ManageEngine Applications Manager 这类 APM工具的实践,把大促前的准备工作拆成四道防线,每道防线都给出"做什么、看什么数字、越线先查什么",最后汇总成大促当天可以直接盯的一张表。

核心要点
- 利用率与延迟是非线性关系:从 45% 升到 85%,排队延迟放大约 3.7 倍;扩容前先算水位,而不是拍台数。
- 平均值掩盖长尾:99 次 100ms 加 1 次 10 秒,平均只有 200ms;大促要盯 P95 / P99,不看平均值。
- 最先打满的往往是数据库连接池:慢 SQL、锁等待、池排队三件事叠加,才是典型的"大促雪崩"路径。
- 预案要能一键执行:超时、限流、降级开关必须在预发环境演练过;只写在文档里的预案等于没有。
- 当天盯五个数字:P95、错误率、连接池水位、GC 停顿、下游耗时占比,每个都有明确的越线动作。
一、容量不是拍脑袋:先有水位,再谈扩容
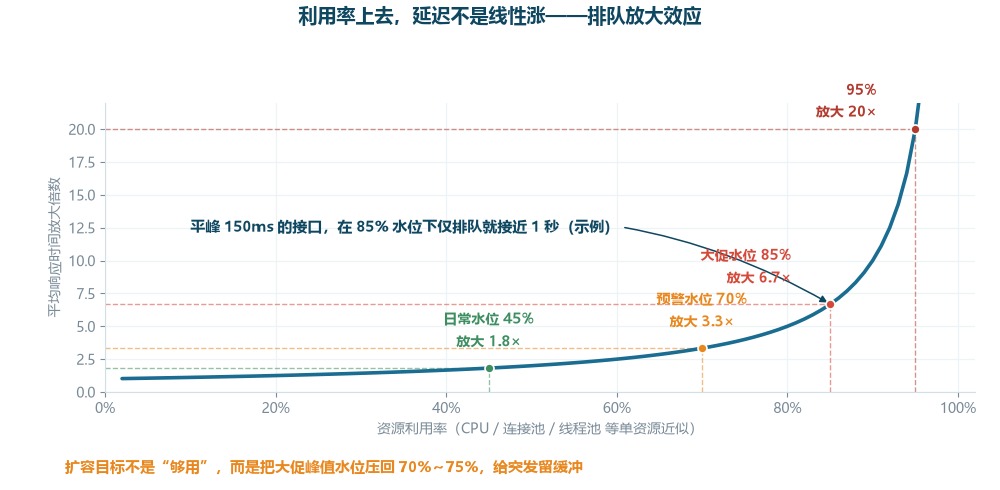
大促容量规划的第一课,是理解利用率与延迟的关系不是线性的。排队论里有一个经典结论:资源利用率越高,排队等待的时间增长越快。以单资源近似,平均响应时间的放大倍数约等于 1 ÷(1 − 利用率)。代入几个数字:利用率 45% 时约 1.8 倍,70% 时约 3.3 倍,85% 时约 6.7 倍,95% 时直接到 20 倍。
这意味着同一套系统:平峰期接口平均 150ms,当利用率被大促流量推到 85%,仅仅是排队,延迟就可能接近甚至突破 1 秒——代码一行没改,机器一台没坏。所以扩容多少台,不能按"流量翻倍就翻倍"来算,而要按水位目标来算:目标是大促峰值时核心链路利用率不超过 70%~75%,给突发留出缓冲。
做法上只有一条正路:全链路压测。按预估峰值的 1.2~1.5 倍施压,记录每一步的吞吐拐点——即吞吐不再上升、延迟开始陡增的那个点,它就是系统的真实容量。应用性能监控里的事务与吞吐数据,可以帮你在压测时直接看到这个拐点发生在哪一层;Google SRE 把延迟、流量、错误、饱和度列为四个黄金信号,其中"饱和度"看的正是这个水位。
二、平时无感的慢接口,大促时会被排队放大
第二道防线处理的是"平均值陷阱"。一个接口 99 次请求 100ms、1 次请求 10 秒,平均响应时间只有 200ms,报表上一切正常;但那 1 次慢请求的用户,感受到的是超时。平峰期它只是一次投诉,大促期它的杀伤力会翻倍:慢请求占住应用线程和数据库连接的时间越长,后面排队的正常请求越多,这就是队头阻塞——少数长尾请求可以把整条链路的体验拖垮。
所以大促前两周,应该做一次长尾盘点:把 事务监控里的慢事务按 P95 排序,取 TOP10 逐个过——是缺索引、是外部调用没设超时、还是串行调用了三次本可并行的下游。这一步的产出不是优化完,而是"知道哪几个接口最危险",必要时提前给它们限流或降级。
判断标准也要换掉:验收和盯盘都用 P95 / P99,不要用平均值。平均值会被大量快请求稀释,而用户流失和超时投诉,几乎全部来自长尾那一部分。
三、最先打满的往往不是应用,是数据库
第三道防线在数据库。大促流量打过来,应用层可以横向加机器,数据库却往往还是那一套实例。最先触顶的通常不是 CPU,也不是 IO,而是连接池:应用实例数 × 每实例连接数一旦超过数据库的最大承受能力,多余的请求就在池外排队——表现为应用侧 CPU 空闲、响应时间却畸高,数据库侧活跃连接数死死顶在池上限。
连接池之后是慢 SQL。平峰期一条缺索引的查询 200ms,无伤大雅;大促并发把它同时跑上几十路,磁盘 IO 打满,这条查询变成 2 秒,占住的连接又让其他查询排队——慢 SQL、池排队、锁等待三件事互相放大,就是典型的大促雪崩路径。热点行的锁冲突(比如秒杀库存扣减)也属于这一类。
动作有三件,顺序不能乱:先治慢 SQL,再动连接池,最后才谈数据库扩容。在 数据库性能监控里拉慢 SQL 排行与执行计划,把 TOP 逐条加索引或改写;连接池大小按数据库容量反推,而不是沿用应用侧的默认值;秒杀类热点做应用层缓存或异步削峰,别让所有压力都落在同一行记录上。
四、预案要能一键执行,不是一份文档
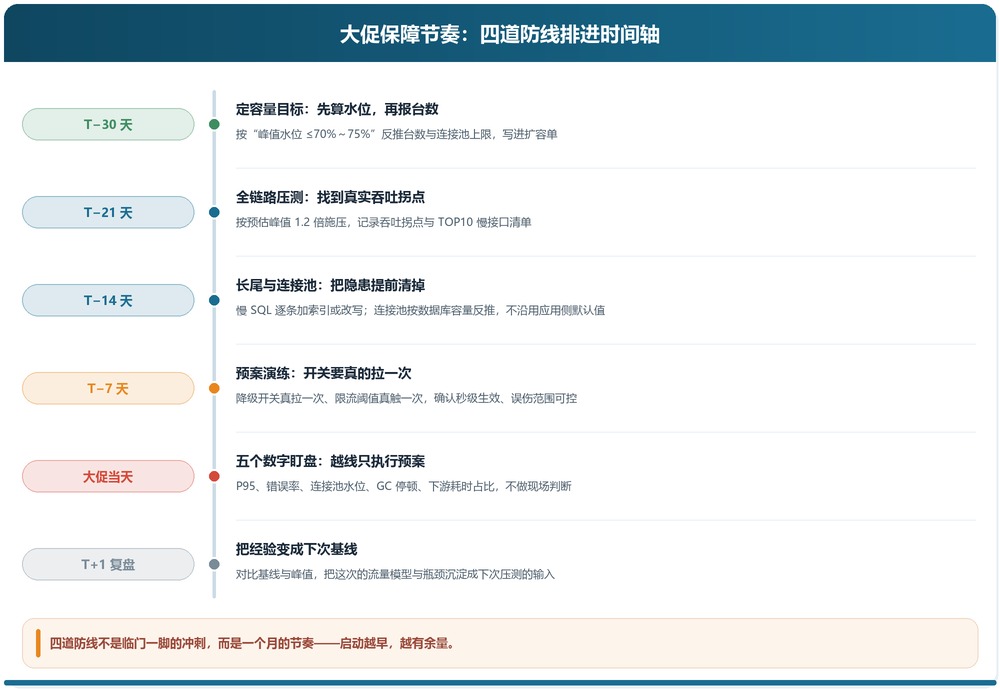
第四道防线是预案。大促当天的故障响应以分钟计,来不及翻文档开会,预案必须做成开关:入口限流的阈值、非核心功能的降级开关、下游调用的熔断策略,都要能在值班室里一键执行。
三类开关的设计要点:超时——所有跨服务调用必须设超时,且超时值要小于上游的忍耐上限,不让下游的慢拖死上游的线程;重试——必须带指数退避和抖动,否则瞬时抖动会被同步重试放大成流量洪峰;降级——按业务优先级排好名单,砍推荐、砍评论,永远先于砍下单。AWS 在其 Builders' Library 里对超时、重试与退避抖动有一篇经典实践总结,值得在定预案前通读一遍。
最后是演练:在预发环境把降级开关真的拉一次、把限流阈值真的触一次,确认开关生效时间在秒级、误伤范围和预期一致。没有演练过的预案,上线当天第一次执行,大概率不工作。
五、大促当天盯什么:五个数字,一张表
前四道防线都做完之后,当天的任务就收敛成盯盘。数字不需要多,五个就够;每个数字的"预警线"应该在压测时就已经确定,而不是当天现场拍。对照如下:
| 盯盘指标 | 平时基线(示例) | 预警线(示例) | 越线先查 |
|---|---|---|---|
| ① 响应时间 P95 | 核心接口 < 300ms | 基线 × 1.5 持续 5 分钟 | 慢请求集中在哪个接口 |
| ② 错误率 | < 0.1% | > 1% 持续 5 分钟 | 是限流降级生效,还是真实故障 |
| ③ 连接池水位 | < 70% | > 85% | 慢 SQL 与锁等待 |
| ④ GC 停顿 | 单次 < 200ms | 单次 > 1 秒 | 堆配置与当前流量是否匹配 |
| ⑤ 下游耗时占比 | < 40% | > 60% | 哪个下游该先降级 |
还有一个视角容易被忽略:技术指标全绿,用户却在吐槽。这时要看 真实用户监控——从真实用户的浏览器视角确认各地域、各运营商的实际加载体验,判断问题是全局性的还是局部性的,这决定当天是回滚还是扩容。
这套盯盘能力不需要在大促当天临时搭:Applications Manager覆盖应用、数据库、JVM 与真实用户视角,压测时用它定基线和预警线,当天用同一套看板执行——口径一致,判断才不会乱。
参考来源
1. Google《Site Reliability Engineering》Monitoring Distributed Systems 一章:延迟、流量、错误、饱和度四个黄金信号,以及水位与饱和度监控的方法论。
2. Google《Site Reliability Workbook》Alerting on SLOs 一章:如何基于服务目标设计告警阈值与多窗口燃烧率,避免告警疲劳——大促盯盘的预警线设计可直接参考。
3. AWS Builders' Library《Timeouts, retries, and backoff with jitter》:跨服务调用超时设置、指数退避与抖动的经典实践,是预案中"超时与重试"设计的权威参考。
说明:文中延迟与利用率数字为示意值,用于说明比例关系;实际基线与预警线请以自身压测与监控数据为准。
一句话总结:大促保障 = 提前把系统推到目标水位看一遍(压测)+ 治理长尾与连接池(数据)+ 能一键执行的预案(开关)+ 五个数字盯盘(口径)——四道防线做完,当天大多数故障都有预案可依。
延伸阅读
想把四道防线一次配齐?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 大促前容量压测怎么做才有效?
答:有效压测的三个要素:一是按预估峰值的 1.2~1.5 倍施压,而不是刚好打到峰值;二是全链路,只压入口网关而数据库、缓存、下游都是真实环境,拐点才可信;三是记录吞吐拐点——吞吐不再上升、延迟开始陡增的那个点就是真实容量,扩容目标据此反推(峰值水位不超过 70%~75%)。
- 压测全部通过了,为什么大促当天还是出问题?
答:常见原因有三:压测流量模型与真实流量分布不一致(真实用户的长尾接口占比更高);压测时长太短,连接泄漏、缓存击穿、Full GC 这类需要时间积累的问题没有暴露;预案没有演练,当天降级开关第一次真拉闸时不生效。压测通过只是必要条件,不是充分条件。
- 数据库连接池到底该设多大?
答:不是越大越好。上限由数据库侧决定:单实例能承受的活跃连接数有限,总连接 = 应用实例数 × 每实例池大小,必须留出管理连接和突发余量。经验起点是每实例几十个,再结合压测观察池等待时间与数据库活跃连接数调整。池打大的代价是数据库排队更多,整体反而更慢。
- 大促当天应该盯哪几个指标?
答:五个就够:核心接口响应时间 P95、错误率、数据库连接池水位、GC 停顿、下游调用耗时占比。每个指标配一条压测时确定的预警线和越线动作。指标贵精不贵多——盯二十个数字的团队,反应一定慢于盯五个数字但每个都有预案的团队。
- 小团队没有条件做全链路压测怎么办?
答:降级方案是"读侧压测 + 写侧限流":对读多写少的业务,用回放真实访问日志做读压测,风险可控;对下单、支付等写路径,与其压测不如直接上入口限流,把峰值挡在队列里削峰;同时把降级开关做扎实,确保极端情况下能保住核心链路。
