
慢依赖被误判成“死亡”:微软宕机给应用性能监控的三个教训

AI 摘要
微软 11 月 17 日公布的 M365 宕机调查报告,表面是网关缺陷与流量切换,内核却是一次典型的健康检查误判:服务器在特定负载下“被压垮并失去响应”,但按“存活”口径判断仍然是在线的,于是自动化容灾把流量转给同样“看似健康”的实例,形成连锁压死;恢复期的实例又被积压流量打回宕机,缺陷部署三个月无法回滚,全程近 24 小时。本文从应用性能监控视角拆解三个误判——把“存活”当“健康”、把“重启”当“恢复”、把“无错误”当“没问题”——并用 liveness/readiness 探针拆分、慢依赖下钻、渐进放量三个动作给出可落地的解法。
答案先说:微软这次宕机里,最值得应用运维抄下来的一句是“服务器失去响应,但按存活口径仍在线”。自动化容灾据此把流量转移到“看似健康”的实例,结果把负载转给了同样带缺陷的目标;恢复上线的实例又被积压流量打回宕机。整条事故链里,健康检查每一次都说“没问题”,每一次都恰好错在把存活当成了健康。
11 月 17 日的调查报告给出了完整时间线:缺陷源于 2026 年 7 月的一次网关更新,在低配测试环境从未触发;11 月 11 日晚一次自动流量切换把 Teams 流量转入已承载 Outlook 的主网关;此时又有近 14% 的容量因另一问题停用。三因叠加,两小时内超过 80% 的网关服务器停止响应。
比“为什么会挂”更值得问的是“为什么健康检查没提前发现”。下面从应用性能监控的视角,把这次事故翻成三个可自查的误判,并给出对应的三个动作。
核心要点
- 存活 ≠ 健康:进程还在、端口还通,不等于还能扛住下一波流量——这是微软事故里最贵的误判。
- 重启 ≠ 恢复:重启清掉了现场却没清掉缺陷,实例回来后被同样的流量再压死,形成恢复循环。
- 无错误 ≠ 没问题:错误率还是零的时候,延迟 P95 可能已经爬坡——慢依赖是“灰色故障”的典型形态。
- 健康检查要分层:liveness 判“要不要重启”,readiness 判“能不能接流量”,startup 判“是否初始化完成”。
- 恢复期要渐进放量:预热、限流、分批——把“上线即打回”的循环,换成可观测的阶梯。

一、把“存活”当“健康”:一次误判怎么变成连锁压死
调查报告里的关键措辞是:网关缺陷在特定负载下引发锁竞争与资源耗尽,服务器“被压垮并失去响应”。注意——不是进程崩溃、不是端口关闭,而是在负载触顶时停止服务。按最常见的存活探针口径(进程在、端口通)看,这些服务器全程“在线”。(腾讯新闻 · 2026-11-17 报道)
于是链条这样展开:流量切换把更多请求压到主网关,14% 的容量折损又减少了可用余量,请求开始堆积、响应时间爬升;自动化容灾按“健康”判断,把流量转给同样“在线”的服务器,而后者带着同样的缺陷与更少的余量,随即被压垮。在应用性能监控的口径里,这段过程本该有明确的中间态:服务可用性仍是绿的,但延迟 P95、排队长度、线程池占用率已经在恶化——这个“还活着但已经不健康”的窗口,正是唯一的干预点。健康从来不是“通/不通”的二值判断,而是一条会随时间偏离基线的曲线;把这条曲线画出来,容灾才有得选——是摘流量、是扩容,还是确实该重启。
二、三个误判:错误率没涨,不等于服务没问题
把事故里的处置动作逐条对到日常运维习惯,误判集中在三处:
| 事故中的处置 | 背后的判断 | 为什么错 |
|---|---|---|
| 容灾把流量转给“看似健康”的实例 | 存活探针通过 = 可以接流量 | 存活只回答“要不要重启”,不回答“还能扛多少负载”——转过去的实例带同样缺陷,被二次压死 |
| 恢复上线的实例很快再次宕机 | 重启 = 恢复,实例起来就能用 | 积压请求加客户端重试形成洪水,刚启动的实例没有预热就被打满,陷入恢复循环 |
| 故障确认花了约 15 小时 | 错误率没涨 = 没有故障 | 请求在排队、延迟在爬坡、线程池在耗尽,但响应最终仍返回——“无错误”掩盖了慢依赖 |
三行指向同一个盲区:可用性指标是二值的,健康却是连续的。一个服务可以在“可用”的同时,处于“正在变慢”“马上要挂”的中间态。只盯二值指标,等于只在事故已经发生后才看见它。
三、三个动作:让健康检查说出真话
动作一,把存活与就绪拆开。按 Kubernetes 官方探针的口径:liveness 失败才重启,readiness 失败只是摘掉流量,startup 探针负责保护慢启动应用。微软这类“失去响应但未崩溃”的场景,正确的动作是先摘流量而不是重启——把请求从带病实例上挪开,同时保留现场供分析。
动作二,给慢依赖单独下钻。错误率为零的时候,把延迟 P95、慢 SQL、外部调用耗时、线程池排队长度做成独立视图;一旦 P95 偏离基线,就沿着依赖拓扑往下游追,看是数据库锁等待、第三方接口变慢,还是自身线程池耗尽。慢依赖的定位靠分层下钻,不靠重启碰运气。
动作三,恢复期渐进放量。实例通过 readiness 之后先接小比例流量,预热缓存和连接池,再按延迟与错误率逐步放量;同时给客户端重试加退避与熔断,避免积压请求在恢复瞬间形成二次洪水。把“上线即打回”的循环,换成一条可观测的阶梯。
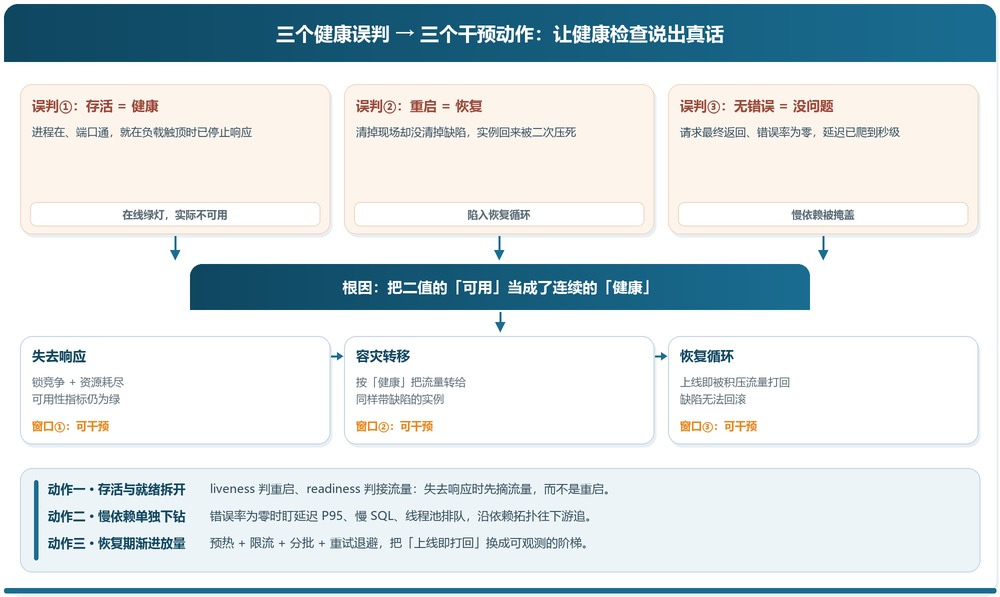
三个动作的共同点,是把“健康”从一个二值开关,还原成一条可以观察的连续曲线。微软这次的教训不在网关本身,而在于:当系统说“它还活着”的时候,你得有能力追问一句——它还能扛多久?。
参考来源
1. Kubernetes 官方文档《配置 Liveness、Readiness 和 Startup 探针》:本文“存活 ≠ 健康”“liveness 判重启、readiness 判接流量”的口径依据。
2. 腾讯新闻《微软全球服务宕机调查:一个潜伏四个月的漏洞,15 小时才发现问题所在》(2026-11-17):本文事故时间线与数据(80% 网关无响应、14% 容量停用、近 24 小时恢复)的来源。
一句话总结:微软宕机最值得抄走的一课是——“还活着”不等于“还健康”;把存活与就绪拆开、给慢依赖单独下钻、恢复期渐进放量,才能让健康检查在连锁压死发生之前说出真话。
延伸阅读
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 存活探针和健康检查到底有什么区别?
答:存活(liveness)只回答“进程要不要重启”,失败就重启;就绪(readiness)回答“能不能接收流量”,失败只是把实例从负载均衡里摘掉。微软这次“失去响应但仍在线”的场景,正确动作是摘流量而非重启——重启既清掉现场,又没清掉缺陷。
- 慢依赖为什么很难被发现?
答:因为它不产生错误:请求最终会返回,错误率仍是零,但响应时间已经从毫秒爬到秒级。线程在排队、连接在耗尽、下游锁在等待——这些变化不会体现在可用性面板上,只有把延迟分位数与依赖耗时单独拉出来,才能看见。
- 实例恢复后为什么又被打挂?
答:两个原因叠加:一是宕机期间积压的请求在恢复瞬间集中涌入;二是客户端重试没有退避,形成二次洪水。解法是恢复期渐进放量——先接小流量预热缓存与连接池,再按延迟与错误率阶梯放量,同时给重试加退避与熔断。
- “无错误率”能说明服务健康吗?
答:不能。错误率是二值结果,健康是连续状态。SRE 四大黄金信号里,延迟和饱和度往往比错误率更早报警——微软事故中约 15 小时才确认全面故障,正是因为前面很长一段时间里请求都“还能返回”。
- 健康检查间隔设多少合适?
答:没有通用值,原则是“检测窗口要短于故障恶化窗口”。高频检查(秒级)能更早发现慢依赖,但要配合失败阈值与冷却时间,避免网络抖动导致误摘流量。关键是让 liveness、readiness、startup 三类探针各司其职,而不是用一个心跳检查包打天下。
