
数据库监控和 APM 怎么分工?从慢 SQL 到调用链的三个衔接点

AI 摘要
AI 摘要:接口慢的时候,APM 的调用链和数据库监控的慢 SQL 往往各说各话:一边说「数据库段占了 70% 耗时」,一边说「没有超过 100 毫秒的慢查询」。其实两边都没错,缺的是把两边数据接起来的三个衔接点:用「调用次数 × 单次耗时」判断慢 SQL 值不值得先修、区分等待发生在连接池还是数据库执行、让数据库与接口用同一分位对齐。文末附一张三步分流表:接口慢,先看哪里,看到了什么归谁管。
答案先说:数据库监控和 APM 的分工是——APM 回答「哪个接口慢、时间花在了哪一层」,数据库监控回答「数据库本身健康吗、SQL 为什么慢」。两者单看都不难,难的是衔接:接口慢了,先看调用链还是先看库?大多数争论的根源,是两边数据没有对齐到同一个口径上。
这篇用三个衔接点把两边接起来:一是用「调用次数 × 单次耗时」判断慢 SQL 值不值得先修;二是分清等待发生在连接池还是数据库执行,避免拿着慢 SQL 日志找池子的错;三是让数据库与接口用同一分位对齐,别拿均值去解释 p99 的问题。最后给一张三步分流表,接口慢的时候照着走。
ManageEngine Applications Manager在这套分工里的位置,是把调用链里的数据库段与数据库自身的指标放在同一张时间线上:调用链负责拆耗时,数据库监控负责回答 SQL 与实例层的问题,两个视图互为入口。
核心要点
- APM 与数据库监控的分工:APM 管「哪一层慢」,数据库监控管「数据库为什么慢」,三个衔接点负责把两边的结论对齐。
- 衔接点一:慢 SQL 按「调用次数 × 单次耗时」排序,单条不慢但调用 40 次的 SQL 才是接口慢的大头。
- 衔接点二:等待发生在连接池还是数据库执行,归属完全不同——连接等待高先查池配置,而不是翻慢查询日志。
- 衔接点三:数据库与接口必须用同一分位、同一时间窗对齐,均值会掩盖 p99 那一次真实的慢。

同一笔慢请求,两边看到的不是一回事
先看一个常见的对不上:接口 p99 到了 800 毫秒,调用链里数据库段占 70%;但数据库那边的慢查询日志里,找不到一条超过 100 毫秒的 SQL。应用团队说「数据库有问题」,数据库团队说「库没问题」——两边都没说错,错的是拿两套口径在对话。
APM(应用性能监控)的调用链视角,是把一笔请求拆成一段段的 span:应用执行了多少、数据库执行了多少、外部调用等待了多少。它回答的是「时间花在了哪一层」。数据库监控的视角,是从数据库这一侧看进来:SQL 的执行明细、锁等待、缓存命中、连接数变化。它回答的是「数据库本身健康吗」。两个视角天然对不上的地方,恰恰就是三个衔接点要补的位置。
衔接点一 · 用「次数 × 耗时」判断慢 SQL 值不值得先修
数据库团队通常按「单条 SQL 的执行时长」排优先级:一条 80 毫秒的查询,怎么也排不进优化清单。但接口视角是乘法:这条 SQL 在一次请求里被循环调用了 40 次,光它就吃掉 3 秒多。这就是典型的 N+1 查询——单看不慢,累加致命。
所以排序口径应该是「调用次数 × 单次平均耗时」,取乘积最大的那批先修。调用次数只能从调用链里来——它知道这条 SQL 是被哪个接口、哪次请求发起的;单次耗时与执行明细要从数据库侧来。两边各拿一半,乘起来才算数。
落到工具上:mysql监控工具这类页面里的慢查询明细,负责给出单条 SQL 的执行画像;调用链负责回答「它被调了多少次」。只优化单条 SQL 的写法而不砍调用次数,是这类问题最常见的半截工程。
衔接点二 · 等待在连接池还是数据库执行,归属不同
第二种对不上更冤枉:接口慢,数据库执行明细里也没有慢 SQL,两边互相甩锅了一下午。真正的答案常在中间层——等待发生在「获取连接」这一步,而不是「执行 SQL」这一步。连接池被占满,请求在池子外面排队,排队时间全被记进了数据库段的耗时里。
区分办法是看两个位置:数据库侧的执行时长如果不高,而应用侧「获取连接的等待时长」很高,问题归连接池——池太小、连接泄漏、或慢事务长期占着连接不放。反过来,如果连接很快拿到、SQL 执行本身慢,才轮到数据库监控接手。
先看池还是先看库,决定了排障方向。方向错了,数据库团队会把慢查询日志翻个底朝天,而问题根本不在那里。这也是 apm系统 和数据库监控最日常的一次配合:池的指标在应用侧,执行的事实在数据库侧,两边一对,归属立判。
衔接点三 · 分位对齐:别拿均值去解释 p99
第三种对不上出在统计口径上。接口侧报 p99 是 800 毫秒,数据库侧报平均耗时 30 毫秒,看起来矛盾,其实不矛盾——p99 的那一次请求,可能撞上了一条两秒的慢 SQL,只是它被其余 99 次快速请求平均掉了。均值抹平的,恰好是最值得看的尾部。
对齐的办法是三同:同分位、同时间窗、同来源。数据库的 SQL 耗时也按 p95/p99 统计,和接口取同一个时间窗,再过滤掉批处理与后台任务这类「不该算进用户请求」的调用。这样接口 p99 慢的时候,能直接看到数据库侧对应的 p99 SQL 是哪一条。
口径统一之后,应用性能监控体系里的接口指标与数据库指标才能互相引用:接口变慢的点,和数据库变慢的点,在时间轴上是同一个点。这也是评估任何一套apm系统时最值得现场演示的一项。
三步分流表:接口慢,先看哪里,归谁管
把三个衔接点合成一张分流表,接口慢的时候按顺序走:先拆耗时定层,再看明细定 SQL,最后查池子定归属。每一步都有明确的「看到了什么就停」,避免两边团队同时空转。
| 步骤 | 先看哪里 | 看到了什么,归谁管 |
|---|---|---|
| ① 拆耗时 | APM 调用链:接口耗时的分层分解(应用 / 数据库 / 外部调用) | 数据库段占比低 → 归应用层:代码逻辑、循环调用、外部接口等待 |
| ② 看明细 | 数据库监控:SQL 执行明细与耗时排序(按次数 × 耗时) | 存在慢 SQL 或高频 SQL → 归数据库:索引、执行计划、语句改写 |
| ③ 查池子 | 连接池与线程池指标:获取连接等待时长、活跃 / 空闲连接数 | 数据库执行正常但连接等待高 → 归中间层:池配置、连接泄漏 |
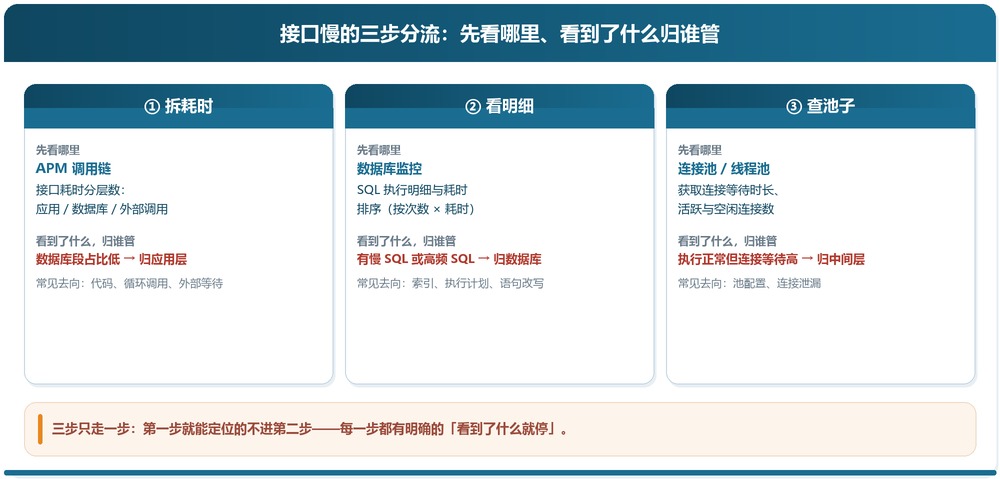
这张表的用法是「只走一步」。第一步就能定位的,不必进第二步——数据库段占比低就回应用层找原因,不要顺手把库也翻一遍;三步走完仍然说不清的,通常说明数据没接全:调用链里少了数据库段,或者数据库侧没有开启 SQL 级的统计视图。
分工的边界与延伸
最后划一下边界:APM 不负责回答「这条 SQL 为什么走全表扫描」,数据库监控也不负责回答「哪个接口在拖累整体体验」。前者要看执行计划,后者要看服务级的流量与依赖——把边界讲清楚,两个团队的告警才不会互相打扰。
接口变慢的完整分层定位方法,接口突然变慢怎么排查?应用性能问题的分层定位法那篇已经写过,可以和本文的三步分流表衔接着用;缓存层的问题同样遵循「池子与库分开看」的思路,Redis监控看什么:缓存命中率、内存碎片率这些指标怎么用里对命中率与内存碎片的取舍讲得更细。
参考来源
1. OpenTelemetry 数据库语义约定(调用链中数据库 span 的标准属性与口径,是「调用链」与「数据库监控」两边数据能对齐的基础)
2. PostgreSQL pg_stat_statements(数据库侧 SQL 执行统计的标准视图,按执行次数与总耗时排序正是「次数 × 耗时」口径的官方实现)
说明:文中三个衔接点为通用实践归纳,请结合自身数据库类型与调用链实现调整;产品能力以官方页面为准。
一句话总结:数据库监控管「数据库为什么慢」,APM 管「哪一层慢」,中间靠三个衔接点对齐:慢 SQL 按次数乘耗时排序、等待先分清连接池还是执行、数据库与接口用同一分位对齐——口径对上了,接口慢的争论才会变成分工。
延伸阅读
想把这三步分流用到你的环境里?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 接口慢怎么判断是不是数据库问题?
答:按三步分流走:先在调用链里拆耗时,看数据库段占比;占比高再看数据库侧的 SQL 明细;占比低就回应用层找原因。只有「数据库执行慢」这一种情况才归数据库,连接池排队和代码逻辑造成的慢,翻慢查询日志是找不到答案的。
- 连接池和线程池哪个先看?
答:看等待发生在哪一段。如果「获取连接的等待时长」高而数据库执行时长正常,先看连接池——池大小配置、连接泄漏、长事务占连接都是常见原因;如果连接很快拿到但执行慢,才轮到数据库监控接手。顺序反了会白查一晚上。
- 慢 SQL 优化了,接口还是慢,是什么原因?
答:三个方向:一是调用次数没降,N+1 查询优化了单条语句但次数还是 40 次,乘积没变;二是瓶颈转移,数据库段降下来后外部调用或锁竞争成了大头;三是口径没对齐,你优化的是均值,用户感知的是 p99。优化前后都用「次数 × 耗时」和分位数复核。
- 需要在数据库里装监控 agent 吗?
答:多数场景不必。无论用哪种 mysql监控工具,数据库侧都优先用自带的性能统计视图(如 PostgreSQL 的 pg_stat_statements、MySQL 的 performance_schema),它们给出 SQL 级的执行统计且对实例几乎无侵入;应用侧由调用链补上「谁在调用、调了多少次」。只有在需要会话级、锁级的深度诊断时才考虑 agent。
- 「分位对齐」具体要设什么参数?
答:三个参数:同分位(接口和数据库都取 p95 或 p99,不要一边均值一边分位)、同时间窗(对比必须在同一时间段内做)、同来源(过滤掉批处理、后台任务等不来自用户请求的调用)。设好之后,接口 p99 的时间点就能和数据库 p99 SQL 一一对应。
