
应用告警太多修不过来?从「告警」到「工单」的闭环改造

AI 摘要
应用告警太多修不过来大多不是告警本身有误,而是缺少业务流程闭环。本文介绍告警工单闭环四步法:分级、派单、跟踪、复盘,给出各环节验收口径与卡点,结合Gartner事件智能、AI SRE实测,说明APM告警天然的业务归属优势,实现告警从“被看见”到可追溯工单流转。
答案先说:应用告警太多修不过来,通常不是告警本身错了,而是告警没有接上流程。一个应用监控系统每天产生几百条告警并不可怕,可怕的是这些告警一直停留在“被看到”的阶段,没有变成工单、没有负责人、也没有关闭记录。
Gartner 在 2026 年把 AIOps 平台重新定位为“事件智能解决方案”,核心变化在于不再只看“接了多少数据源”,而是看“能不能把事件处理接进 ITSM / CMDB”。另一边,Palo Alto Networks 发布的 Cortex XCOR 展示了 AI SRE 智能体的实测数据:告警触发后自动启动专用 agent 推理根因并建议处置动作,复杂生产环境根因成功率 75%,另有 19% 被认为“有用”;而人工定位平均需要 20 分钟。
ManageEngine Applications Manager在这类场景里的位置,不是替代人去分级,而是把“谁该处理、处理到哪一步、有没有关闭”变成可追溯的数据流。
关键要点
告警太多通常不是误报率高,而是没人认领,核心问题在流程,不在监控数据本身。
告警工单闭环四步:分级 → 派单 → 跟踪 → 复盘,每一步都需要配置可验收的执行口径。
APM告警自带业务归属属性,对比网络告警,更容易直接派给对应业务负责人,是APM独有的优势。
事件智能的核心不是堆砌工具,而是实现告警在数据源、CMDB、ITSM之间自动流转,减少人工转发操作。
禁止将告警关闭率作为唯一KPI,重点关注同一根因问题复发率、告警派单后首次响应耗时。

告警太多,问题到底出在哪
告警太多通常被第一反应为“阈值太松”或“采样太密”,但大多数时候数据侧并不是瓶颈。真正的瓶颈在流程侧:告警产生了,却没有对应的处理动作、没有负责人、没有关闭记录。久而久之,运维团队对告警产生免疫,真正严重的信号反而被淹没。
apm系统要解决的第一步,是把“谁负责处理这条告警”变成默认值,而不是每次现问。这听起来是流程问题,实际上取决于监控工具能不能把告警对象与业务负责人、应用拓扑、值班表关联起来。这也是为什么 Gartner 2026 重新定位 AIOps 时,不再孤立地评价“接了多少数据源”,而是评价“能不能把事件处理接进 ITSM / CMDB”。这正是 apm系统真正区别于单纯监控工具的地方。
为什么 APM 告警比网络告警更容易接上工单
应用告警有一个天然优势:它自带业务归属。一条“订单服务响应时间 > 2 秒”的告警,几乎不需要额外翻译,业务负责人就知道影响的是什么。对已经部署应用监控系统的团队来说,这个优势在派单环节尤其明显。而网络告警往往需要先做一轮“这是哪台设备、跑在哪个业务链路上”的转换,才能派到正确的人。
这个优势让应用监控在“派单”这一步上比网络监控更容易落地。如果监控工具同时还能提供调用链、依赖拓扑与慢 SQL 定位,派单时就能附带上下文:不是只告诉 owner“你的服务慢了”,而是告诉他“订单接口在第 3 层调用链的支付网关环节慢了,对应的数据库连接池利用率也在同一时间飙升”。这种上下文直接把“看看”变成“该看谁”。
告警工单闭环四步:分级、派单、跟踪、复盘
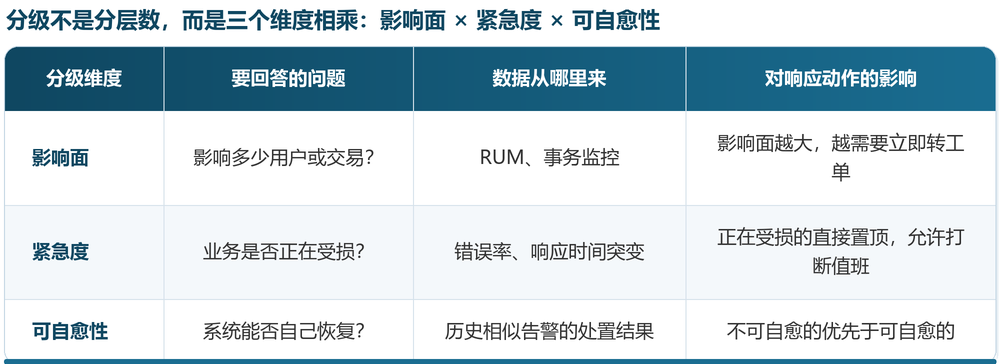
把流程拆成四步,每一步都给一个可验收的口径,闭环才不会变成口号。下面这张表把四步落在具体动作上,便于应用监控团队对照现状查漏补缺。
| 闭环步骤 | 做什么 | 验收口径 | 常见卡点 |
|---|---|---|---|
| 分级 | 按影响面 × 紧急度 × 可自愈性排序 | 每条告警都有明确的严重度标签 | 只按阈值分级,不看业务影响 |
| 派单 | 把告警直接路由到业务或技术 owner | 从告警到责任人的分钟数可统计 | 只发给值班群,没人具体认领 |
| 跟踪 | 记录处置动作、中间状态与阻塞原因 | 每个严重告警都有更新时间线 | 开了工单再无更新,最后自动关闭 |
| 复盘 | 对反复出现的告警做根因收敛 | 同一问题复发率下降,而不是告警数下降 | 把“关闭率”当 KPI,不追问根因 |
分级到几层才够
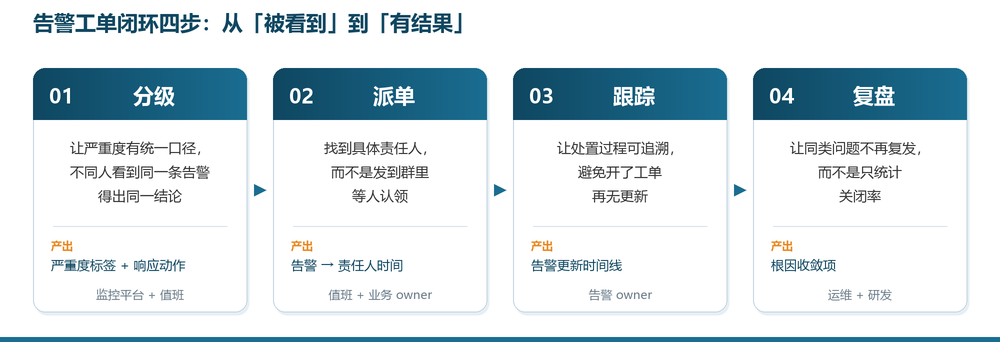
很多企业把分级做成“致命 / 严重 / 警告 / 提示”四层,但层数不是越多越好。真正有效的是分级维度,而不是分级数量。建议至少包含三个维度:影响面(影响多少用户或交易)、紧急度(业务是否正在受损)、可自愈性(系统能否自己恢复)。这三个维度的输入,只有在完整的 apm系统中才能被同时看见。
例如,一条影响面小但不可自愈的告警,优先级应当高于影响面大但会自动恢复的告警。应用性能监控的价值就在于它能同时提供这三个维度的输入:业务影响来自 RUM 或事务监控,紧急度来自错误率或响应时间突变,可自愈性来自历史相似告警的处置结果。
分级完成后,必须绑定不同的响应动作:最高两级直接转工单并短信通知;中间两级进工单但允许异步处理;最低两级只记录不打扰。没有动作绑定的分级,只是数字游戏。
派单之后没人认领怎么办
这是闭环里最容易掉的环节。派单不是把告警发到群里,而是指定到具体责任人,并设置升级路径。一个最小可行的升级规则是:5 分钟内无响应则升级到直属 leader,15 分钟内无响应则升级到值班经理,同时把告警广播到团队频道作为兜底。
另一个关键动作是把根本原因分析纳入闭环。很多反复出现的告警并不是新问题,而是老问题的症状换了表现形式。如果复盘只关注“告警关了没有”,而不追问“为什么又出现”,同一类告警会无限循环。好的复盘应当产出可落地的收敛项:修复代码缺陷、调整阈值、补充自动化恢复,或承认当前不可修复并加入长期观察清单。
最后还要注意:不要把“告警关闭率”当成唯一 KPI。高关闭率可能意味着大家在批量点关闭,而不是在解决问题。更健康的指标是同一根因的复发率,以及从告警派单到责任人首次响应的分钟数。如果工具本身具备根本原因分析能力,复盘时可以直接从告警跳转到调用链慢节点,显著降低排查成本。
与《告警风暴分级压缩五步法》的分工
9 月 20 日发布的《网络告警风暴怎么根治?分级压缩五步法从每天 300 条降到 10 条》讲的是一个方向:如何把告警数量压下来。它解决的是“入口太吵”。
本文讲的是另一个方向:数量压下来之后,如何让剩下的告警真正流转起来。对 apm系统来说,这条路径同样成立:先用分级压缩控制入口,再用闭环四步保证每一条留下的告警都有人认领、有结果、有复盘。
一句话总结:应用告警太多修不过来,核心问题通常不是告警不准,而是没有闭环;把分级、派单、跟踪、复盘四步串起来,并绑定验收口径与升级路径,告警风暴才能从“噪音”变成“可执行的工单流”。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 告警要分级到几层才够?
层数不是越多越好,关键是分级维度。建议至少包含影响面、紧急度、可自愈性三个维度,并为每一级绑定明确的响应动作。没有动作绑定的分级只是数字游戏。
- 派单之后没人认领怎么办?
指定具体责任人而不是发群消息,并设置升级路径。最小规则:5 分钟无响应升级到 leader,15 分钟无响应升级到值班经理,同时把告警广播到团队频道兜底。
- 怎么判断闭环真的跑起来了?
看两个指标:同一根因的复发率是否在下降,以及从告警派单到责任人首次响应的分钟数是否稳定。不要把告警关闭率当成唯一 KPI。
- 事件智能和 AIOps 是不是一回事?
不是。AIOps 更偏向用算法处理监控数据,事件智能则强调事件在监控、CMDB、ITSM 之间的流转与上下文。Gartner 2026 把 AIOps 平台重新定位为事件智能解决方案,正是因为后者的价值更容易被业务感知。
- 小团队值得上闭环吗?
值得,但可以简化。小团队的闭环重点不是多复杂的平台,而是三件事:谁负责、升级路径、以及每周花 15 分钟看复发告警。先把这三件事做扎实,再考虑自动化。
相关阅读
• 应用性能监控告警配置实战:从阈值设定到告警降噪的5个关键步骤
• SRE四大黄金信号是什么?Google运维方法的落地路径
