
网站监控怎么做?从可用性、响应时间到业务转化的四层清单

AI 摘要
「网站能打开」只回答了网站监控四分之一的问题。本文给出一套可直接落地的「网站监控四层清单」:第一层可用性(打不打得开),第二层响应时间(打开有多快),第三层事务(关键路径走不走得通),第四层业务转化(有没有带来钱)。每一层给出核心指标、参考阈值与采集方式,并附一张「断层诊断表」——四层状态怎么组合,就指向什么问题:第一二层全绿而第三层红,查业务逻辑与依赖;第一层红,先查网络、DNS 与证书。最后给一份 30 分钟就能跑起来的起步清单。
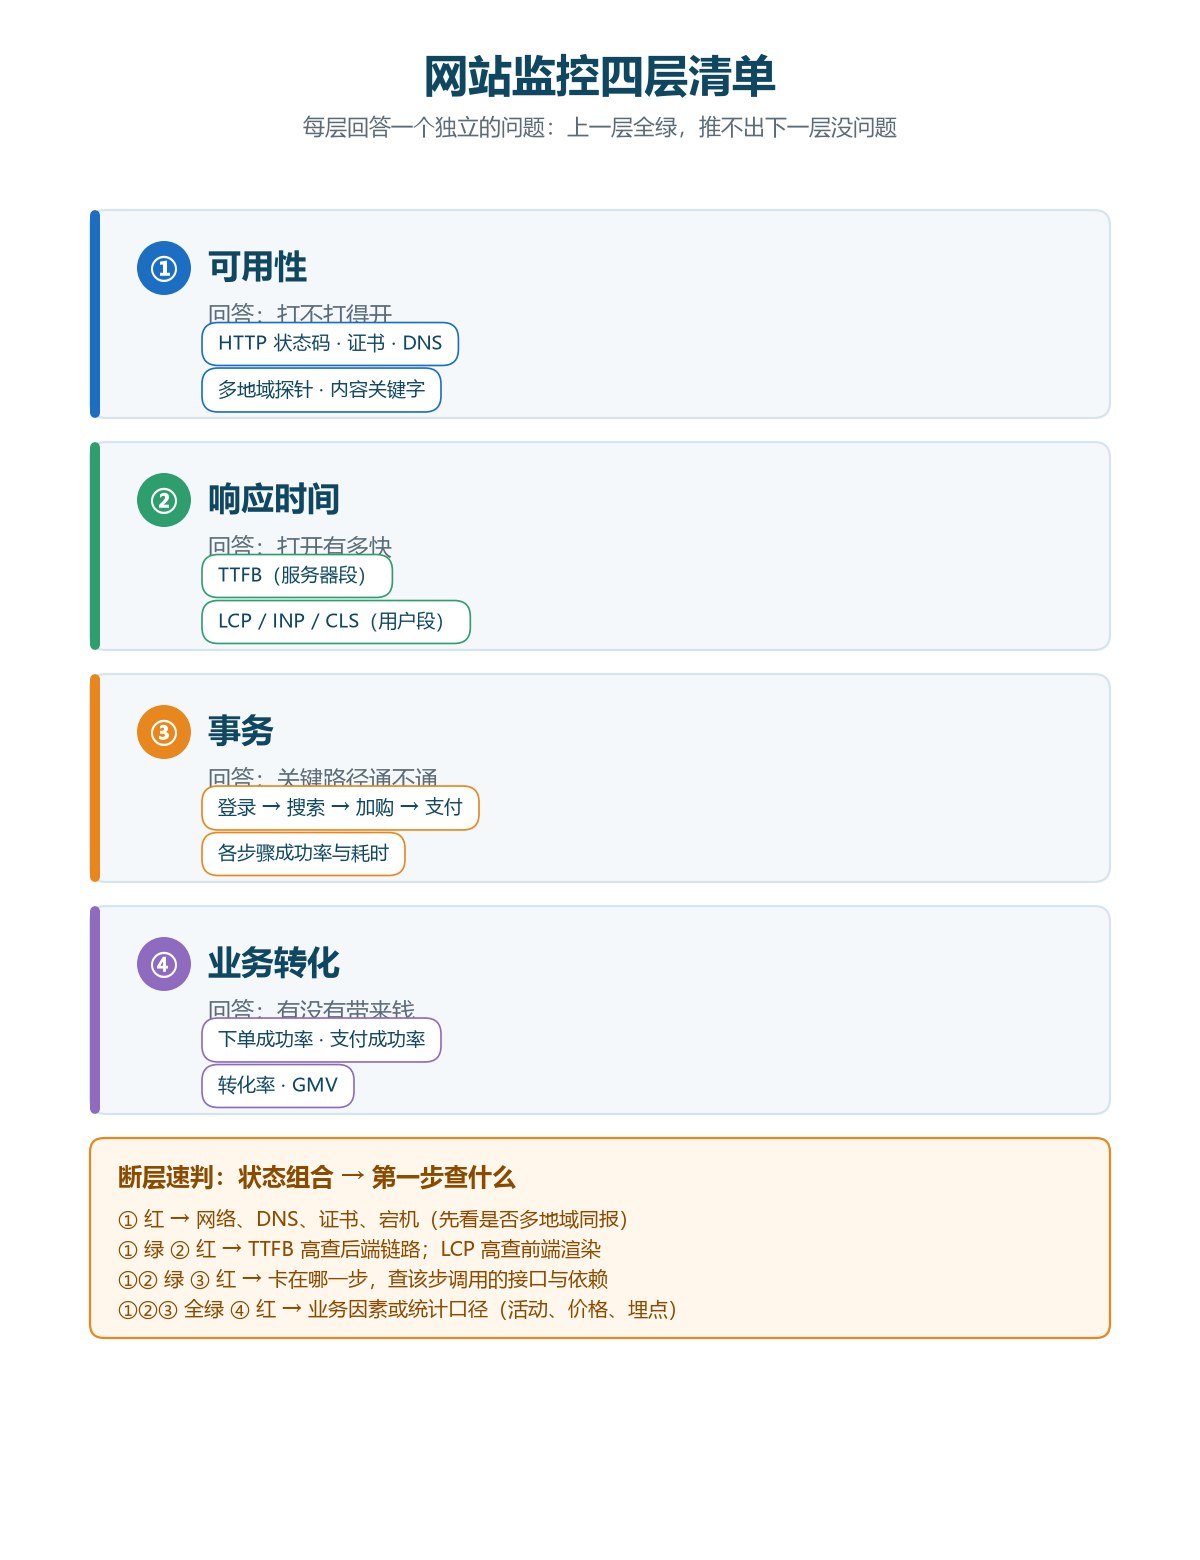
答案先说:网站监控要按四层来做,而不是一个「在线检测」打天下:第一层可用性——打不打得开;第二层响应时间——打开有多快;第三层事务——登录、搜索、下单这条关键路径走不走得通;第四层业务转化——访问有没有变成订单。四层各回答一个独立的问题,混在一层里,三种问题都答不好。
只做第一层的代价非常具体:页面 200 正常返回,但接口超时、按钮点了没反应、支付回调失败——监控全绿,客服爆炸。这类「技术可用、业务不可用」的故障,靠在线检测永远发现不了,因为它只验证了 HTTP 状态码,没有验证业务还在不在工作。
ManageEngine Applications Manager 在这套清单里的位置,是把四层放进同一个平台:多地域探针管第一层,页面与接口计时对到第二层,录制回放的关键业务脚本对到第三层,订单与转化数据对到第四层——四层在同一时间线上,故障才能从「有告警」走到「有结论」。
核心要点
- 「网站能打开」只是四层里的第一层:页面 200 不代表接口不超时、按钮有反应、支付能走通。
- 四层清单:可用性(打不打得开)→ 响应时间(有多快)→ 事务(关键路径通不通)→ 业务转化(有没有带来钱),各配独立指标与阈值。
- 响应时间至少看两段:服务器段的 TTFB 与用户段的渲染指标;满意度可用 Apdex 分档(T 取 0.5–1 秒)。
- 断层诊断是四层清单最有用的输出:一、二层全绿而三层红,查业务逻辑与依赖;一、二层红而三层没数据,先修网络、DNS 与证书。

为什么「能不能打开」不等于「网站监控」
很多团队的网站监控停在一个 URL 检测上:每分钟请求一次首页,200 就算健康。这套做法漏掉的恰恰是最贵的三类故障。第一类:静态资源全绿、动态接口全红——页面框架秒开,下单按钮转圈;第二类:本机全绿、外省全红——CDN 或运营商链路问题,自建探针永远看不见;第三类:页面全绿、业务全停——支付回调、库存接口、登录服务挂了,但首页照常返回。
三类故障的共同点是:它们发生在「打开」之后。四层清单就是把「打开之后」的事情补上,每一层对应一类必须在场的问题。
四层清单总览:每层回答一个独立问题
下表是四层的总览:层与层之间是「并且」关系,不是替代关系——上一层全绿,不能推出下一层没问题的结论。右列的参考阈值来自业界通用口径,落地时按业务容忍度调整。
| 层 | 回答什么 | 核心指标 | 参考阈值(通用口径) | 采集方式 |
|---|---|---|---|---|
| ① 可用性 | 打不打得开 | HTTP 状态码、证书有效期、DNS 解析、内容关键字 | 连续 2 次失败即告警;证书剩余 < 30 天关注 | 多地域探针定时请求 |
| ② 响应时间 | 打开有多快 | TTFB、首屏、LCP / INP / CLS | TTFB < 800ms;LCP ≤ 2.5s、INP ≤ 200ms、CLS ≤ 0.1 | 探针计时 + 真实用户侧采样 |
| ③ 事务 | 关键路径通不通 | 登录 / 搜索 / 加购 / 支付各步骤成功率与耗时 | 核心步骤成功率 ≥ 99.5%;单步耗时 < 3s | 脚本化回放(录制关键路径) |
| ④ 业务转化 | 有没有带来钱 | 下单成功率、支付成功率、转化率、GMV | 环比基线偏移 > 10% 即告警 | 业务系统数据接入或日志统计 |
第一层 可用性:打不打得开
可用性监控的要点是「别只盯一个点」。三个必须补齐的维度:
多地域——至少三个探针点,覆盖主要用户所在运营商与地域;单点探针会把区域性故障当成全站故障,也会把全站故障当成抖动。
内容校验——不只看状态码,还要校验返回内容里的关键字(价格、商品名、登录表单)。大量「200 但内容错误」的故障——被劫持、被风控页替换、后端渲染空壳——状态码完全正常。
证书与 DNS——证书到期和 DNS 配置错误是两类占比很高的「低级但致命」故障,都应在到期/变更前主动告警,而不是等用户截图。
判定口径上,建议「连续 2 次失败才告警」,探针间隔 1–5 分钟:单次失败大多是网络抖动,两次连续失败才值得把人叫起来。多数网站监控工具都内置多地域探针与内容校验,这两项配置一次、长期受益。
第二层 响应时间:打开有多快
响应时间至少拆成两段看。服务器段看 TTFB(首字节时间)——按 W3C Navigation Timing 的定义,它是请求发出到收到响应第一个字节的间隔,反映的是服务端处理与网络往返;TTFB 大,问题在服务端或链路,与前端无关。
用户段看渲染指标:业界通用参考值取 Google Core Web Vitals 口径——LCP(最大内容绘制)≤ 2.5 秒、INP(交互延迟)≤ 200 毫秒、CLS(累积布局偏移)≤ 0.1。这两段要分开归因:探针测出 TTFB 正常而 LCP 超 4 秒,问题在前端资源与渲染,不在后端。
满意度口径建议用 Apdex 分档:把 T 定在 0.5–1 秒,响应时间在 T 以内计满意、T 到 4T 计容忍、超过 4T 计失望——一条「Apdex 0.85」比一串平均响应时间更能说明「多少比例的用户是舒服的」。此外,探针测的是「实验室视角」,上量之后建议叠加 真实用户监控 看真实用户的分位值(P75/P95)——合成探针告诉你会不会慢,真实用户告诉你谁在慢。
第三层 事务:关键路径走不走得通
第三层是四层里投入产出比最高的一层,也是最常被跳过的一层。做法是把核心业务路径(打开首页 → 搜索商品 → 加入购物车 → 登录 → 提交订单 → 支付成功页)录制成脚本,按固定间隔回放,每一步断言两件事:这一步成功了吗、花了多久。
有了分步数据,故障描述会从「网站慢了」变成「支付步骤从 14:02 开始失败,前面步骤全部正常」——范围直接缩到一个接口。这是 Web事务监控 与单页监控最大的差别:它监控的不是页面,是业务动作本身。
落地建议:先覆盖交易主链路的 3–5 个关键事务,而不是追求脚本数量;每一步的超时阈值单独设置(支付类应比浏览类严格);脚本里带上测试账号,避免回放动作污染真实订单数据。
第四层 业务转化:有没有带来钱
前三层是技术视角,第四层是生意视角:下单成功率、支付成功率、转化率、GMV。它的价值不在「多一个大盘」,而在与前三层联动归因——转化率掉了 15%,四层清单让你能在一分钟内回答「是技术问题还是业务问题」:一、二、三层全绿,转化掉,查活动调整、竞品、价格这类业务因素;三层里任何一层红,技术问题先背锅,修完看转化回没回来。
接入方式不必一步到位:从支付网关与订单系统的成功率统计开始(日志或数据库口径都行),先有数、再拆维度(渠道、地域、终端),最后才考虑与监控平台的自动联动。
断层诊断:四层状态怎么组合,就指向什么问题
四层清单最有用的输出是「组合判断」。下表是常见组合与对应的排查方向:
| 状态组合 | 指向的问题 | 先查什么 |
|---|---|---|
| ① 红 | 网络、DNS、证书、服务器宕机 | 多地域探针是否同报;证书有效期;DNS 解析 |
| ① 绿 ② 红 | 服务端变慢或前端渲染劣化 | TTFB 与 LCP 分开看:TTFB 高查后端与链路,LCP 高查前端资源 |
| ① 绿 ② 绿 ③ 红 | 业务逻辑或下游依赖故障 | 失败发生在哪一步;该步骤调用的接口与依赖服务 |
| ①②③ 全绿 ④ 红 | 业务因素或统计口径变化 | 活动调整、价格变化、埋点与统计口径是否变更 |
| ④ 红 ①③ 无数据 | 监控自身故障 | 探针与脚本是否还在跑——先修监控,再看业务 |
这张表的本质是把「经验」固化成「决策树」:值班的人不需要理解全部架构,按组合对号入座,就能给出正确的第一步。
30 分钟起步:一页纸清单
四层不需要一次建全。下面是按优先级排列的起步动作,总投入约 30 分钟:
- 第 1–10 分钟(第一层):为核心 URL 配 3 个地域的探针,间隔 1 分钟,内容校验加一个关键字,连续 2 次失败告警。
- 第 11–18 分钟(第二层):对同一 URL 开启响应时间统计,设 TTFB 800ms、页面 3s 两条阈值线,先看一周基线再收紧。
- 第 19–26 分钟(第三层):录制最关键的一条事务(建议是「搜索 → 详情 → 加购」或「登录」),间隔 5 分钟回放。
- 第 27–30 分钟(第四层):把支付成功率做成每日报表先跑起来——今天先有数,联动告警下周再补。
工具上不必从零搭建:一款成熟的 网站监控工具 已经把这四层的采集、阈值与告警做成配置项——探针地域、内容校验、事务录制、报表口径都是勾选和录制的事。配完之后,检查标准只有一条:下一次故障,值班的人能不能在五分钟内说出「坏在哪一层」。
参考来源
1. W3C《Navigation Timing Level 2》:TTFB(responseStart)、页面加载各阶段的时间定义,本文第二层的指标口径以此为基准。
2. Apdex 规范:用户满意度分档方法(T / 4T 阈值与满意、容忍、失望三档定义),本文满意度口径引自该规范。
3. RFC 9110《HTTP Semantics》:状态码语义与鉴权流程定义,第一层内容校验与状态码判定依据。
一句话总结:网站监控做四层——可用性、响应时间、事务、业务转化,各配指标与阈值;故障时按「断层诊断表」对号入座,五分钟内说出坏在哪一层。
延伸阅读
想把四层清单用起来?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 网站监控和服务器监控有什么区别?需要两个都做吗?
答:两个都要,但对象不同:服务器监控看主机层(CPU、内存、磁盘、进程),回答「机器好不好」;网站监控看服务层(状态码、响应时间、事务、转化),回答「业务好不好」。机器全绿而业务全停是常见组合——比如应用进程活着但数据库连不上——所以两者必须互相补位,不能互相替代。
- 探针放在哪里合适?几个点才够?
答:至少覆盖主要用户所在的运营商与地域,通用起点是 3 个:北方、南方、海外各一(如有海外业务)。探针越分散,越能区分「区域性网络问题」与「全站故障」;只有一个探针时,这两种故障无法区分。
- LCP、INP、CLS 这些指标看不懂,能不能只看平均响应时间?
答:平均响应时间会掩盖问题:P95 是 8 秒而平均值 2 秒时,平均值完全看不出有 5% 的用户在忍受极慢的体验。渲染指标(LCP/INP/CLS)有业界通用阈值,直接抄过来当起步线即可;至少把「平均值」升级成「P50 / P95 两档」,再看细分指标。
- Web事务监控会不会产生大量测试订单,污染业务数据?
答:正规做法是脚本里使用专用测试账号,支付与下单环节走沙箱或打测试标记;Web事务监控的回放频率也不需要高——核心事务 5 分钟一次足以覆盖故障窗口。上线前先在测试环境跑一轮,确认每一步的断言与清理逻辑,再切生产。
- 四层都做齐了,为什么还会漏报?
答:先检查监控自身:探针是否还在跑、告警通道是否通、阈值是否被静默期吞掉。四层清单的盲区主要在第四层口径——转化数据的统计延迟、渠道归因变化都会造成假信号;把「监控自身健康」也当成一项监控(探针心跳告警),漏报会显著减少。
