
光模块监控:AI 数据中心里最不该是盲区的一层

AI 摘要
光模块监控的缺口从来不在"采不到数"。按 SFF-8472 规范,支持 DOM 的模块把收光功率、发光功率、温度、供电电压与激光偏置电流写在内部寄存器里,通过 SNMP 就能读;真正的缺口是没人订阅这组指标,于是一个正在缓慢变坏的光口,在监控台上永远是"正常"。本文从微软游说美国政府对华光模块限制的新闻切入,拆开"端口 up 就算健康"背后的三个断层,给出可落地的口径——四个光学参数配三个接口计数器、按模块型号分组设阈值,再落到光衰、混插、老化三类现场与五步实施路径。
答案先说:光模块监控的价值不在于多一块仪表盘,而在于拆掉"端口 up 就算正常"这条默认假设。支持 DOM 的模块一直在用 SNMP 报数,缺的是订阅动作和一套按型号分组的口径。
补上这一层只需要三件事,而且顺序不能反:先按模块型号分组,再挑四个光学参数,最后配三条与接口计数器联动的规则。反过来做——先拉一条通用阈值上传——结果一定是误告淹没真告警,运维开始习惯性忽略光模块告警,真正的故障反而被埋掉。
这也是选型时该多问一句的地方:一款 网络监控软件 能不能按型号分组设阈值,能不能把光学参数和接口错误画在同一张趋势图上。ManageEngine OpManager 的做法是把 DOM 参数用自定义监视器接进来,与接口计数器共用同一套阈值、告警与拓扑上下文——不是为了多一个看板,而是为了让"3 号口收光比同批低了 4 dB"这句话直接出现在告警里。
核心要点
- 端口 up 只说明激光有光、链路协商通过,不说明误码率合格;光衰走到临界时,端口状态依然是 up。
- 四个关键参数在设备 SNMP 表里:收光功率、发光功率、模块温度、激光偏置电流,规范来自 SFF-8472。
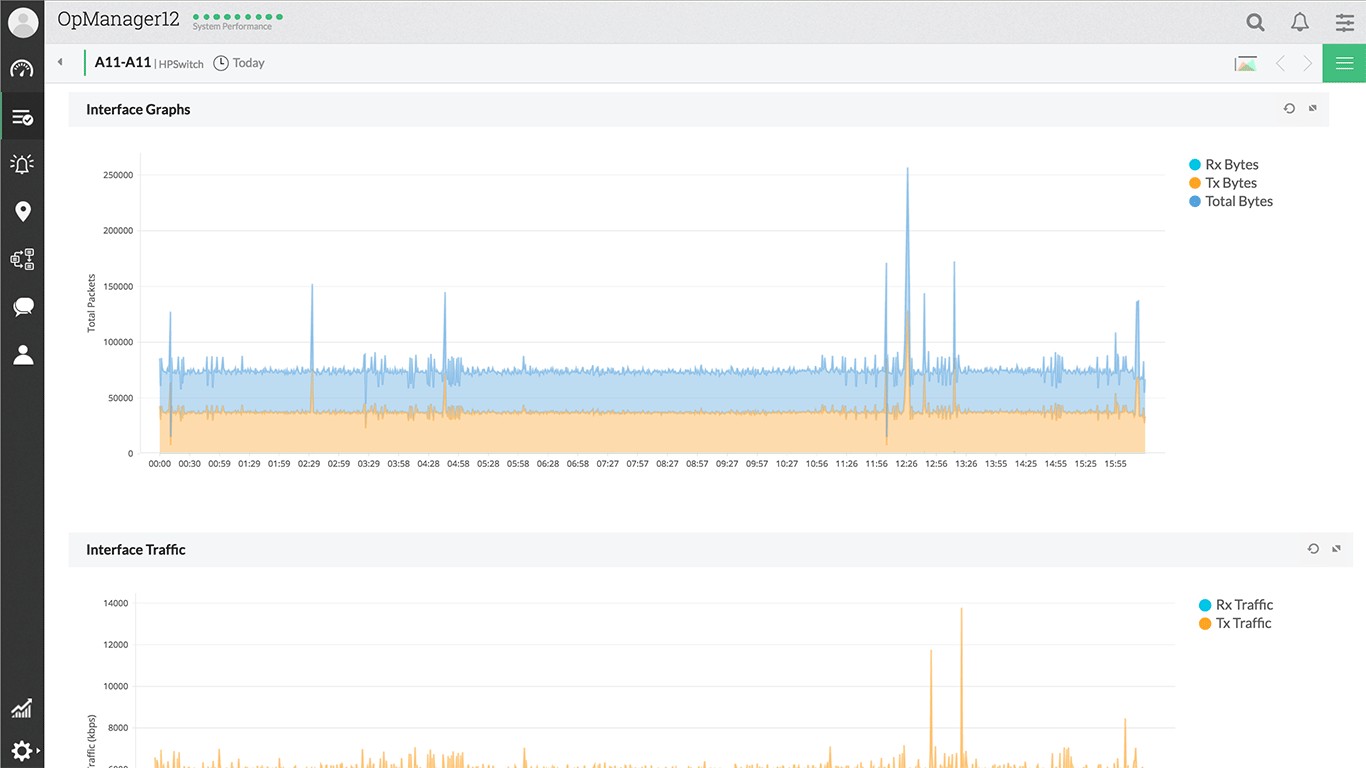
- 光层故障的第一现场是接口错误计数器,不是带宽利用率——利用率只有 3% 的链路,照样能整晚丢包。
- 阈值必须按模块型号、速率、传输距离分组:同一条 -20 dBm 的门限,对 10km 单模是灾难,对 40km 是正常。
- 偏置电流持续上升叠加温度同步抬升,是模块老化最可靠的早期信号,通常比"端口突然 down"早几周出现。

一条新闻:光模块成了 AI 集群的神经系统
11 月 10 日,路透社报道微软正游说美国政府放弃限制进口中国新型号光收发器的计划。理由很直接:微软在美国有 35 座数据中心在建、134 座处于规划阶段,而集群内部服务器、交换机、路由器之间的互联全靠光模块;不少云厂商已经买好 AI 芯片,但没有光模块把设备连起来,芯片只能闲置。
监管焦点落在速率上:FCC 正研究把 3.2Tbps 的中国光模块纳入限制范围,而当前主流还在从 800G 向 1.6T 过渡。中国厂商约占全球光收发器市场的三分之二。
这条新闻讲的是供应链。对运维团队来说,它真正的提醒在另一面:光模块是数据中心里数量最多、单价最低、失效最频繁,同时最缺少监控的部件。一个万卡集群要用的光模块以十万计,任何一只收光跌几个 dB,都可能让一次训练任务在几小时后报超时——而现场往往只剩一句"网络好像有点慢"。
国内智算中心与东数西算节点的建设节奏让这件事更具体:国产模块在存量网络中的比例越来越高,一个机房里同时跑着三四个厂商、五六个批次、从 10G 到 400G 混插的模块。国产化运维 讨论的是怎么把混合架构管起来,落点往往就从这样一只不起眼的模块开始。
三个断层:端口 up 为什么骗人
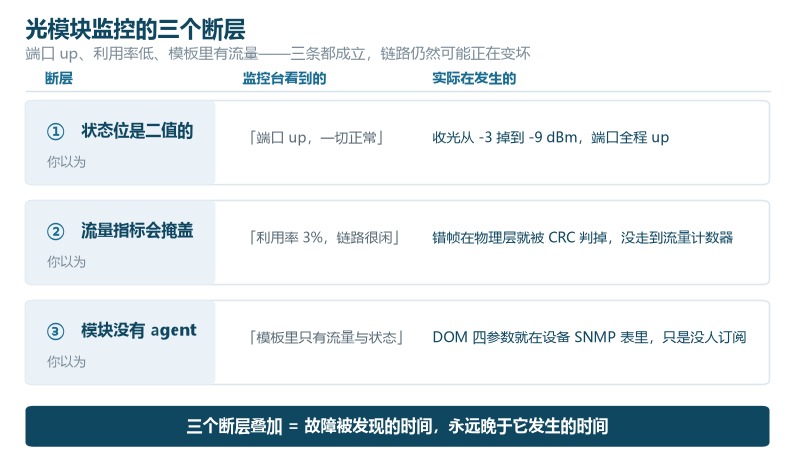
大多数网络监控止步于"设备在线、端口 up、带宽不高"。这三项全绿,并不等于光链路健康,中间隔着三个断层。
断层一,状态位是二值的,退化是连续的。端口 up 只代表激光有光、协商通过。从收光 -3 dBm 掉到 -9 dBm 的整个过程中,端口一直是 up,直到某一刻越过误码门限,业务才开始零星报错。
断层二,流量指标会掩盖光层问题。带宽利用率回答"用了多少",不回答"送对了多少"。一套只盯着流量的 带宽监控 方案,看到的永远是"链路很闲",而丢掉的包在到达计数器之前,就已经在物理层被 CRC 判掉了。
断层三,光模块没有 agent。服务器有 agent、虚拟机有 SDK,光模块什么都没有,它的全部信息都挂在宿主设备的 SNMP 表里。设备模板里如果只有 ifInOctets、ifOutOctets、ifOperStatus 这几项,这只模块等于没有监控。
三个断层叠在一起,结果是同一个:故障被发现的时间总滞后于发生的时间。光链路退化以周为单位,本来有足够窗口——前提是有人先把它看见。
能读出哪些数:四个光参数配三个计数器
支持 DOM 的模块遵循 SFF-8472,在 A2h 页里提供实时诊断参数:温度、供电电压、激光偏置电流、发光功率与收光功率。设备侧一条 CLI 就能看到——Cisco 是 show interfaces transceiver detail,华为是 display transceiver diagnosis interface。数据一直都在。
关键在于读哪几个、和什么一起读。下面这张表是实践里最够用的组合。
| 指标 | 反映什么 | 怎么看 | 异常先怀疑谁 |
|---|---|---|---|
| 收光功率 Rx(dBm) | 对端发光经链路衰减后的到达值 | 与同批同型号模块横向比,看日趋势 | 接头脏污、弯折过小、熔接点损耗、对端激光衰减 |
| 发光功率 Tx(dBm) | 本端激光的实际输出 | 更换或变更后与出厂值比 | 本端模块激光衰减、光口污染 |
| 模块温度(℃) | 模块内部工作温度 | 看趋势,与同机架同位置比 | 风道、风扇、端口密度过高 |
| 激光偏置电流(mA) | 维持输出功率所需的驱动电流 | 月度趋势,只看斜率不看绝对值 | 激光器老化(最早期信号) |
| CRC / FCS 错误 | 物理层误码计数 | 看增量速率,不看累计总量 | 光衰、模块不匹配、链路干扰 |
| discards 丢弃 | 拥塞或错误导致的丢帧 | 与利用率同看,单独看会误判 | 拥塞、缓冲不足、错误帧 |
| 端口 flap 次数 | up/down 反复次数 | 变更前后对比 | 光衰临界、接触不良、供电抖动 |
需要说明一点:具体门限以模块 datasheet 与厂商规格为准,不同速率、不同传输距离的模块差别很大。表里给的是"看什么、怎么比",不是"多少算正常"。照抄一条绝对阈值,是光模块监控最常见的失败方式。
配套的监控侧动作也简单:把这几项做成 接口监控 的常规项,让每个上联口都有光功率趋势,而不是等出了事再敲命令去查。
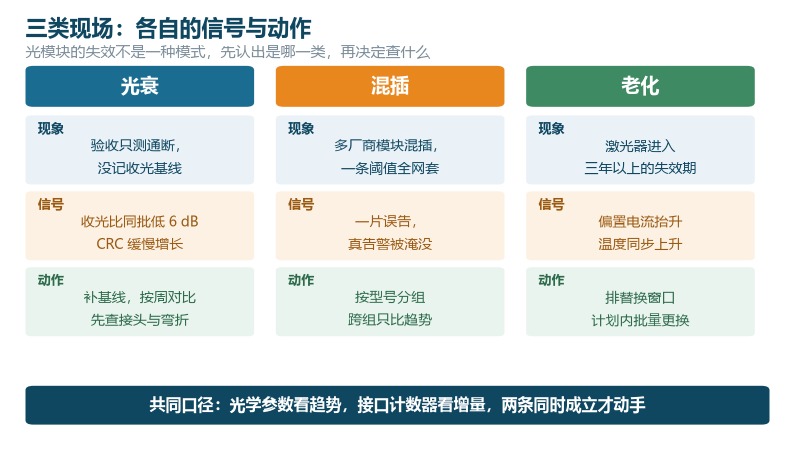
三个现场:光衰、混插、老化
现场一,光衰——验收时没留基线。新建链路验收,多数人只测通断:能 ping 通、端口 up、跑个 iperf 有数,就算过。但收光在验收那一刻是多少,没人记。半年后业务开始零星超时,翻遍监控只看到"端口正常",最后在交换机上敲一条命令才发现:这一对的收光比同批模块低了 6 dB。问题多半出在施工侧——接头没擦、弯折半径不够、熔接点损耗偏大。验收时留一条基线,这一眼就能看出来。
现场二,混插——阈值一刀切,告警变噪音。国产模块与第三方模块混插,在多厂商交换机上已是日常。麻烦在于不同厂商对 DOM 的精度与告警门限定义并不一致:有的模块读数本身就偏一两个 dB,有的把门限写在 EEPROM 里且比通用值宽。若全网拉一条统一的收光阈值,结果就是一片误告——运维开始习惯性忽略光模块告警,真故障反而被淹没。做法是按型号分组,同组同阈值,跨组只比趋势。
现场三,老化——偏置电流比端口状态更早说话。激光器老化不是突然发生的。为了维持同样的输出功率,老化的激光器需要更大的驱动电流,偏置电流因此缓慢抬升,温度往往跟着上升。这条曲线通常比"端口 down"早几周出现,是安排替换窗口最好的依据——把被动抢修换成计划内更换,代价差一个数量级。
五步落地,三个坑
第一步,盘清哪些端口真的能采。支持 DOM 的模块才有这组数;DAC 铜缆、部分 AOC 与老模块没有。先分清范围,别对着采不到的端口配阈值。
第二步,把四个光参数接进来。DOM 参数本质上就是 SNMP 数值,用自定义监视器对相应 OID 建图即可。一套 snmp监控 工具在这里的差别不是"能不能建图",而是能不能把这类自定义项纳入统一的阈值与告警体系,而不是散在几个脚本里。
第三步,按型号、速率、距离分组。同组共用一套阈值,跨组只比趋势不比绝对值。分组做完,误告通常掉一个数量级。
第四步,配三条联动规则。收光低于同组基线 N dB 且持续若干分钟;CRC/FCS 错误增量速率超限;偏置电流环比持续上升。三条都要与接口计数器同看,单看任何一条都会误判。
第五步,把告警接回上下文。光模块告警出现在拓扑与业务视图上,才知道影响的是哪条链路、哪个业务——这决定了排障是从"3 号口"开始,还是从"这个机柜"开始。
坑一,只设绝对值不设基线。同一条 -20 dBm 挂在 10km 与 40km 的模块上,前者天天告警,后者永不告警。基线来自同组模块的实际分布,不是来自记忆里的经验值。
坑二,把不同厂商的 DOM 读数当同精度值横向比较。趋势可以跨厂商比,绝对读数不行。
坑三,轮询太密。DOM 表按端口数线性膨胀,一台 48 口交换机接近两百个实例,全表高频 walk 会明显抬高设备 CPU,低端交换机甚至会出现采集丢包——监控本身变成了故障源。
参考来源
SFF-8472《Diagnostic Monitoring Interface for Optical Transceivers》:DOM/DDM 参数定义与寄存器布局,文中四个光学参数即出自该规范。
ITU-T G.652《Characteristics of a single-mode optical fibre and cable》:单模光纤的衰减与色散特性,用于理解链路损耗预算。
路透社报道(2026-11-10,中文转载):微软游说美国政府放弃中国光模块进口限制,含 35 座在建、134 座规划、3.2Tbps 限制范围与约三分之二市场份额等数据。
说明:文中命令以 Cisco IOS 与华为 VRP 为例,不同版本的命令字可能略有差异;各项门限请以模块 datasheet 与设备厂商规格为准。
一句话总结:光模块监控不是加一块仪表盘,而是把"端口 up 就算正常"这条默认假设拆掉——四个光参数配三个接口计数器,按型号分组设阈值,光衰才有机会在变成故障之前被看见。
延伸阅读
光链路要不要纳入监控?
按您现在最关心的那一项继续。
常见问题
- 交换机端口没 down,但业务时断时续,怎么判断是不是光模块的问题?
答:先看接口错误计数器,不要看利用率。在设备上敲一条 transceiver diagnosis 命令看收光,再对比同批同型号模块的读数。如果收光比同组低 3 dB 以上,同时 CRC/FCS 错误在增长,基本可以落到光层。反过来,若错误计数器干净、收光正常,就往上查协商速率、双工、MTU,别在光模块上耗时间。
- 收光功率多少算正常?光衰预算怎么算?
答:没有统一值,只有区间:模块 datasheet 会给最小接收灵敏度与最大饱和点,落在两者之间才算合规。预算算法是「发光功率最小值 − 链路损耗 ≥ 接收灵敏度 + 余量」。链路损耗按光纤衰减(1310nm 约 0.35 dB/km、1550nm 约 0.25 dB/km)、熔接点(约 0.1 dB/个)、连接器(约 0.3–0.5 dB/个)累加,余量建议留 3 dB 以上,用来吸收老化与温度漂移。
- 第三方或国产光模块混插,DOM 读数还准吗?
答:能读,但精度与门限定义不一定一致。SFF-8472 规定了寄存器布局与换算方式,读数语义是可比的;但传感器精度、校准质量因厂商而异,偏差一两个 dB 很常见。实践口径是:同型号比绝对值,跨型号只比趋势。
- 老模块不支持 DOM,还能监控吗?
答:能监控链路,不能监控模块内部。可用的替代信号有三个:接口错误计数器(CRC/FCS)、端口 flap 次数、链路的流量与丢包变化——这三项都由设备侧提供,不依赖 DOM。真要补上光功率,只能定期现场用光功率计抽测,把结果录入资产记录,用人工趋势补位。
- 光模块监控的轮询间隔设多少合适?
答:分钟级就够。光衰与偏置电流变化的时间尺度是天和周,一分钟一次和五分钟一次对判断几乎没有区别,但设备侧 SNMP 负载差好几倍。DOM 表按端口数线性增长,高密度交换机可能有上百个实例,间隔过密会挤占设备 CPU,低端设备还会丢包——采集本身变成故障源。

