存储管理怎么做?从容量水位到 IO 延迟的三级预警

AI 摘要
AI 摘要:存储告警几乎都停在第一级——「磁盘用了 80%」这类水位告警,而水位恰恰是三级信息里最不顶用的一级:大容量盘涨得慢,80% 能白响半年;突发写入不涨水位,业务却已经卡住。本文给出一套可直接落地的「存储三级预警」:第一级看水位(现在满不满),第二级看增长速率(多久后满),第三级看 IO 延迟(现在卡不卡)——每一级都给出阈值建议与一条可执行的验收动作,最后划清存储管理与服务器管理、硬件监控的分工边界。对存储来说,容量满了通常还有缓冲时间,IO 延迟升高才是业务正在受影响的直接信号。
答案先说:存储管理做三级预警,而不是一条水位告警打天下:第一级看水位——现在满不满;第二级看增长速率——照这个速度多久后满;第三级看 IO 延迟——现在读写的响应时间是多少。水位是「存量」,增长速率是「趋势」,IO 延迟是「体感」:三级各回答一个独立的问题,混成一条告警,三种问题都答不好。
为什么单靠水位几乎没用?三个场景:大容量盘水位从 60% 涨到 80% 用了一年,告警响了半年没人处理;日志突涨把 inode 或小分区打满,水位之外的维度先出了问题;数据库缓存写入把 IO 队列压满、响应时间翻倍,水位却纹丝不动。三种情况里,真正先告诉出事的信号都不是水位。
ManageEngine OpManager在这套预警里的位置,是把三级指标放进同一套阈值与告警链路:水位与增长速率在存储节点上按分区采集,IO 延迟对到具体卷与时段,再把存储的告警与服务器管理、硬件监控的告警排在同一条时间线上——存储出问题时,是「盘快满了」还是「盘要坏了」还是「OS 层在吃空间」,一眼分层。

核心要点
- 水位告警是三级里信息量最低的:它说「满了」,不说「多快满的」,更不说「业务是不是已经卡了」。
- 存储三级预警:水位(存量)→ 增长速率(趋势)→ IO 延迟(体感),三级各回答一个独立的问题。
- 增长速率比水位更早给出预警窗口:同样 80%,月增 2% 和日增 5% 是两个完全不同紧急程度的事件。
- IO 延迟是直接对着业务体验的一级:容量满了通常还有缓冲时间,延迟升高才是业务正在受影响的信号。
为什么「磁盘用了 80%」这条告警几乎没用
几乎所有存储告警都停在水位这一级,而它失效的方式非常固定。场景一:大容量盘涨得慢——水位从 60% 涨到 80% 花了一年,告警从第一天响到最后,没人处理、也没人敢关,最后这条告警成了背景噪音;场景二:水位之外的维度先出问题——小分区、inode、日志目录被突涨打满,整盘水位看着健康,服务却已经报错;场景三:水位纹丝不动、业务先卡——数据库与虚拟化环境的写入大量进缓存,IO 队列压满、响应时间翻倍,等水位到 90%,业务已经痛了一个月。
三个场景的共同点是:水位是「存量快照」,它不携带任何趋势信息,也不携带任何性能信息。靠一条水位告警管存储,等于只看油表开车——不看油耗,也不看发动机转速。三级预警就是把「油耗」和「转速」补上。
三级预警:水位 → 增长速率 → IO 延迟
三级按「从存量到体感」排列,每一级回答一个独立的问题、配独立的阈值。下表是三级的阈值建议与验收动作——右列答不上来,就说明这一级还没真正用起来。
| 预警级 | 回答什么 | 阈值建议 | 一条可执行的验收动作 |
|---|---|---|---|
| ① 水位(存量) | 现在满不满 | 70% 关注、85% 处理、95% 紧急;按分区不按整盘 | 列一下当前 85% 以上的分区:每一个都知道是什么在吃空间吗 |
| ② 增长速率(趋势) | 照这个速度多久后满 | 周环比连续两周为正即关注;按剩余天数给窗口 | 挑一个增长最快的分区:能说出它每天的净增量与「还剩多少天」吗 |
| ③ IO 延迟(体感) | 现在卡不卡 | 持续高于平时基线两倍即告警;读写分开看 | 查昨天最忙的一小时:核心卷的读写延迟有没有超出常态区间 |
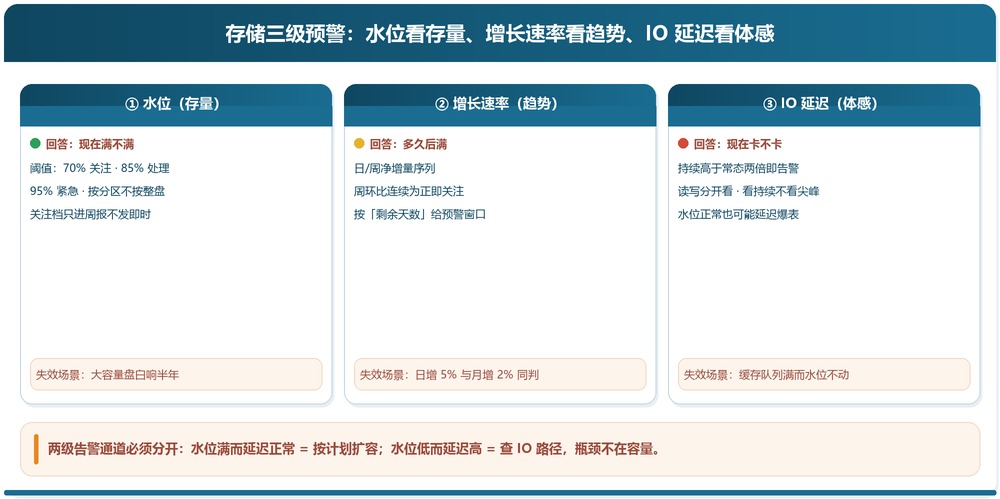
先说水位怎么定才不沦为噪音:按分区而不是按整盘设阈值——整盘 70% 在业务盘和系统盘上是完全不同的两件事;阈值分三档(关注、处理、紧急),而且「关注」档的告警不发即时通知、只进周报,避免大容量盘把人训练成狼来了。
再强调一次三级的独立关系:水位满而延迟正常,说明还有缓冲时间,按计划扩容即可;水位低而延迟高,说明瓶颈根本不在容量,查 IO 路径——两条告警通道必须分开,合并在一起就失去了「判断紧急程度」的能力。
增长速率:比水位更早给出预警窗口
第二级是整个方法里性价比最高的一级。它的核心不是「水位多少」,而是「每天净增多少」:把每天的水位变化做成序列,算出剩余容量的耗尽天数——同样 80%,月增 2% 的盘还有一年多,日增 5% 的盘只剩三天,紧急程度天差地别,而水位告警对两者一视同仁。
增长速率还自带「归因线索」:周环比突然抬升,背后一定有事件——新上线的备份任务、日志级别被改、某个应用开始堆积临时文件。把速率曲线和应用变更的时间对齐,多数「莫名涨满」都能找到责任方。这一级做成系统能力就是容量预测:按历史速率外推「何时到顶」,扩容预算从「凭感觉」变成「按曲线」——容量预测做的越久,预警窗口就越早,从「下周满」提前到「下季度满」。
顺带一个容易漏的口径:速率要按「净增量」算——快照、备份副本、回收站都占真实空间,只看业务数据增速会严重低估耗尽时间。至少每周扫一次「非业务占用的 Top 10」,很多「莫名涨满」的答案就在这个清单里。
IO 延迟:直接对着业务体验的那一级
第三级回答的问题是「现在卡不卡」——这是唯一与业务体感直接挂钩的指标。经验口径上,块存储的读写延迟持续高于自身常态两倍即值得关注,持续高于十毫秒就要排查(SSD 与机械盘的常态差异很大,所以阈值要对着自己的基线定,而不是套通用数字)。重点在「持续」两个字:备份窗口里的延迟尖峰是正常的,业务时段的持续抬升才是问题。
延迟告警的价值在于抓「水位之外」的存储事故:缓存失效、队列堆积、RAID 降级重建、快照连锁——这些事件的共同特征是容量曲线毫无波澜。还有一类时效性很强的场景:勒索加密发作时,海量小文件被快速改写,IO 延迟往往在容量暴涨之前先异常——这也是存储延迟与安全告警放在同一时间线上的价值,两条曲线互相印证,能比单看任何一条更早发现异常。
分工边界:存储管理、服务器管理、硬件监控各管一段
存储告警乱,一半原因是三层职责混在一起。分工这样切:
OS 与文件系统层归服务器管理:分区水位、inode、目录配额、日志清理——这些是操作系统视角的存储,也是「水位 80%」告警真正的发生地。物理健康层归硬件监控:SMART 指标、介质错误、坏块重映射、RAID 卡电池——盘「快坏了」的信号在这里,它与「快满了」是两类完全不同的预警。容量与 IO 性能层归存储管理:卷级水位与增长、IO 延迟与队列、存储池与快照空间——三级预警的二级和三级都发生在这一层。
三层的告警要进同一张时间线——数据中心监控视角下,一次「存储慢」的故障可能是盘的物理衰减(硬件层)、也可能是日志洪峰(OS 层)或快照空间耗尽(存储层):三层指标按时间对齐,两分钟就能定位是哪一层的问题,而在三套工具里来回切换,这个定位要一下午。
参考来源
1. NIST SP 800-209《Security Guidelines for Storage Infrastructure》(存储基础设施的管理与安全指南,容量、可用性与监控的权威框架)
2. CISA「#StopRansomware」资源页(勒索攻击对存储容量与 IO 的冲击场景与应对清单,支撑「延迟先于水位」的安全面观察)
说明:三级阈值与分工边界为通用实践归纳,延迟基线请按自身介质类型与业务特征设定;产品能力以官方页面为准。
一句话总结:存储管理不是盯一条 80% 的水位告警——水位看存量、增长速率看趋势、IO 延迟看体感,三级分开设阈值、合并看时间线,存储才从「满了才知道」变成「满之前三个月就有答案」。
延伸阅读
想把三级预警用起来?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 水位阈值定多少合适?70% 会不会太保守?
答:按分区角色分着定:系统盘和日志盘 70% 就该关注(它们打满的后果最急);业务数据盘 85% 处理、95% 紧急是常见口径;备份与归档盘可以放宽到 90%。关键不是数字本身,而是「每个阈值档位接什么动作」:关注档进周报、处理档开工单、紧急档发即时通知——没有动作的阈值只是噪音发生器。
- 增长速率怎么算才不会被备份任务干扰?
答:按「净增量」算:把快照、副本、回收站、日志都算进占用,并且区分「计划内增长」和「计划外增长」——备份窗口的周期性上涨是计划内,应该在基线里被吸收;连续多天持续上涨、且不回落到常态区间的,才是真正的趋势。把两者分开,速率序列才具备预警价值。
- IO 延迟看平均还是看 P95/P99?
答:告警看持续均值或 P95,排查看 P99 与分布。平均值会掩盖尾部问题——平均 5 毫秒、P99 却 200 毫秒的卷,业务感受是「时不时卡一下」,这类问题只有分布能暴露。实务上建议延迟曲线至少三条线一起看:均值、P95、最大值,持久化的延迟直方图比单一数字有用得多。
- RAID 重建期间应该关注哪一级?
答:优先盯第三级和硬件层。重建期间阵列性能下降、延迟抬升是预期内的,关键看两点:一是延迟抬升的幅度是否超出业务可接受范围(必要时错峰重建),二是重建期间同一 RAID 组里再掉一块盘就是数据事故——所以重建窗口应该临时提高硬件层告警的级别,并把业务备份计划避开这个窗口。
- 存储管理与服务器监控不是重叠了吗?
答:不重叠,是分层。服务器监控看的是「这台机器的盘」——OS 视角的分区与配额;存储管理看的是「这批卷和存储池」——容量趋势与 IO 性能。一台物理机上两套数据都有,但关心的问题不同:OS 层回答「哪个目录在吃空间」,存储层回答「哪个卷快到顶了、IO 是不是已经拖慢业务」。两层都做、告警合并到一条时间线,才是完整的存储视角。这也是数据中心监控里常见的分层模式:同一批设备,每层各有各的问题和指标。

