
智算中心网络监控:GPU 利用率低,先看 RoCE 这五个指标

AI 摘要
随着 400G/800G 智算网络大规模上线,GPU 利用率上不去的原因往往不在算力侧,而在 RoCE 无损网络:同步集合通信里最慢的节点决定整轮迭代时间,一次丢包重传、一场 PFC 风暴,都能让整个集群“陪等”。本文解释智算网络监控要看哪五个指标——PFC Pause、ECN/CNP、Buffer/Queue、光模块 DOM、丢包与重传,说明 SNMP 轮询与 gNMI/Telemetry 的分工,并给出在 OpManager 里从纳管、阈值到告警关联的落地顺序。
答案先说:GPU 利用率低,先别急着加卡。分布式训练是同步计算——每一轮迭代,所有节点算完各自的部分,再通过网络同步参数,全部到齐才能进下一轮。所以只要有一个节点因为网络抖动慢了,其余节点就在空等,GPU 利用率表现得像“算力不够”,根因却常在交换机的队列和光模块里。
这个话题最近的关注度不偶然:一边是海外大额收购把“AI 连接”推上台面,一边是国内 400G/800G 国产交换机陆续发布、智算中心批量投产。算力集群越建越大,网络从“配角”变成了决定 GPU 有效利用率的第一变量——RoCE 无损以太网对丢包零容忍,一次拥塞引发的重传会让所有节点一起等。
本文不讲组网,只讲监控:智算网络的 网络监控 该盯哪五个指标,传统 SNMP 轮询和秒级 Telemetry 各管什么,以及在 OpManager 里怎么把这套监控配起来。

核心要点
- 同步集合通信的木桶效应:最慢节点决定整轮迭代时间,一个节点丢包,全集群陪等。
- RoCE 五个必看指标:PFC Pause、ECN/CNP、Buffer/Queue、光模块 DOM、丢包与重传——都不在 GPU 侧。
- SNMP 轮询管基础可用性与流量趋势,秒级队列指标交给 gNMI/Telemetry,两者是分工不是替代。
- 智算网络的阈值不能照搬园区网:微突发是常态,看持续与趋势,不看单点尖峰。
- 落地顺序:先补采集覆盖,再按智算口径调阈值,最后把网络告警与训练任务异常关联起来。
一、GPU 利用率低,为什么先查网络
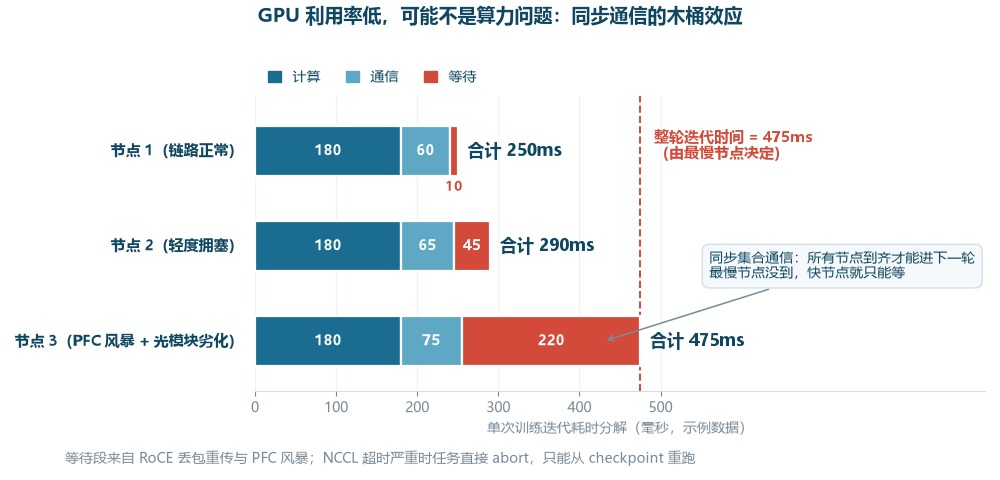
大模型训练的流量模式和传统业务完全不同。参数同步是典型的东西向大带宽流量:成百上千张卡在每一轮迭代里互相交换梯度,任何一段链路拥塞,NCCL 的重传机制就会让整个通信域里的节点一起等待——等待超时,任务直接 abort,只能从上一个 checkpoint 重跑,前面的算力全部白费。
把一次迭代的耗时拆开看会更直观:计算段由 GPU 决定,通信段由网络决定,等待段则来自丢包重传、PFC 风暴和光模块劣化。三节点集群的示例里,两个节点 250ms 就能完成的迭代,因为第三个节点出现 PFC 风暴,整轮时间被拖到 475ms——集群有效算力几乎腰斩,但从 GPU 侧看,“利用率波动”是唯一的症状。
这就是智算网络监控的第一个原则:解释“GPU 为什么在等”,证据通常在交换机侧,而不是在服务器侧。
二、五个指标逐个看:每一个都能把 GPU 变成“在等”
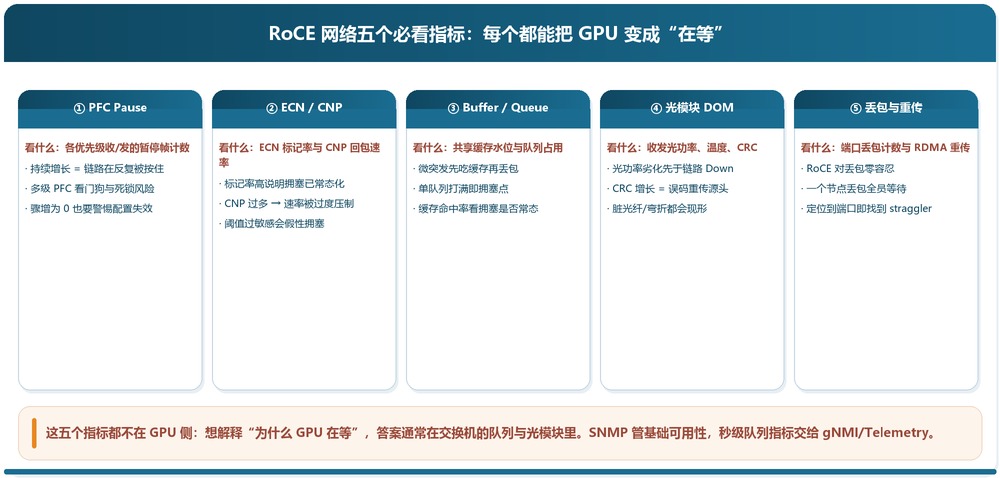
RoCE 无损网络的监控点与传统以太网不同,重点不在“通不通”,而在“拥不拥塞、丢没丢”。下面五个指标,建议全部纳入采集。
| 指标 | 看什么 | 什么算异常 |
|---|---|---|
| ① PFC Pause 帧 | 各优先级收发的暂停帧计数 | 持续增长 = 链路反复被按住;多级级联要防 PFC 死锁 |
| ② ECN / CNP | ECN 标记率与 CNP 回包速率 | 标记率持续偏高 = 拥塞常态化;CNP 过多 = 发送端被过度压制 |
| ③ Buffer / Queue | 共享缓存水位与各队列占用 | 单队列打满即拥塞点;微突发先吃缓存、后丢包 |
| ④ 光模块 DOM | 收发光功率、温度、CRC 计数 | 光功率劣化与 CRC 增长先于链路 Down,是重传的源头 |
| ⑤ 丢包与重传 | 端口丢包计数与 RDMA 重传 | RoCE 对丢包零容忍;定位到端口就找到了拖慢集群的节点 |
前两个指标解释“拥塞是怎么被治理的”:PFC 在链路层按住下游,ECN 在网络层做显式拥塞通知,两者本身是机制,但它们的计数器是判断拥塞是否常态化最直接的窗口。第三个指标解释“丢包是怎么发生的”:微突发先消耗缓存,缓存见底才开始丢包,所以缓存水位比丢包计数更早发出信号。后两个指标解释“性能为什么劣化”:光模块的收光功率和 CRC 计数是物理层的前兆指标,而丢包与重传计数则直接指向那个拖慢全集群的 straggler 节点。
监控口径上有一条和园区网不同的纪律:智算网络的微突发是常态,阈值要看“持续多久、趋势朝哪”,而不是单点尖峰——按园区网的口径配告警,第一天就会被告警风暴淹没。
三、SNMP 轮询和 gNMI/Telemetry,不是二选一
很多团队在智算网络监控上纠结采集协议,其实两者是分工关系。
SNMP 轮询适合承载基础层:设备可用性、端口状态、接口流量、CPU/内存/温度,60 秒级的轮询间隔足够,生态成熟、全厂商支持,负责回答“设备在不在、流量多大、有没有 Down”。
gNMI/Telemetry适合承载队列层:PFC、ECN、Buffer/Queue 这类秒级指标,变化周期以毫秒计,轮询抓不住。gNMI 基于 gRPC,支持按订阅推送(dial-out)或按需拉取(dial-in),把指定路径的计数器持续推给采集端,这才是无损网络队列指标的合理采集方式。
所以合理的架构是双层采集:底层用 SNMP 保证覆盖面与告警连续性,上层对核心的 RoCE 交换机开 Telemetry 订阅,把秒级队列指标单独采集。两层的数据要落在同一个设备和接口维度上,排障时才能互相对照。
四、在 OpManager 里怎么把这套监控配起来
落到工具层面,这套 网络性能监控 体系在 ManageEngine OpManager 里的配置路径是这样的。
第一步,纳管:智算网络的交换机与传统设备纳管方式一致:SNMP 凭据配好,设备自动发现并套用厂商模板,接口、流量、可用性指标即刻上线;华为、H3C、锐捷、Cisco 等主流厂商的 400G/800G 数据中心交换机都在预置模板覆盖范围内。
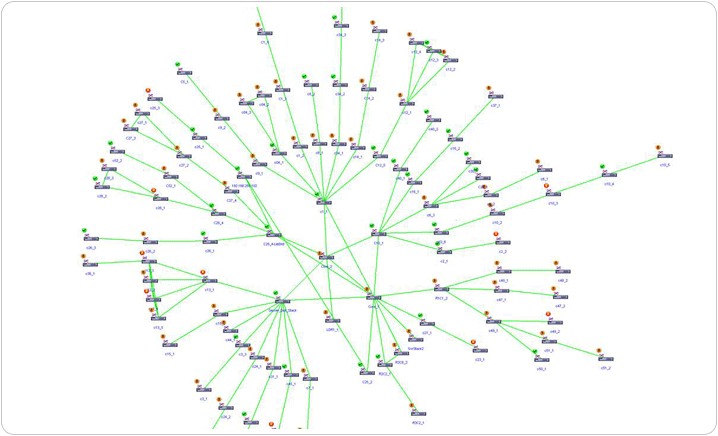
第二步,基础指标:接口层面的收发包、错误包、丢包、带宽利用率是基础告警项;配合 带宽监控 的流量视图,能看到微突发在哪些链路、哪些时段集中出现;再按接口粒度设阈值,核心的 RoCE 链路单独收紧。
第三步,队列层:对支持 Telemetry 的交换机,把 PFC/ECN/队列指标接入秒级采集;没有 Telemetry 条件的设备,至少把 DOM 光功率与 CRC 计数纳入 SNMP 监控 轮询,这两个指标在 60 秒粒度上依然有效。
第四步,阈值与关联:用自适应阈值替代固定阈值,让基线随训练任务的流量节奏自动校准;再把“光模块 CRC 增长 + 接口丢包 + 上游 PFC 风暴”这类多信号设成关联告警,一次触发直接指向可疑链路,而不是三条独立通知。
五、落地顺序:三步验收,别被告警淹没
如果智算网络刚上线,建议按这个顺序推进,每一步都有可验收的产出:
第一步,覆盖:核心 Spine-Leaf 全部纳管,接口指标无盲区,验收标准是“任一端口 Down,一分钟内有告警”;
第二步,口径:按智算口径重设阈值:微突发用持续时长判定,光功率用趋势判定,验收标准是“一周内无重复无效告警”;
第三步,关联:把网络告警与训练任务异常放在同一个时间轴上,NCCL 超时的时刻附近,一定能找到对应的端口或队列异常——这是判断网络监控是否真正生效的最终标准。
做完整条链路,“GPU 利用率低”就不再是玄学:先看等待段有没有变长,再顺着五个指标定位到具体端口,剩下的就是换光模块还是调 PFC 参数的问题了。
参考来源
1. RFC 3168《The Addition of Explicit Congestion Notification (ECN) to IP》:ECN 显式拥塞通知的机制定义,用于对照“标记率、CNP 回包”这些指标的网络层语义。
2. OpenConfig《gNMI Specification》:gNMI 基于 gRPC 的网络管理接口规范,dial-in / dial-out 两种订阅模式的定义来源。
说明:文中迭代耗时为示意数据;PFC/ECN 参数与采集路径因交换机厂商与 OS 版本而异,请以设备文档为准。本文不涉及具体组网设计与调参步骤。
一句话总结:智算中心的算力账单里,最贵的一段等待往往发生在网络。把 PFC、ECN、队列、光模块、丢包五个指标纳入采集,SNMP 与 Telemetry 分层分工,GPU 利用率的每一次异常,都能顺着端口找到答案。
延伸阅读
想把这五个指标配起来?
按您现在最关心的那一项继续。
常见问题(FAQs)
- GPU 利用率低,一定是网络问题吗?
答:不一定。数据加载瓶颈、CPU 预处理跟不上、并行文件系统带宽争用都会导致 GPU 空转。但可以先做一个快速判别:如果多轮任务的等待时间集中在集合通信阶段、且随集群规模增大而恶化,网络侧的概率就很高。最终要靠交换机侧指标证实。
- PFC Pause 帧增长是不是一定有问题?
答:短时、低频的 Pause 帧是 RoCE 正常工作机制的一部分。需要警惕的是三类形态:持续线性增长、集中在同一条链路、以及伴随上游队列水位同时抬升。出现多级级联时还要关注 PFC 死锁风险。
- 没有 Telemetry 条件的设备怎么办?
答:至少把光模块 DOM(收发光功率、温度)与接口 CRC、丢包计数纳入 60 秒级 SNMP 轮询,这些指标在秒级以下才有价值的只有队列类;DOM 与 CRC 在分钟粒度上依然能提前发现物理层劣化。核心 RoCE 交换机再逐步补 Telemetry。
- 智算网络的告警阈值为什么不能照搬园区网?
答:园区网流量相对平稳,固定阈值可用;训练流量呈周期性微突发,固定阈值会反复误报。正确做法是按“持续时长 + 趋势方向”判定,或使用随基线自动校准的自适应阈值,并针对核心 RoCE 链路单独收紧。
- NCCL 超时和网络告警怎么关联起来?
答:把训练任务的异常时间点与网络告警落在同一时间轴上:超时发生前后,通常能在某些端口上找到丢包增长、CRC 异常或 PFC 风暴的痕迹。反复出现同一链路,就说明问题在物理层或配置层,而不是偶发抖动。

