网络测试工具为什么测不准时延?主动监控与被动监控怎么分工

AI 摘要
AI 摘要:同一条链路,「平均时延 20 毫秒」和「业务就是慢」可以同时成立——因为主动探测和被动采集说的根本不是一件事。本文把网络时延测量拆开:被动采集负责发现异常(流数据与镜像流量的真实行为记录),主动探测负责验证与定责(受控注入的探测流,能分段定位到具体链路);再给出测不准的三个常见原因——拿均值当结论、探测时长太短漏掉抖动、把设备处理时间算进时延。文末附主动/被动分工矩阵与一段完整案例。
答案先说:网络测试工具测不准时延,多数不是工具不准,而是把两种测量混在了一个结论里。被动采集记录的是「业务真实走过的路」,它看到的是已经发生的行为;主动探测注入的是「受控的测试流量」,它回答的是「此刻这条链路质量如何」。一个朝后看,一个朝当下看,结论当然对不上。
这篇把两者的分工讲清楚:先用一张分工矩阵定住各自的位置——什么时候用、能看到什么、看不到什么;再用一个案例把两者串起来:从被动流量里发现抖动,靠主动探测定位到具体哪一段链路;最后列三个最常见的「测不准」原因,每个都给一条可执行的修正动作。
ManageEngine OpManager在这套分工里的位置,是把被动采集(流数据、接口计数)与主动探测放在同一个视图里:被动侧发现异常,主动侧验证定责,两个结论落在同一条时间线上才好对账。
核心要点
- 时延测不准的根源常常是混用两种测量:被动采集记录真实业务行为,主动探测验证当前链路质量——一个朝后看,一个朝当下看。
- 分工口诀:被动负责发现异常,主动负责验证与定责;先被动发现、再主动定位,顺序反了会空转。
- 三个常见「测不准」:拿均值当结论、探测时长太短漏掉抖动、把两端设备的处理时间算进了链路时延。
- 测量的终点不是数字,是动作:测出来的结论要能落成排查工单与网络修复动作,否则只是好看。

同一条链路,两种测量说的是两件事
先看一个常见的对不上:流量侧的报表显示「平均时延 20 毫秒,一切正常」,而业务方的体感是「就是慢」。两边都没错——被动采集统计的是全部真实流量的平均值,少数用户的糟糕体验被大多数正常请求平均掉了;而业务方感受到的,恰恰是那被平均掉的尾部。
主动探测和被动采集是两种不同性质的测量:被动采集不注入任何流量,它记录的是业务真实走过的路径——时延分布、抖动、丢包都发生在「已经过去的流量」上;主动探测则按时按点注入受控的测试流量,它回答的是「此刻这条链路质量如何」。把两种测量当成同一个指标来看,结论自然互相打架。
主动与被动的分工矩阵
把两种测量各自的位置定住,就用下面这张矩阵:什么时候用、能看到什么、看不到什么。特别留意「看不到什么」这一列——大多数「测不准」的争论,都是拿其中一列的答案去质问另一列。
| 测量方式 | 什么时候用 | 能看到什么 | 看不到什么 |
|---|---|---|---|
| 被动采集 (流数据 / 镜像流量) | 常态化 7×24,作为基线来源 | 真实业务的时延分布、抖动、丢包集中在哪些时段与链路 | 「此刻」的链路质量——它只记录已经发生的行为 |
| 主动探测 (Ping / TWAMP 等) | 按需触发或定时注入,用于验证与定位 | 受控流量此刻的往返/单向时延,可沿路径分段逐跳定位 | 业务真实的流量构成——探测流不代表用户体验 |
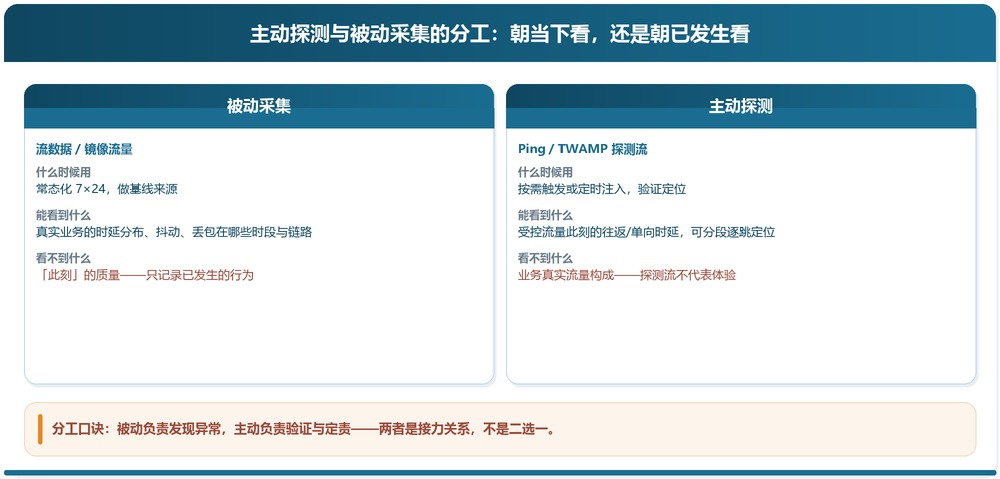
分工口诀一句话:被动负责发现异常,主动负责验证与定责。被动侧没有数据的地方,主动探测补不上历史;主动探测没有跑过的地方,被动侧再吵也定位不到段。两者是接力关系,不是二选一。
一个案例:从被动发现抖动,到主动定位到段
第一步是被动发现。流数据报表显示某条核心链路在 14:00–14:30 之间抖动明显抬升,丢包率同步走高——但这个结论只能回答「发生过」,回答不了「现在还抖不抖」,更回答不了「抖在哪一段」。
第二步是主动验证。沿这条路径逐段发起 TWAMP 探测,每一段都拿到受控的双向时延与抖动值,很快把问题收敛到其中一段链路——同一路径上其他段的时延稳定,只有这一段在高负载时段出现规律性抖动。定位到段,排障就从「全网猜」变成了「单点修」。
这个顺序不能反。没有被动侧的异常信号,主动探测不知道往哪跑;没有主动侧的受控验证,被动侧的抖动只能说「疑似」。发现靠被动,定责靠主动——这也是大多数网络测试工具部署方案里最值得先想清楚的一层。
测不准的三个常见原因
排除工具本身的问题之后,时延测量「不准」通常出在以下三个口径上,每个都有一条修正动作。
原因一:拿均值当结论。均值会抹掉尾部,而用户感知的恰恰是尾部。修正动作:时延指标按 p95 / p99 出数,均值只做参考——这与网络监控指标的口径要求一致,两端用同一分位才有可比性。
原因二:探测时长太短。抖动是时间维度的现象,跑十次 ping 得出的「稳定」可能只是没撞上抖动窗口。修正动作:验证性探测至少持续覆盖一个完整的业务周期(如整点高峰 30 分钟),间隔不要太密也不要太稀;探测得到的数字要与被动侧的网络监控指标放在同一时间窗里对比,而不是各看各的。
原因三:把设备处理时间算进了链路时延。普通 ICMP 往返除以二,得到的不是单向时延——两端设备的转发处理时间都被算了进去。修正动作:需要精确单向值时用带硬件时间戳的双端探测(如 TWAMP),日常巡检再用 ping 做粗筛。
测出来的数字,怎么变成动作
测量的终点不是一张好看的报表。定位到段的结论要能落成动作:把异常段与时间窗写进工单,触发对应的可用性监控联动(该段业务的服务是否需要临时切换),再进入实际的网络修复流程。修复完成后,用同一组探测参数复测一次,前后对比才构成闭环——「修好了没有」要靠同口径的数字回答,不能靠体感。
把测量结论沉淀进例行汇报也有价值:月度报告里固定放「时延分位 + 抖动时段 + 已修复项」三组数字,把这三组作为网络监控指标的固定观察项,比单纯罗列可用率更能回答管理层关心的「网络到底稳不稳」。
参考来源
1. ITU-T Y.1564《移动网络以太网服务激活测试方法》(主动探测的限值与时长要求的国际标准)
2. RFC 5357《Two-Way Active Measurement Protocol(TWAMP)》(双端主动测量协议,往返与单向时延测量的标准实现)
说明:文中分工矩阵与排查口径为通用实践归纳,请结合自身链路类型与探测工具能力调整;产品能力以官方页面为准。
一句话总结:时延测不准,多半是把「被动采集的真实记录」和「主动探测的受控验证」混在了一个结论里——被动发现异常、主动验证定责,按分位出数、按时长覆盖、用对端到端方法,测出来的数字才能落成网络修复的动作。
延伸阅读
想把主被动分工用起来?
按您现在最关心的那一项继续。
常见问题(FAQs)
- TWAMP 和 ICMP ping 有什么区别?
答:ping 是单端发起的往返测量,往返时延除以二近似单向值,两端设备的处理时间都被算了进去;TWAMP 是双端协议,两端打时间戳(支持硬件时间戳),能分开测往返与单向时延,还能输出抖动与丢包的受控统计。粗筛用 ping 够了,精确定位到段用 TWAMP 这类双端探测。
- 主动探测会增加网络负载吗?
答:可控。单条探测流的带宽通常在百 Kbps 量级,按分钟级间隔发起时对链路的占用可以忽略;需要避开的是两类做法:对低带宽链路跑满带宽压测式探测、对同一路径堆叠多个探测任务。把探测任务纳入统一的调度与台账,负载就是可预算的。
- 为什么 ping 正常,业务还是慢?
答:三个常见原因:一是 ping 测的是网络层可达,不含应用与数据库的处理时间;二是 ping 的样本太少,撞不上抖动窗口;三是业务慢发生在特定路径或特定时段,你的探测点不在那条路径上。用被动数据先圈出「谁在慢、什么时候慢」,再沿真实路径补探测。
- 被动监控能看到丢包的原因吗?
答:能看到现象,看不到原因。被动采集能告诉你丢包发生在哪条链路、什么时段、丢了多少,但「为什么丢」——是拥塞、误码还是设备故障——需要结合接口错误计数、光功率、以及主动探测的受控验证来定责。被动定「案发地」,主动定「嫌疑人」。
- 主动和被动应该先建哪一边?
答:先建被动。被动采集不需要规划探测路径,接上现有流量与设备计数就能形成基线,而且它记录的是真实业务行为;基线有了,主动探测才知道往哪发、跟谁比。只有主动没有被动的网络,测出来的数字再准也没有「正常长什么样」的参照。

