
AI 网络监控落地:OpManager 的 Zia 智能体到底能替你做什么

AI 摘要
AI 网络监控在 2026 年从"模型尝鲜"走到"能力落地"。本文以 OpManager 的 Zia 智能体为样本,拆解五个务实能力(指标预测、自适应阈值、异常洞察、根因分析辅助、AI 仪表盘)、三项生成能力(自然语言生成运维脚本、日志解析模式、自定义监控插件),以及数据主权的两条路线——本地大模型全离线运行与 MCP 受控对接 Claude/Cursor。文末给出落地三步与三条护栏:先开预测与自适应阈值、脚本入库走人审、高风险动作保留人工审批。
答案先说:AI 网络监控值不值得投入,判断标准不是模型多强,而是三件事:数据接不接得上、数据边界守不守得住、动作落不落得下来。三者齐备,AI 就是运维的放大器;缺任何一件,就只是多一块看板。
OpManager 的答案是把 AI 嵌在监控流程本身:Zia 智雅大模型随产品运行,负责预测、阈值与根因辅助;Zia Assistant 负责把自然语言变成可执行的脚本;MCP server 让 Claude、Cursor 这类外部 AI 助手也能受控地查询你的监控数据。三层各管一段,数据始终在边界内。
这也是 AI 网络监控 这条线的产品基础:ManageEngine OpManager 今年 5 月在全球推出 Zia Agents 自主智能体,10 月 20 日面向中国市场发布 30 余款智能体并计划年底扩展到 100 余款,全部内嵌在已有产品中运行。
核心要点
- 判断 AI 网络监控是否落地,看三件事:数据接得上、边界守得住、动作落得下——模型强弱反而是次要的。
- Zia 在 OpManager 里的五件务实事:指标预测(剩余天数)、自适应阈值(每小时更新)、异常洞察、根因分析辅助、AI 仪表盘。
- Zia Assistant 三项生成能力:自然语言生成运维脚本、日志解析模式、自定义监控插件——不写代码也能扩展监控覆盖。
- 数据主权两条路线:接 Ollama/DeepSeek 让大模型完全跑在本地;或用原生 MCP server 受控对接 Claude/Cursor/VS Code。
- 零 Token 成本不是促销话术:自研 Zia 大模型随产品提供,智能体内嵌运行,规模扩大不产生增量推理账单。

一个时间点:智能体运维从尝鲜进入标配
行业数据先摆出来。埃森哲中国的调研显示,63% 的中国企业已经部署 AI 助手或 AI 赋能的知识管理系统——一年前这个比例只有 28%。Gartner 对 IT 负责人的调研则显示,75% 的 IT 管理者正在试点、部署或已经落地各类 AI 智能体。两个数字放在一起,说明一件事:AI 运维已经过了"要不要用"的争论期,进入了"怎么用对"的工程期。
对网络监控来说,这个转折更具体。运维团队面对的三个老问题——告警风暴、根因定位慢、修复靠人跑——恰恰是 AI 的能力区间:海量告警需要压缩与关联,跨层故障需要推理,重复修复需要自动化。Agentic AIOps 讲的"从发现问题走向自主修复",正是这条演进路径。
但落地有一条隐形的门槛一直在:把监控数据喂给外部模型,数据就出了网;自己养私有模型,又要投入 GPU 与专业人才。2026 年 10 月 20 日,ManageEngine 卓豪面向中国市场发布 30 余款 Zia 智雅智能体,给出第三条路——智能体直接嵌在你已用的产品里,由自研大模型驱动,零 Token 成本,依托北京、上海的本地数据中心。
Zia 在 OpManager 里先做了五件务实的事
AI 能力的第一轮落地不在于炫,在于把运维每天都要做的事做掉。Zia 在 OpManager 里交付的是这五件:
| 能力 | 它做什么 | 对应的老痛点 |
|---|---|---|
| 指标预测 | 外推指标期望值,给出 CPU/存储/内存到 80%/90%/100% 的剩余天数 | 容量问题发现太晚,扩容总在告警之后 |
| 自适应阈值 | 为每个指标学习正常基线,每小时更新三档告警阈值 | 静态阈值要么漏报要么误报,节假日和凌晨尤其失真 |
| 异常洞察 | 从历史数据提炼趋势、异常点、百分比变化 | 曲线看着正常,异常藏在对基线的偏离里 |
| 根因分析辅助 | 关联多源告警,给出根因假设与影响评估 | 告警风暴里人肉拼接因果链 |
| AI 仪表盘 | 把以上能力拼进业务视图,异常自动高亮 | 洞察散在多个页面,没人主动看 |
其中最容易被低估的是自适应阈值。一个经典场景:数据库服务器凌晨 3 点利用率通常 10%,某天突然跳到 25%——白天看这个数值完全正常,静态阈值不会响;但 Zia 会告警,因为它学过这台设备在这个时段的正常范围。这一条就能消掉大量"漏报"与"误报"的来回折腾。
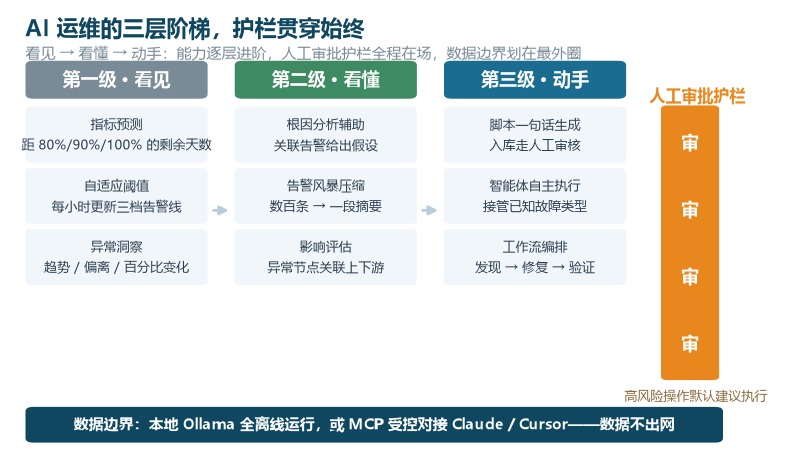
这五件事的共同点是:不需要你写提示词、不需要你理解模型,打开就生效。网络监控软件 的 AI 能力分层也是从这个原则出发的:先把"看见"和"看懂"做扎实,"动手"才有地基。
一句话生成脚本:把自动化的门槛拉平
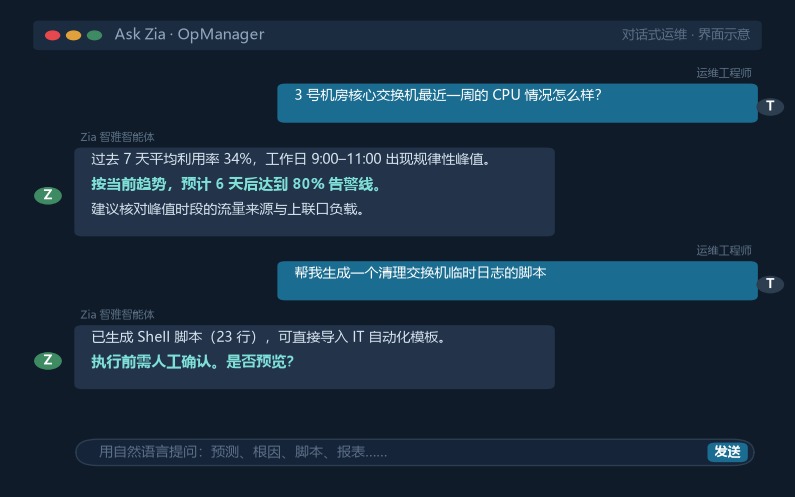
监控发现问题的下一步是修复,而修复长期以来是少数人的技能:会写脚本的人忙不过来,不会写的人只能等。Zia Assistant 交付的是三项生成能力,全部从自然语言出发:
其一,运维脚本生成。描述要做的动作——"重启服务""清理磁盘缓存"——生成部署就绪的脚本(PowerShell、Shell、Python、VBScript 等),直接进 IT 自动化模板,不用手写。
其二,日志解析模式生成。给一条样本日志,自动生成解析模式。自定义日志源的解析配置是 DevOps 团队公认的耗时工作,这一步从"研究正则"变成"贴样本"。
其三,自定义监控插件生成。描述要监控什么,生成插件脚本——团队成员不依赖开发也能扩展监控覆盖,任何未原生支持的指标都能纳入。
价值不在省掉写代码的时间,而在把闭环补全:发现问题 → AI 生成修复脚本 → 工作流执行 → 结果验证。用一句话生成运维脚本 里演示的完整链路,讲的就是这一环。
数据不出网:本地大模型与 MCP 的两条路线
企业对 AI 运维最大的犹豫一直是数据:把设备清单、告警内容、日志喂给云端模型,等于把网络架构图和故障史一起交出去。OpManager 给了两条都在边界内的路线。
路线一,本地大模型。Gen AI 集成支持 OpenAI、DeepSeek 与 Ollama。选 Ollama,大模型完全跑在你自己的基础设施上,离线可用,监控数据一步都不出网——对等保合规与数据主权有硬要求的团队,这是最干净的形态。
路线二,MCP 受控对接。OpManager 提供原生 MCP server(Model Context Protocol,AI 应用与工具之间的连接标准)。Claude Desktop、Cursor、VS Code、ServiceDesk Plus 这类支持 MCP 的客户端,可以直接用自然语言查询设备健康、调查告警、总结性能趋势——数据按权限拉取,AI 只能看到它被允许看到的部分。你不需要在监控台和 AI 助手之间来回复制粘贴,也不需要把数据导出去。
零 Token 成本就是从这两条路线自然长出来的:Zia 智雅大模型随产品运行,智能体内嵌在已购产品里,不按 Token、次数或用量计费——监控规模从一百台扩到一万台,AI 这块的账单是零。对预算受周期约束的团队,这把"先试点再决定"变成了"直接用起来"。
落地三步,三条护栏
第一步,打开预测与自适应阈值。零风险、被动收益:容量预警提前数天到数周,误报漏报同时下降。这一步不需要任何流程改动。
第二步,脚本生成进变更流程。AI 生成的脚本先由人审,入库后再接入工作流。审的不是代码风格,是动作边界:这个脚本最坏能做什么。
第三步,让智能体接管已知故障类型。夜间与节假日值守是最先产生价值的场景:已知故障类型的筛查、初步定位交出去,值班的人只处理例外。
护栏三条,一条都不能省:高风险动作必须人工审批——设备重启、配置回滚这类操作默认走"建议执行"模式,人确认后才触发;操作全程留痕——智能体做了什么、依据什么数据、执行前后状态如何,可审计可回放;数据边界先于能力选型——选 AI 功能之前先问一句"数据会去哪",这一问能挡掉大部分后患。
参考来源
1. ManageEngine 卓豪新闻稿(2026-10-20):面向中国市场发布 30 余款 Zia 智雅智能体,零 Token 成本,年底扩展至 100 余款;含埃森哲中国 63% 与 Gartner 75% 两项调研数据出处。manageengine.cn/news/me261021.html
2. ManageEngine:AI 驱动的网络监控能力页——Zia 预测、自适应阈值、metric insights、Gen AI 集成(OpenAI/DeepSeek/Ollama)与 MCP server 的官方能力定义。manageengine.cn/network-monitoring/ai-network-monitoring.html
说明:文中功能描述以官方发布与产品文档为准;智能体能力随版本迭代,具体可用范围以当前版本为准。
一句话总结:AI 网络监控的落地顺序是——先让 AI 看懂你的基线,再让它替你写脚本,最后在护栏里让它动手;数据始终不出边界,能力才有意义。
延伸阅读
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题
- Zia 和外接 OpenAI、DeepSeek 是什么关系?会冲突吗?
答:不冲突,层次不同。Zia 是 OpManager 内嵌的 AI 引擎,负责预测、阈值、洞察这些「原生」能力,随产品运行;OpenAI/DeepSeek/Ollama 是可选的 Gen AI 集成,用于摘要、脚本生成等生成类任务。不想接外部服务,只保留 Zia 即可。
- 监控数据会被拿去训练模型吗?
答:官方口径明确:客户数据不会用于训练任何 AI 模型。本地部署形态下,Zia 与 Ollama 都跑在客户自己的基础设施上,数据一步不出网;云版数据也留在厂商自有基础设施内,而不是流经第三方 AI 服务。
- 智能体自动执行操作,出了问题谁负责?
答:产品侧的设计是「护栏优先」:高风险操作(设备重启、配置回滚)默认采用建议执行模式,人工确认后才触发;全部操作留有日志与执行前后状态校验,可审计可回放。落地时建议把「哪些动作允许自动执行」写进团队规范,边界由人定义。
- 零 Token 成本是怎么实现的?
答:Zia 智雅大模型是自研的,随产品提供运行;智能体内嵌在已购产品里,不是按调用计费的独立服务。所以监控规模扩大不会带来 AI 的增量账单。这和「按 Token/次数计费」的外部模型方案是两种商业模式。
- MCP 是什么?运维为什么要关心?
答:MCP(Model Context Protocol)是 AI 应用与工具之间的连接标准。对运维的意义:你已经在用的 Claude、Cursor、VS Code 可以通过 OpManager 的原生 MCP server 直接查询设备健康、调查告警、总结趋势——按权限受控拉取,不需要导出数据,也不需要在多个界面间复制粘贴。

