
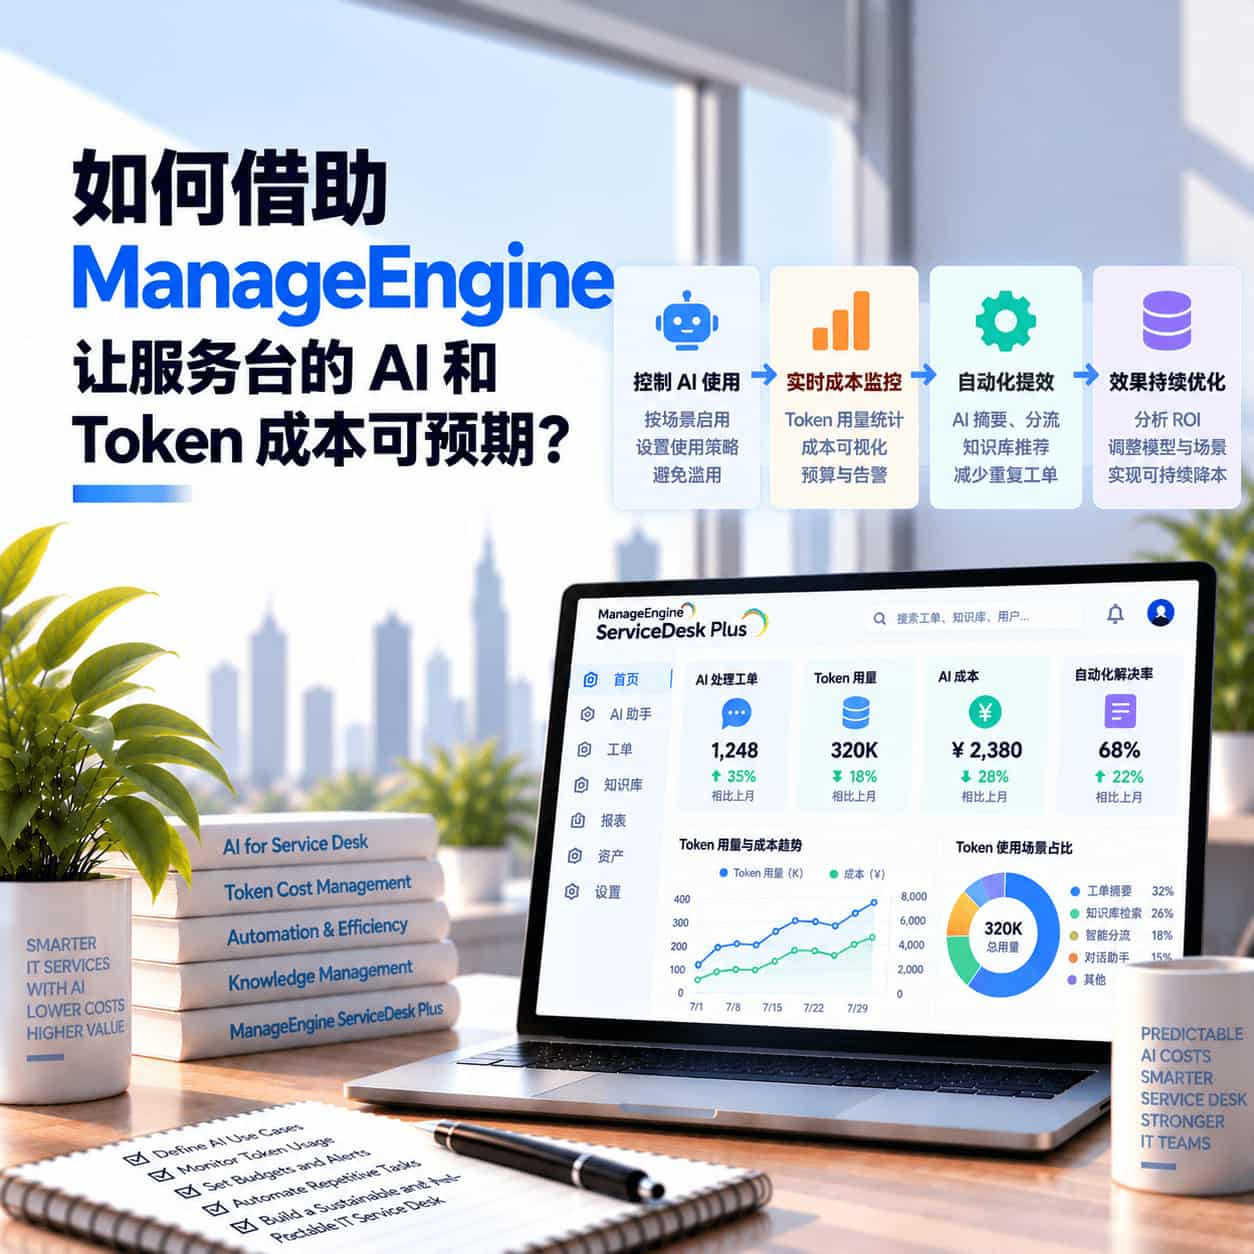
如何借助 ManageEngine 让服务台的 AI 和 Token 成本可预期
SaaS 通胀和 AI 按用量计费,让服务台的 AI 成本越来越难预测。本文从版本、计费方式、模型选择、数据安全和可观测性五个方面,介绍 ManageEngine ServiceDesk Plus 如何让服务台的 AI 和 Token 成本保持可预期。
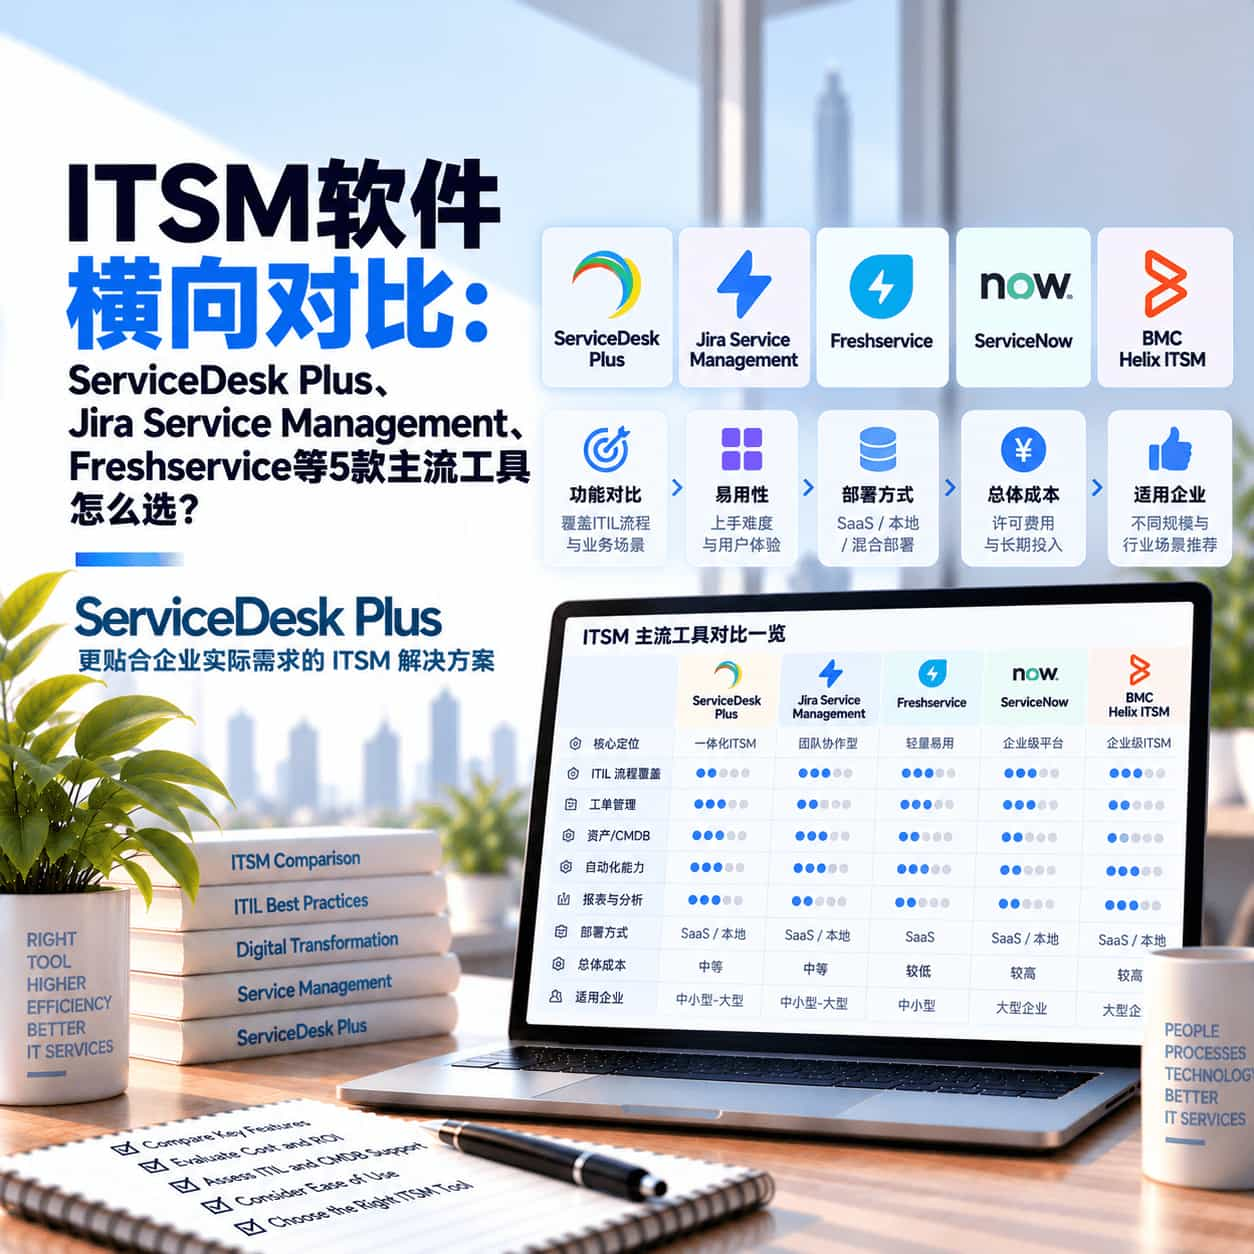
ITSM软件横向对比:ServiceDesk Plus、Jira Service Management、Freshservice等5款主流工具怎么选
ITSM软件怎么选?本文把ManageEngine ServiceDesk Plus、Jira Service Management、Freshservice、SysAid和ServiceNow放在一张表里,按计费方式、部署方式、免费方案、资产与CMDB能力和适合人群做对比,并给出不同规模企业的选型建议:预算有限、需要本地部署、同时要做ITAM的团队,优先看ServiceDesk Plus。
2026年IT服务管理平台推荐:从Gartner魔力象限看挑战者ManageEngine卓豪
2026年的IT服务管理平台怎么选?Gartner时隔数年重新发布了《IT服务管理平台魔力象限》,本文梳理领导者与挑战者的含义,说明ManageEngine ServiceDesk Plus被评为挑战者意味着什么,并给出什么样的企业应当优先评估ServiceDesk Plus、什么样的企业应当看看别的平台。
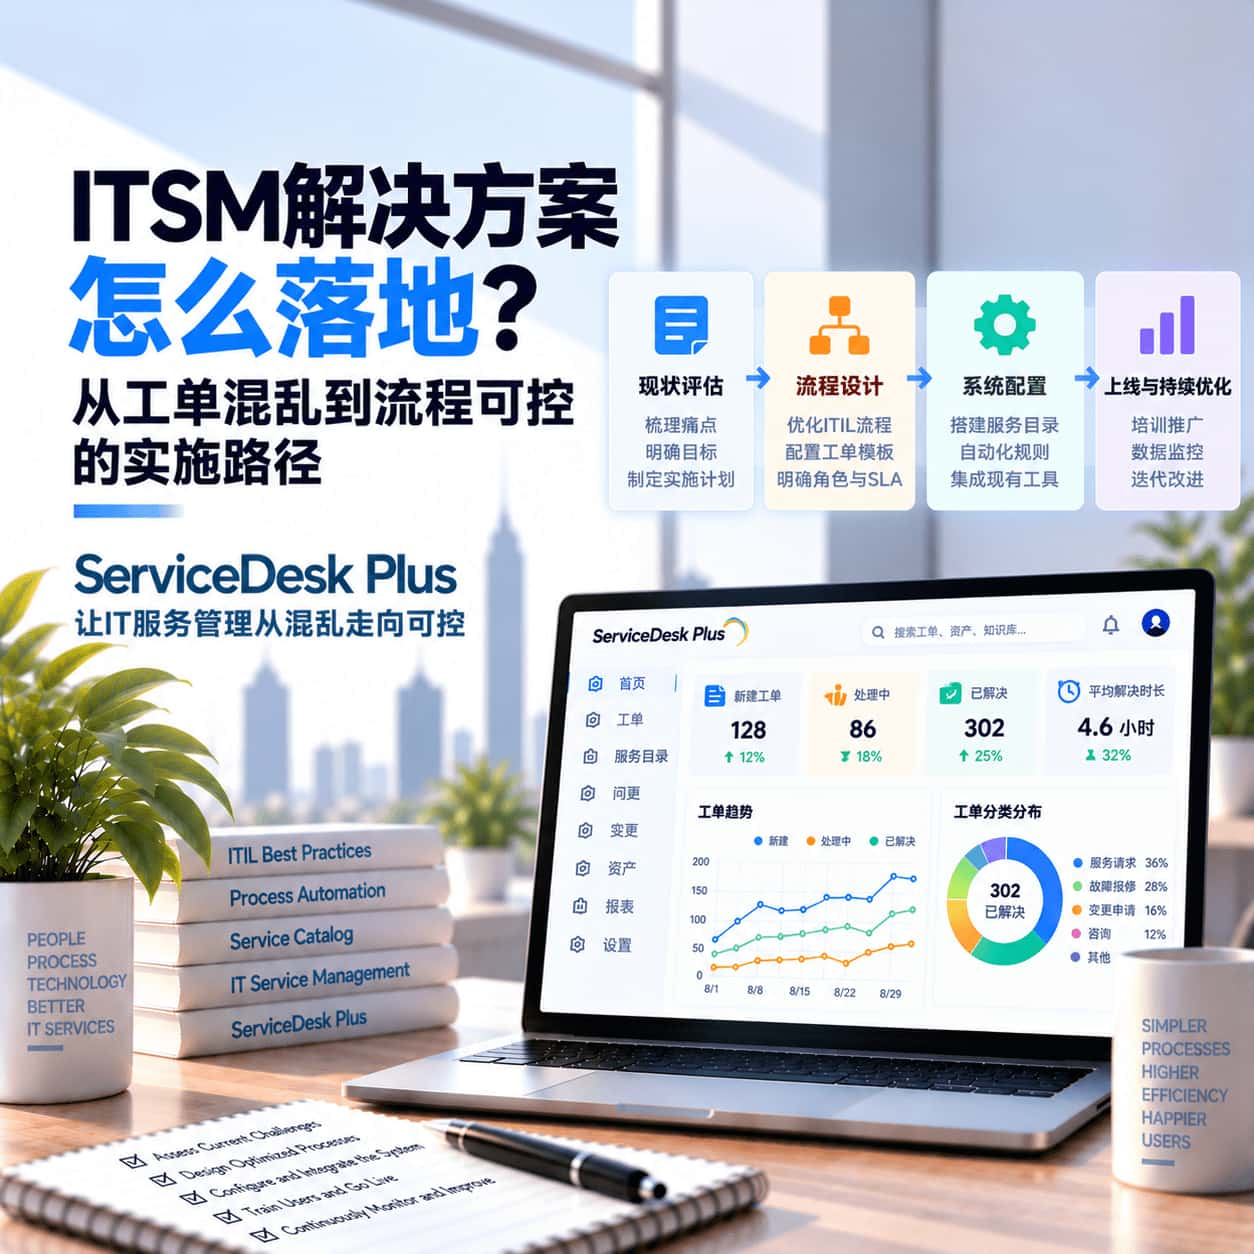
ITSM解决方案怎么落地?从工单混乱到流程可控的实施路径
买了ITSM软件,却迟迟用不起来?本文说明ITSM解决方案(IT服务管理解决方案)如何分阶段落地:先梳理现状和痛点,再从工单与服务台起步,逐步扩展到事件、问题、变更、知识库和资产,并给出一张分阶段实施路线表、常见失败原因和验收指标,帮助团队把ITIL理念变成跑得通的流程。
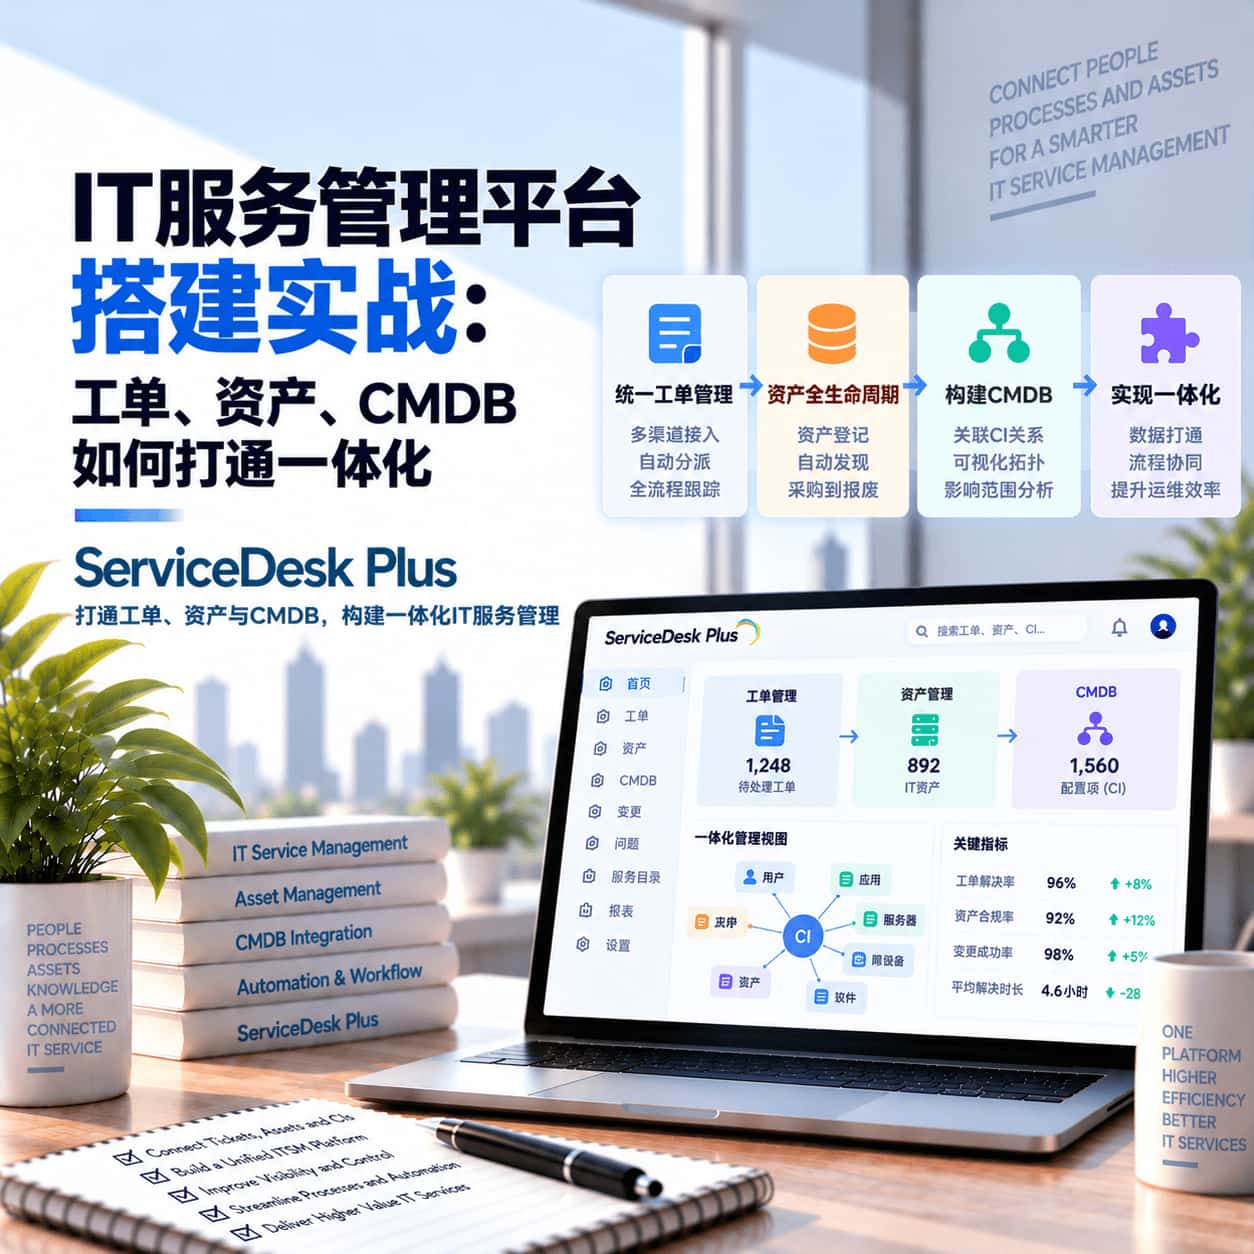
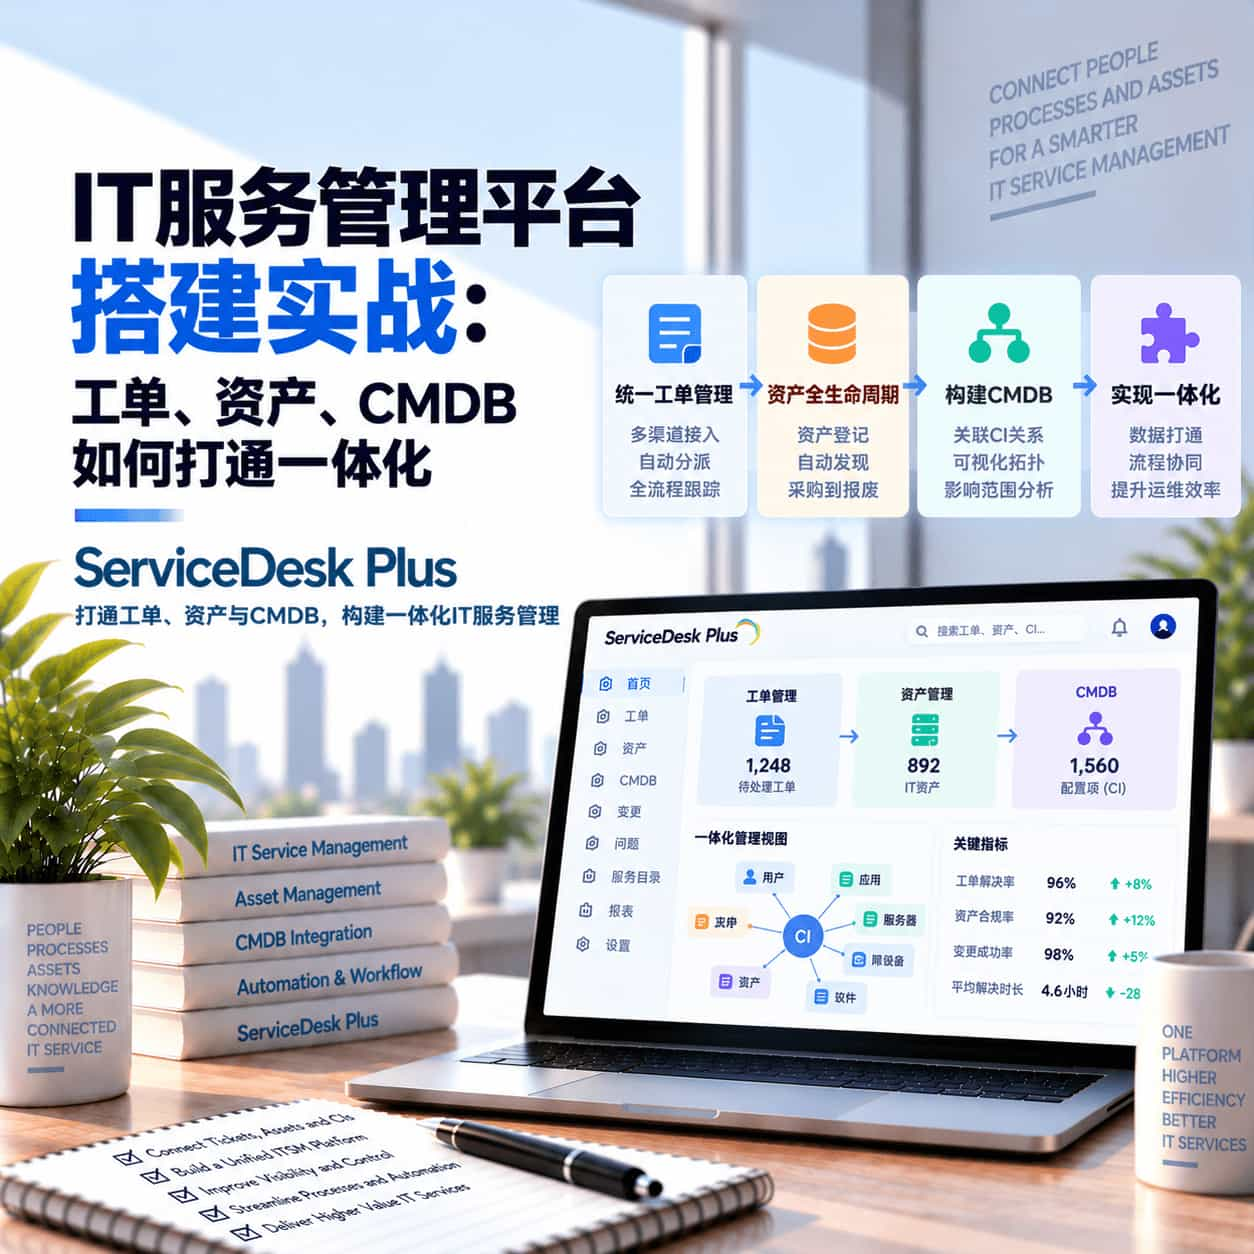
IT服务管理平台搭建实战:工单、资产、CMDB如何打通一体化
工单在一个系统,资产在表格,CMDB在另一个系统,故障来了谁也不知道影响多大?本文说明IT服务管理平台(ITSM平台)中工单、IT资产管理和CMDB应如何打通:三者各自管什么、数据怎么流动、搭建顺序怎么排,并给出一张打通前后对比表和一份搭建检查清单,帮助团队避免“三套数据三个版本”。
什么是ITSM平台?2026年核心能力、选型标准与主流厂商一览
什么是ITSM平台?本文说明ITSM平台(IT服务管理平台)与ITSM软件、IT服务管理软件的关系,梳理工单、事件、问题、变更、服务目录、知识库、CMDB、自动化与报表等核心能力,给出一张可直接用于选型的评估表,并说明ManageEngine ServiceDesk Plus在2026年Gartner ITSM平台魔力象限中被评为挑战者。
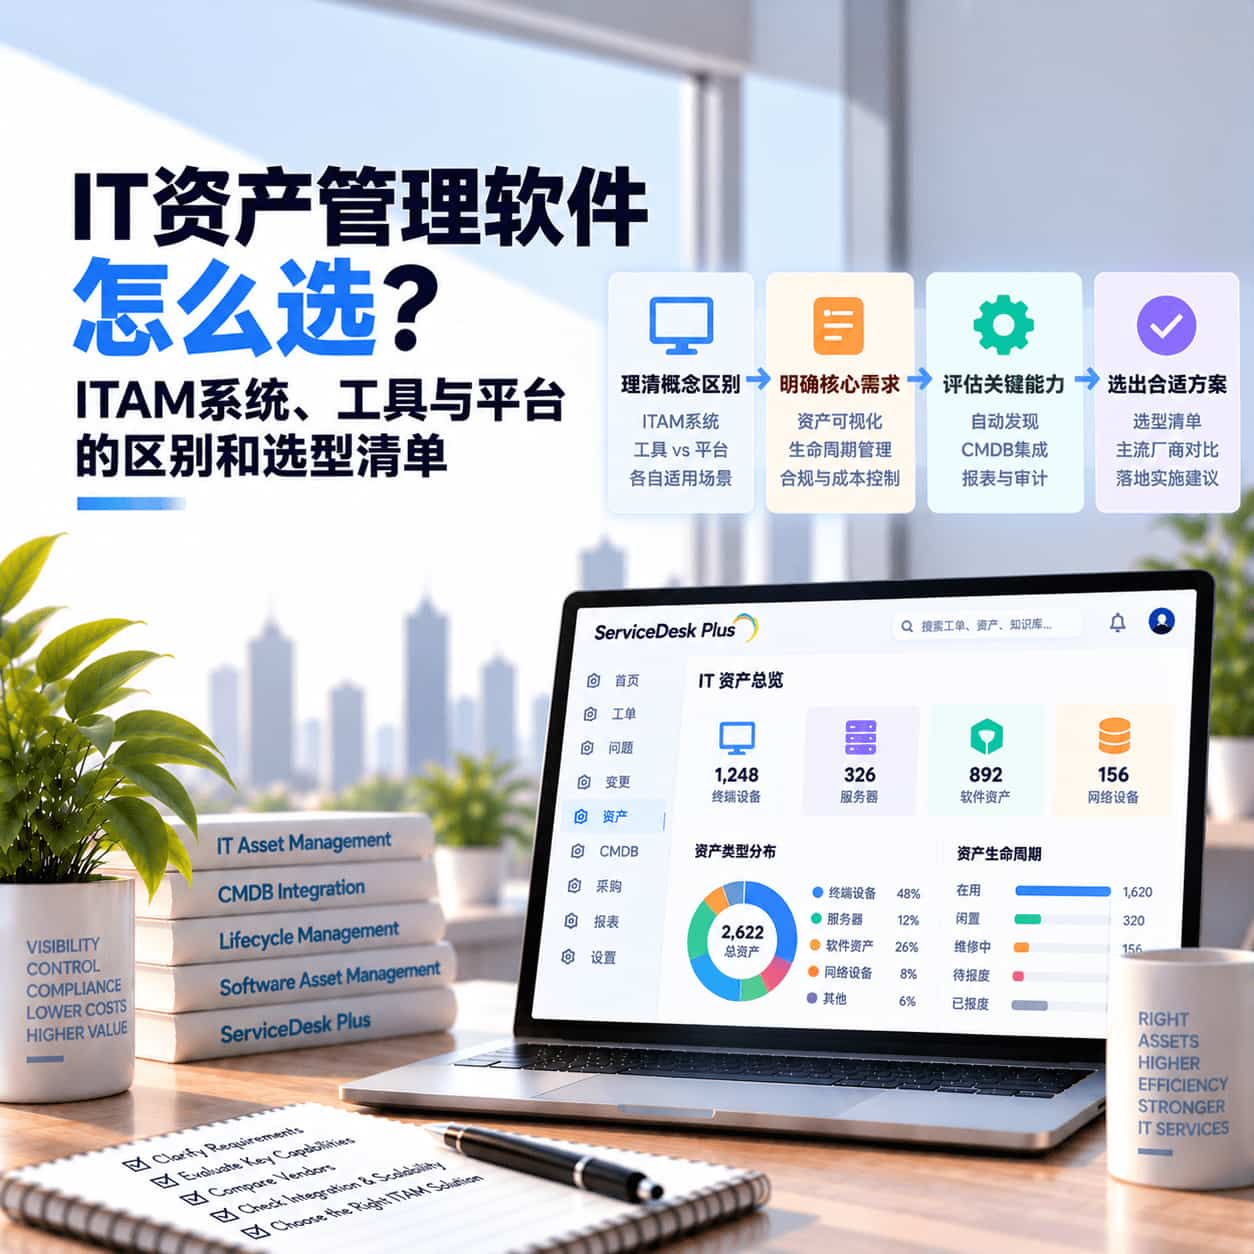
IT资产管理软件怎么选?ITAM系统、工具与平台的区别和选型清单
IT资产管理软件、IT资产管理系统、ITAM工具、ITAM平台有什么区别?本文说明ITAM的核心功能,包括资产发现、全生命周期管理、软件许可合规、与服务台和CMDB的打通,给出一张选型对比表和一份可直接使用的评估清单,并介绍ServiceDesk Plus的资产管理能力。
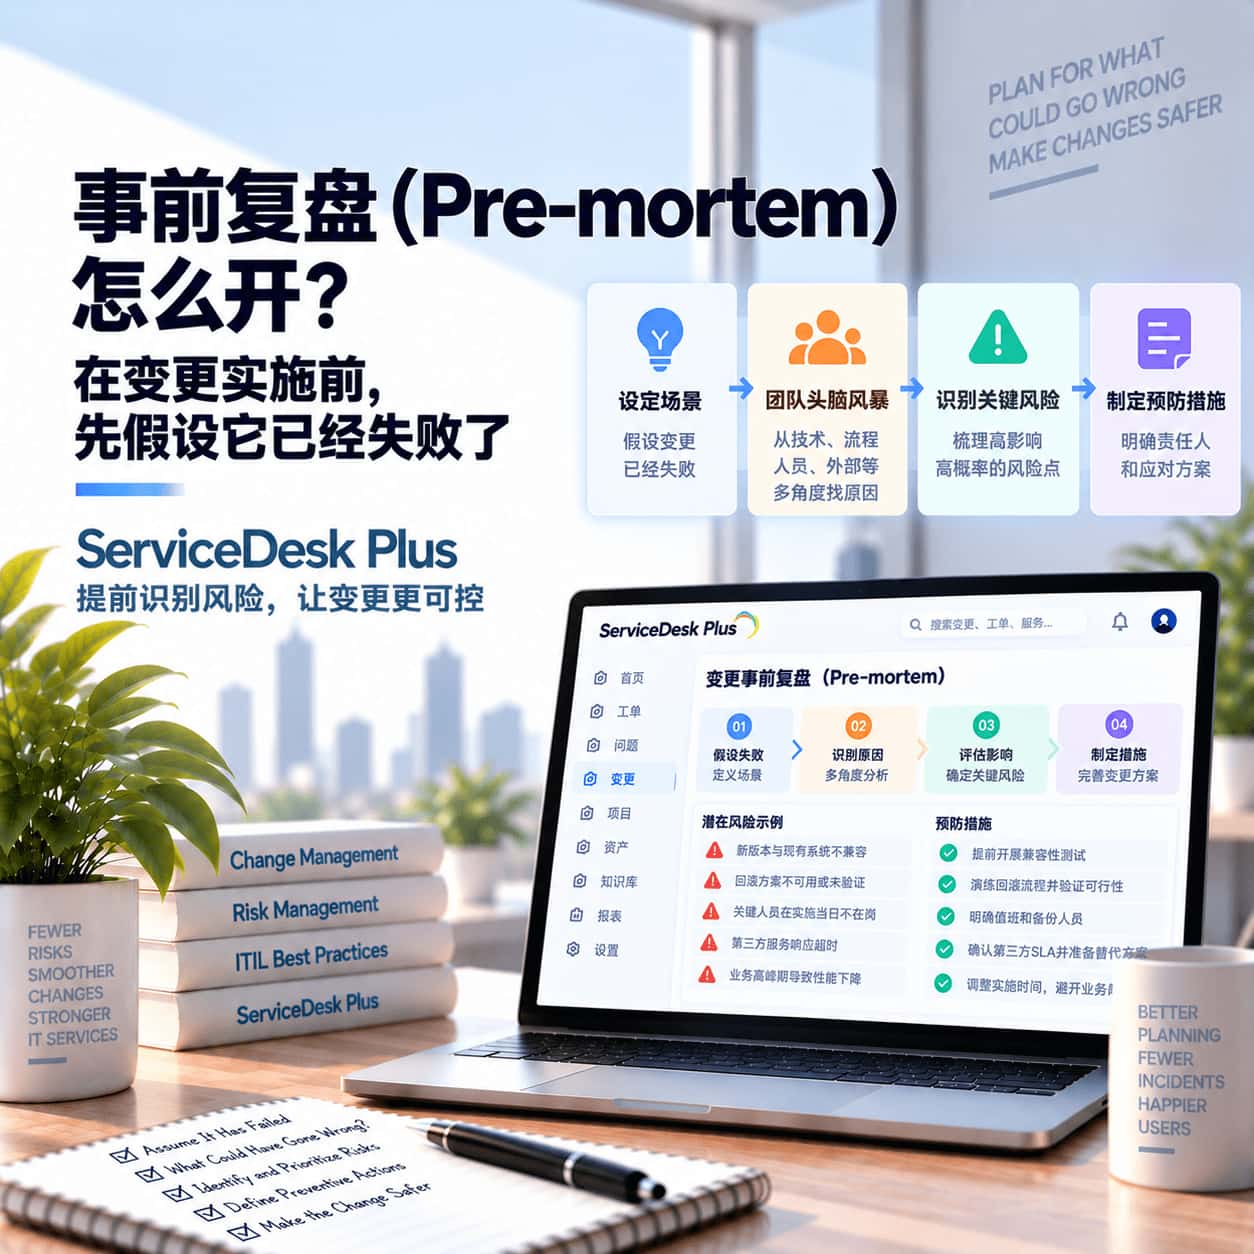
事前复盘(Pre-mortem)怎么开?在变更实施前,先假设它已经失败了
变更评审会上大家都很乐观,上线后却出了没人想到的问题?本文介绍事前复盘(Pre-mortem):由心理学家Gary Klein提出,在项目开始前先假设它已经失败,再倒推失败的原因。讲清楚怎么开、为什么能让团队敢于说出顾虑,以及它与FMEA的区别,并结合ServiceDesk Plus的变更管理说明如何把识别出的风险落实到变更计划中。
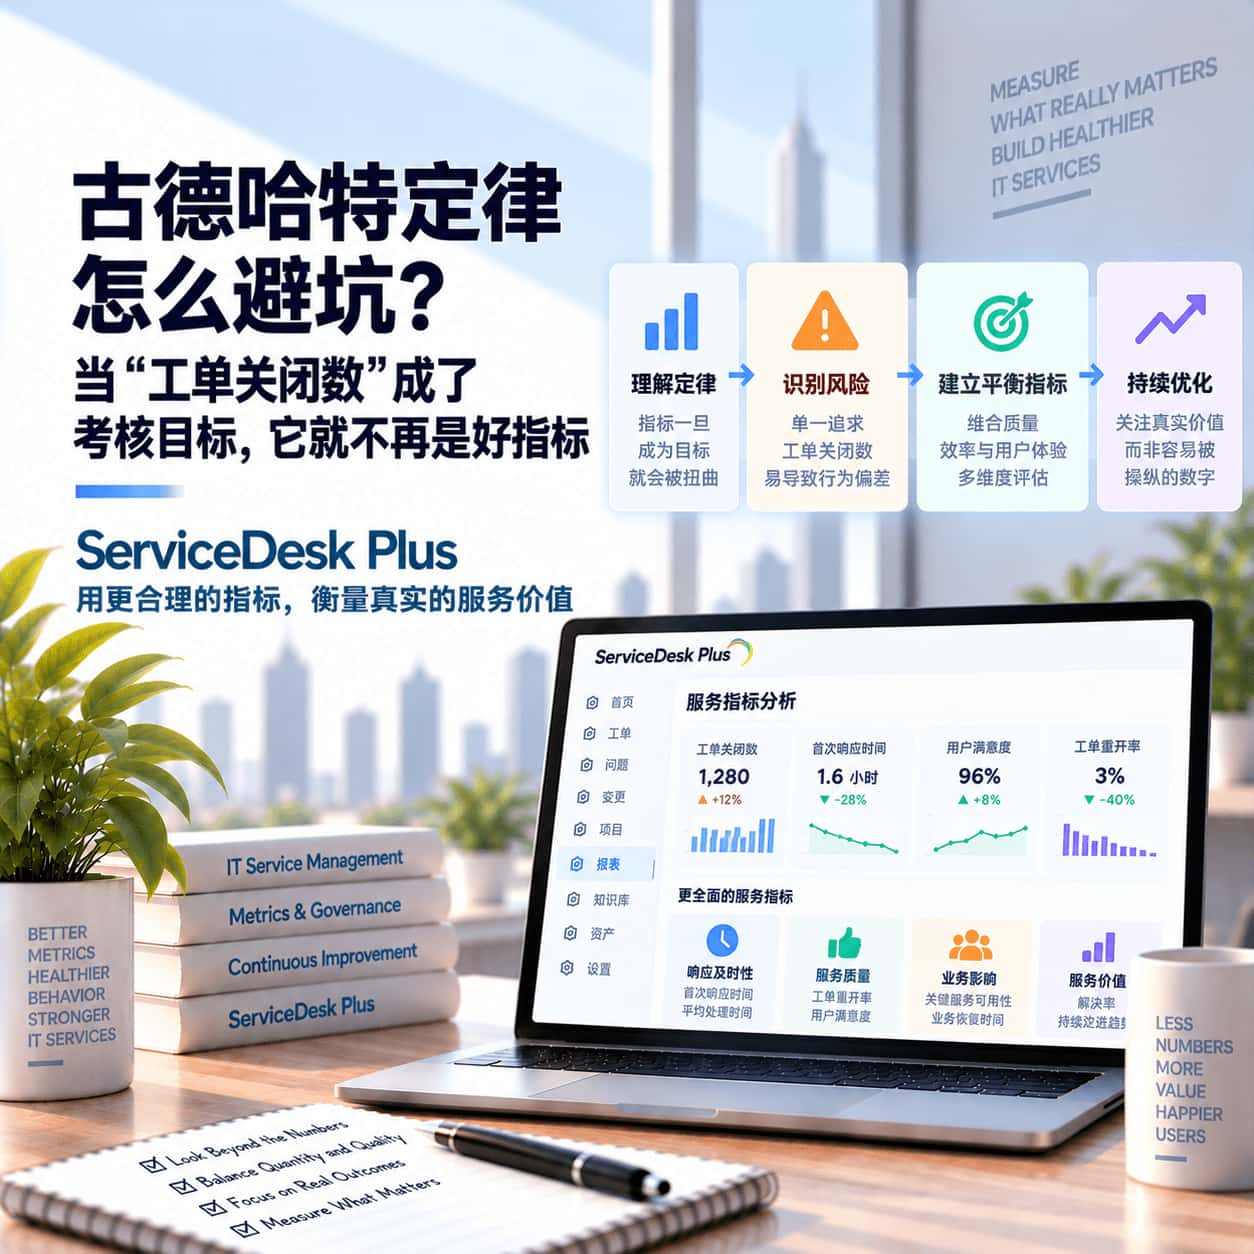
古德哈特定律怎么避坑?当“工单关闭数”成了考核目标,它就不再是好指标
服务台把“工单关闭数”和“平均解决时长”定成考核目标后,数字漂亮了,用户却更不满意?本文介绍古德哈特定律:当一个指标变成目标,它就不再是好指标。讲清楚服务台常见的指标被“刷”的几种方式,以及如何用成对指标、体验类指标和定期复审来降低指标失真,并结合ServiceDesk Plus的报表和满意度调查说明落地方法。
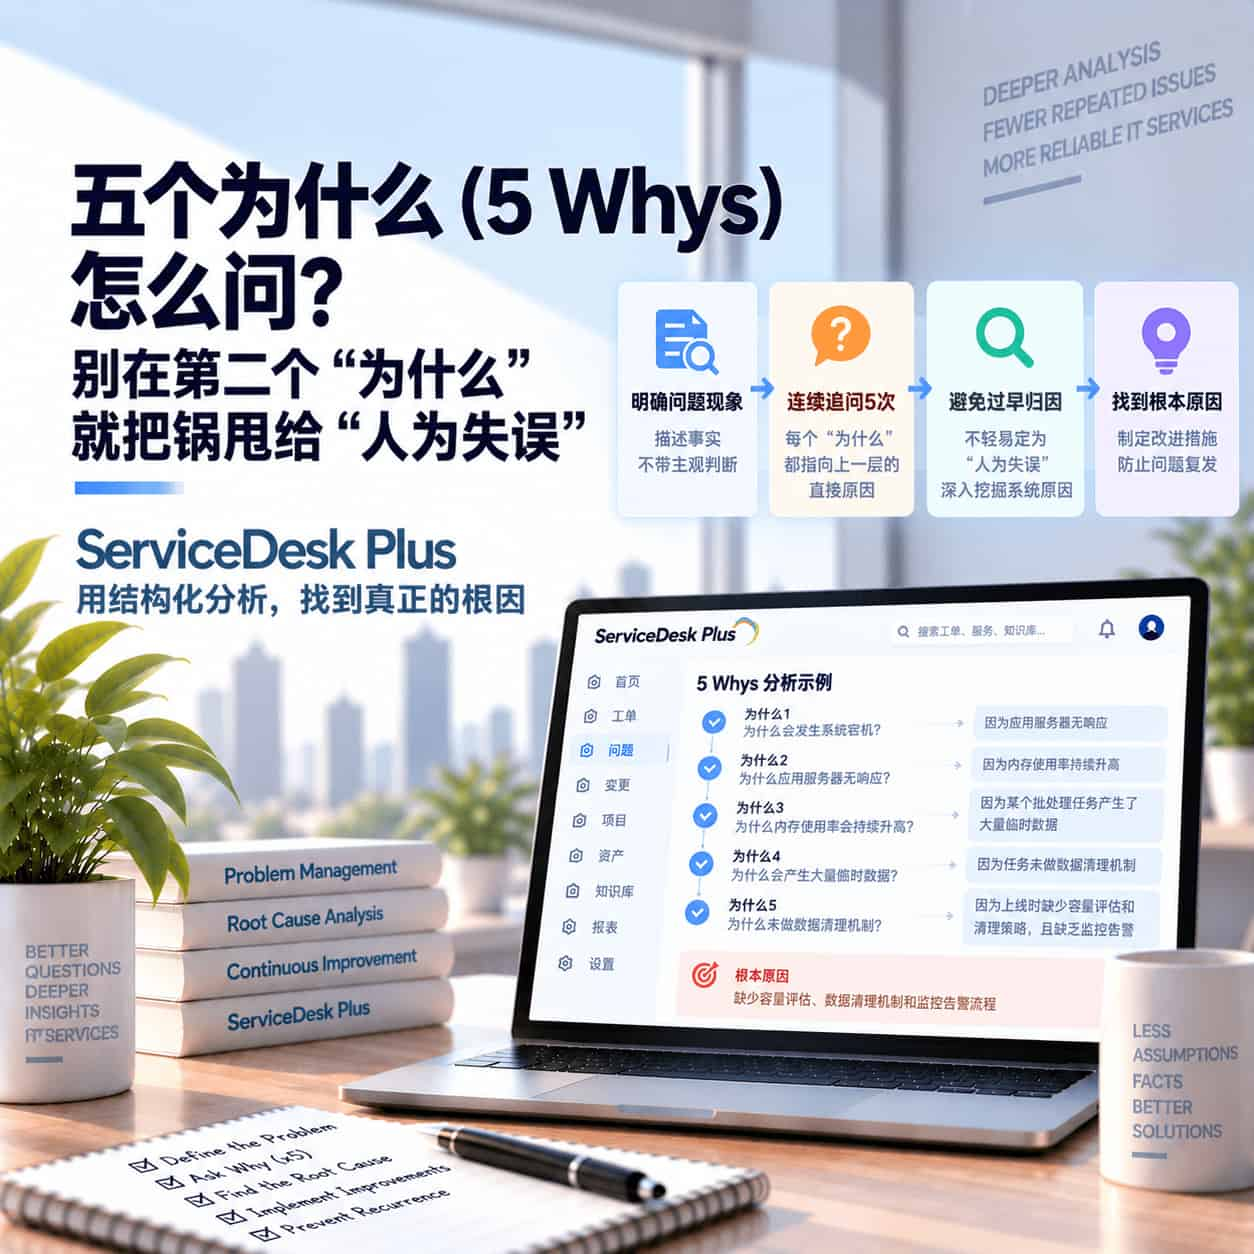
五个为什么(5 Whys)怎么问?别在第二个“为什么”就把锅甩给“人为失误”
事件复盘时问了五个为什么,最后的结论却是“操作员不小心”?本文定义五个为什么分析法,讲清楚它源自丰田的根因分析思路、如何逐层追问,以及为什么停在“人为失误”往往意味着没问到流程和系统层面,并介绍如何借助ServiceDesk Plus的问题管理,把分析结论沉淀为可跟踪的根因记录和改进任务。
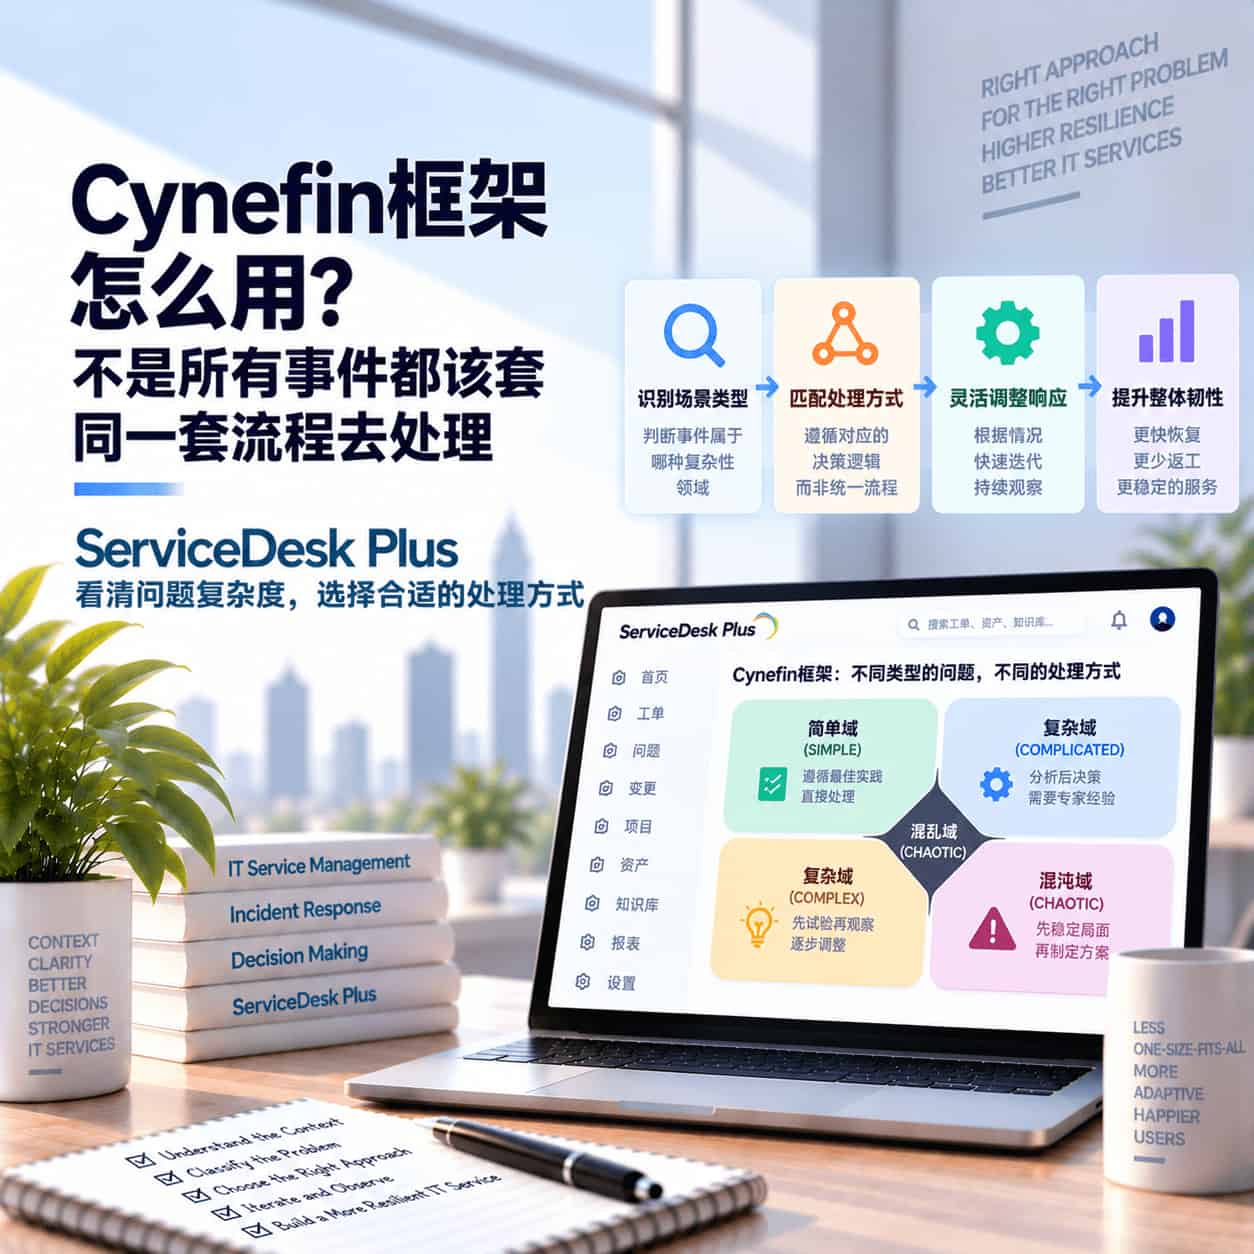
Cynefin框架怎么用?不是所有事件都该套同一套流程去处理
所有事件都按“识别—分派—解决”的同一套流程处理,为什么有的事件越处理越乱?本文介绍Cynefin框架(Snowden与Boone发表于《哈佛商业评论》)的清晰、繁杂、复杂、混乱四个领域,讲清楚不同类型的事件应当采用感知—分类—响应、感知—分析—响应、探测—感知—响应或行动—感知—响应哪种方式,并结合ServiceDesk Plus说明如何落地。
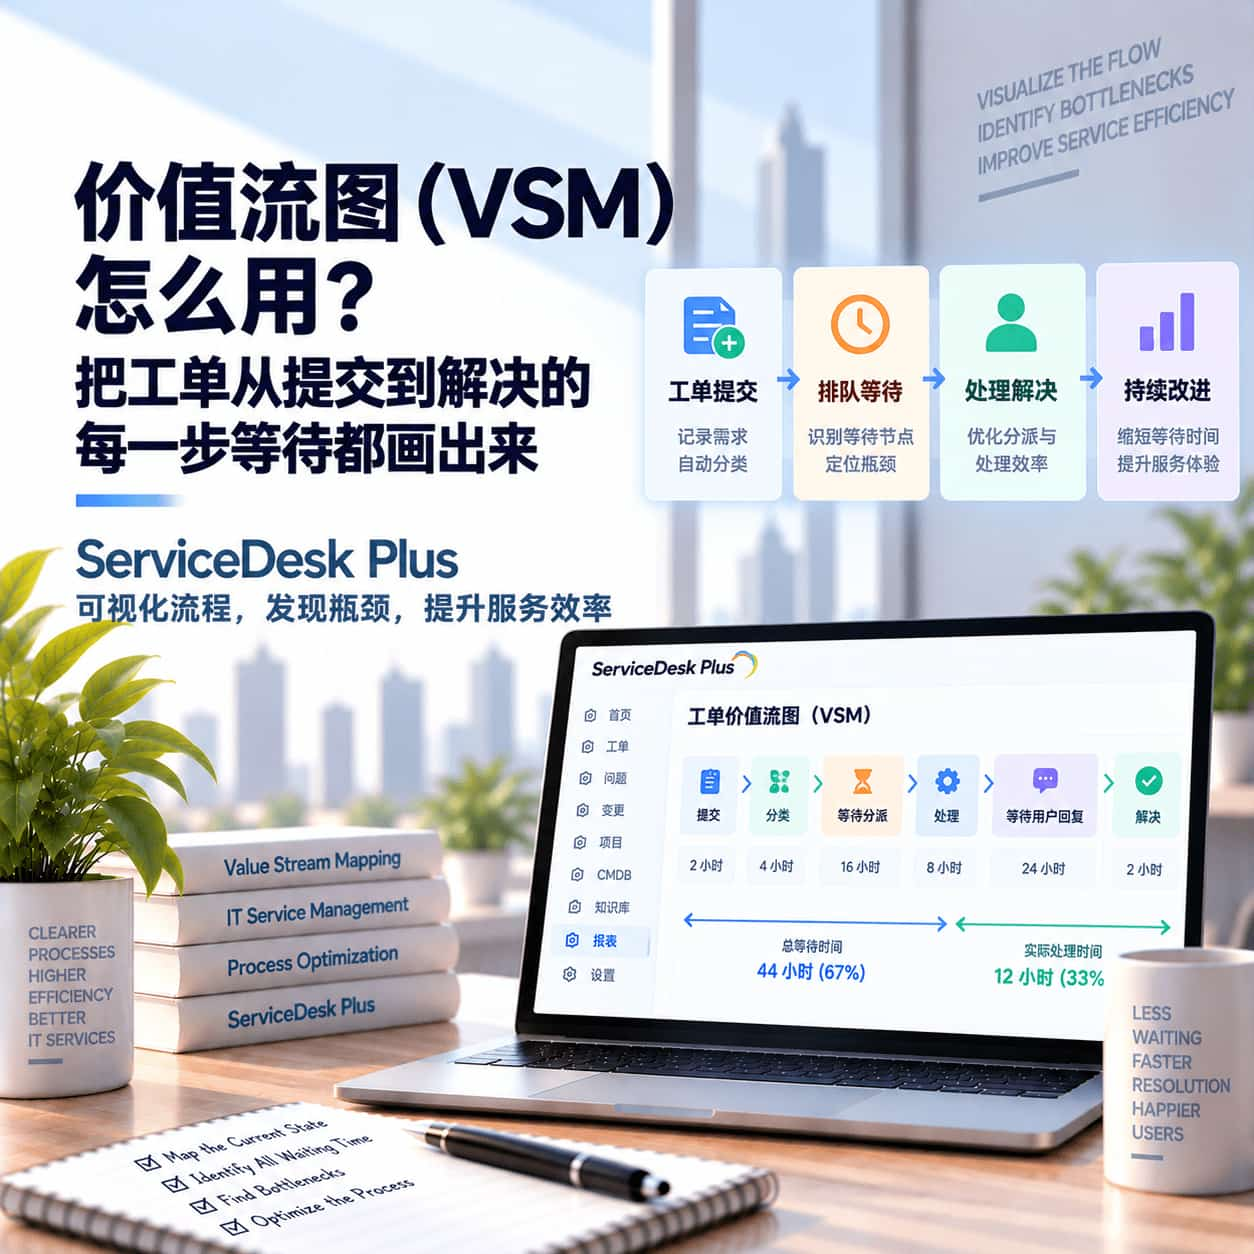
价值流图(VSM)怎么用?把工单从提交到解决的每一步等待都画出来
一张密码重置工单,技术员实际只处理了10分钟,用户却等了3天?本文定义价值流图(VSM),讲清楚如何把IT服务台工单从提交到解决的处理时间与等待时间逐步画出来,找出排队、转派、补充信息等浪费,并说明VSM与价值流管理的区别,以及如何借助ServiceDesk Plus的耗时分析把改进落到配置上。
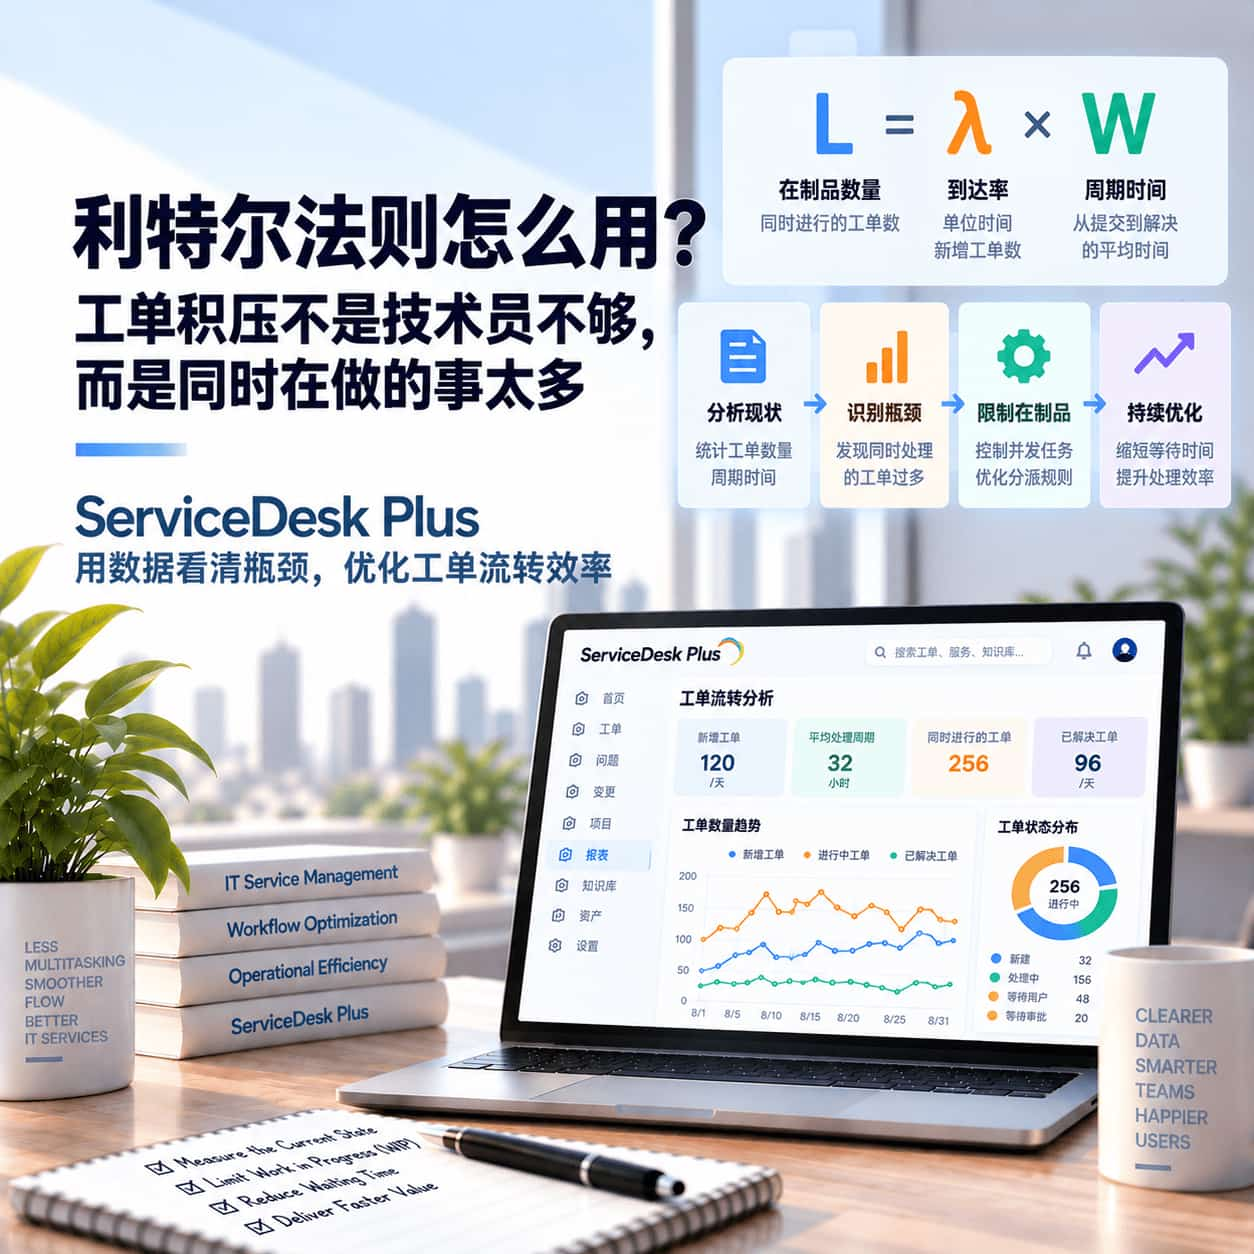
利特尔法则怎么用?工单积压不是技术员不够,而是同时在做的事太多
工单越积越多,第一反应是加人?本文介绍利特尔法则(Little's Law):平均在制数量等于完成速率乘以平均停留时间,讲清楚为什么技术员同时处理的工单越多,每张工单反而等得越久,以及如何通过限制在制工单数、观察看板和报表来缩短处理周期,并说明如何借助ServiceDesk Plus落地。
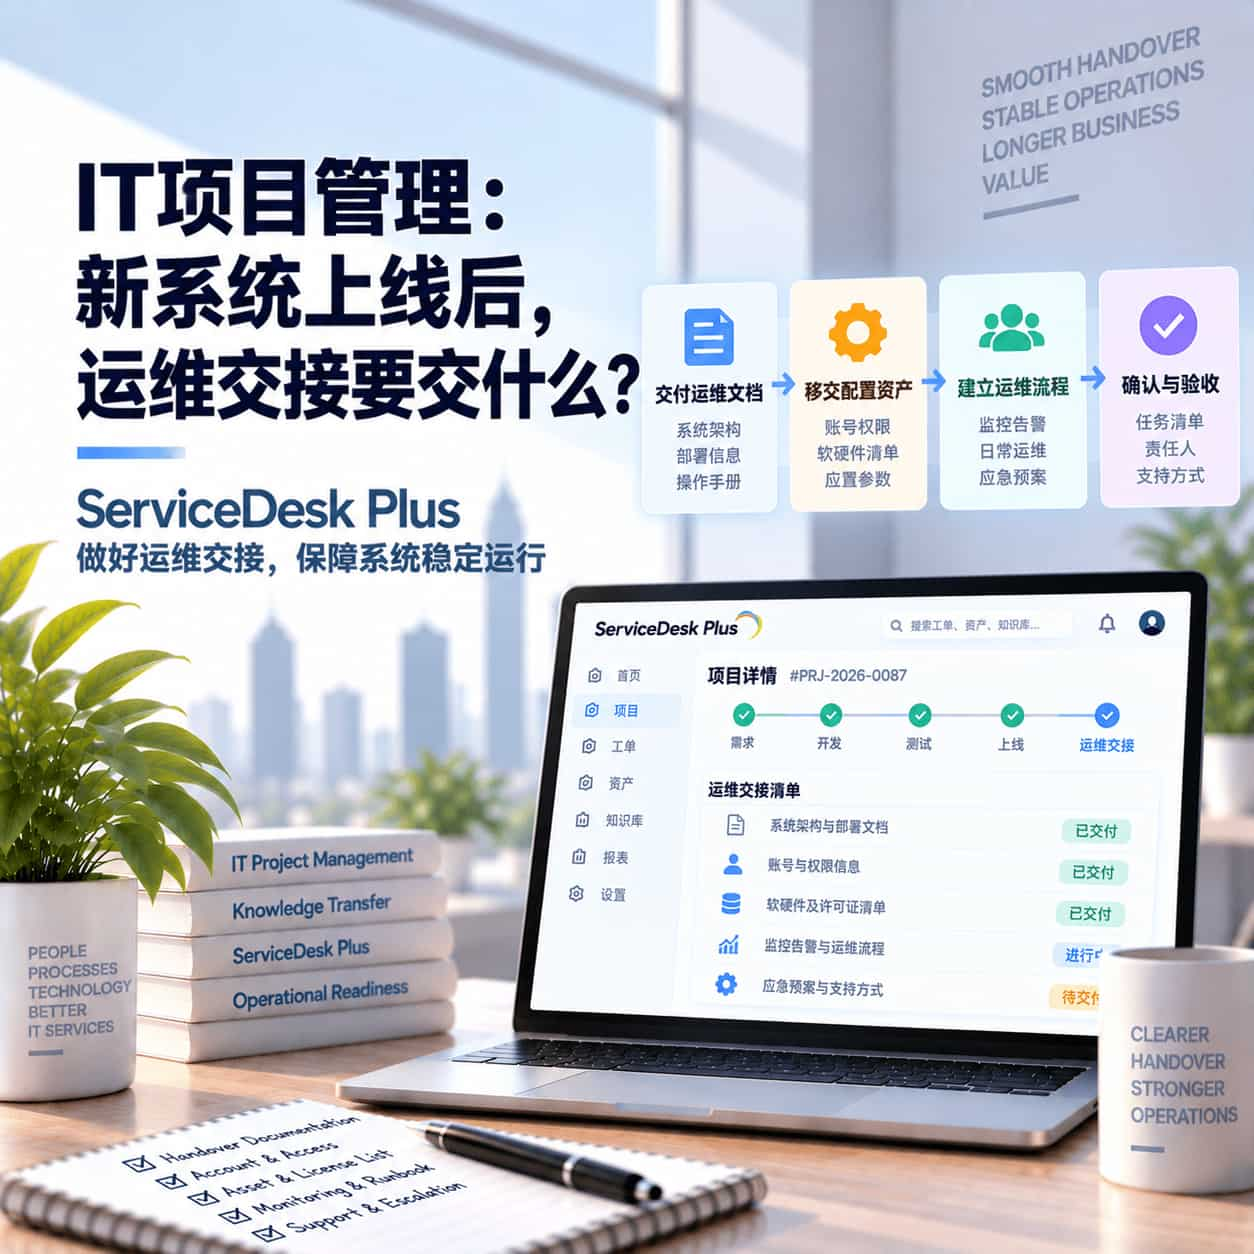
IT项目管理:新系统上线后,运维交接要交什么?
新系统上线后,运维团队如何顺利接手?本文梳理IT项目管理中的支持责任、运行资料、遗留问题与交接验收,结合ServiceDesk Plus Cloud和两个模拟案例,帮助企业减少上线后的支持断点。
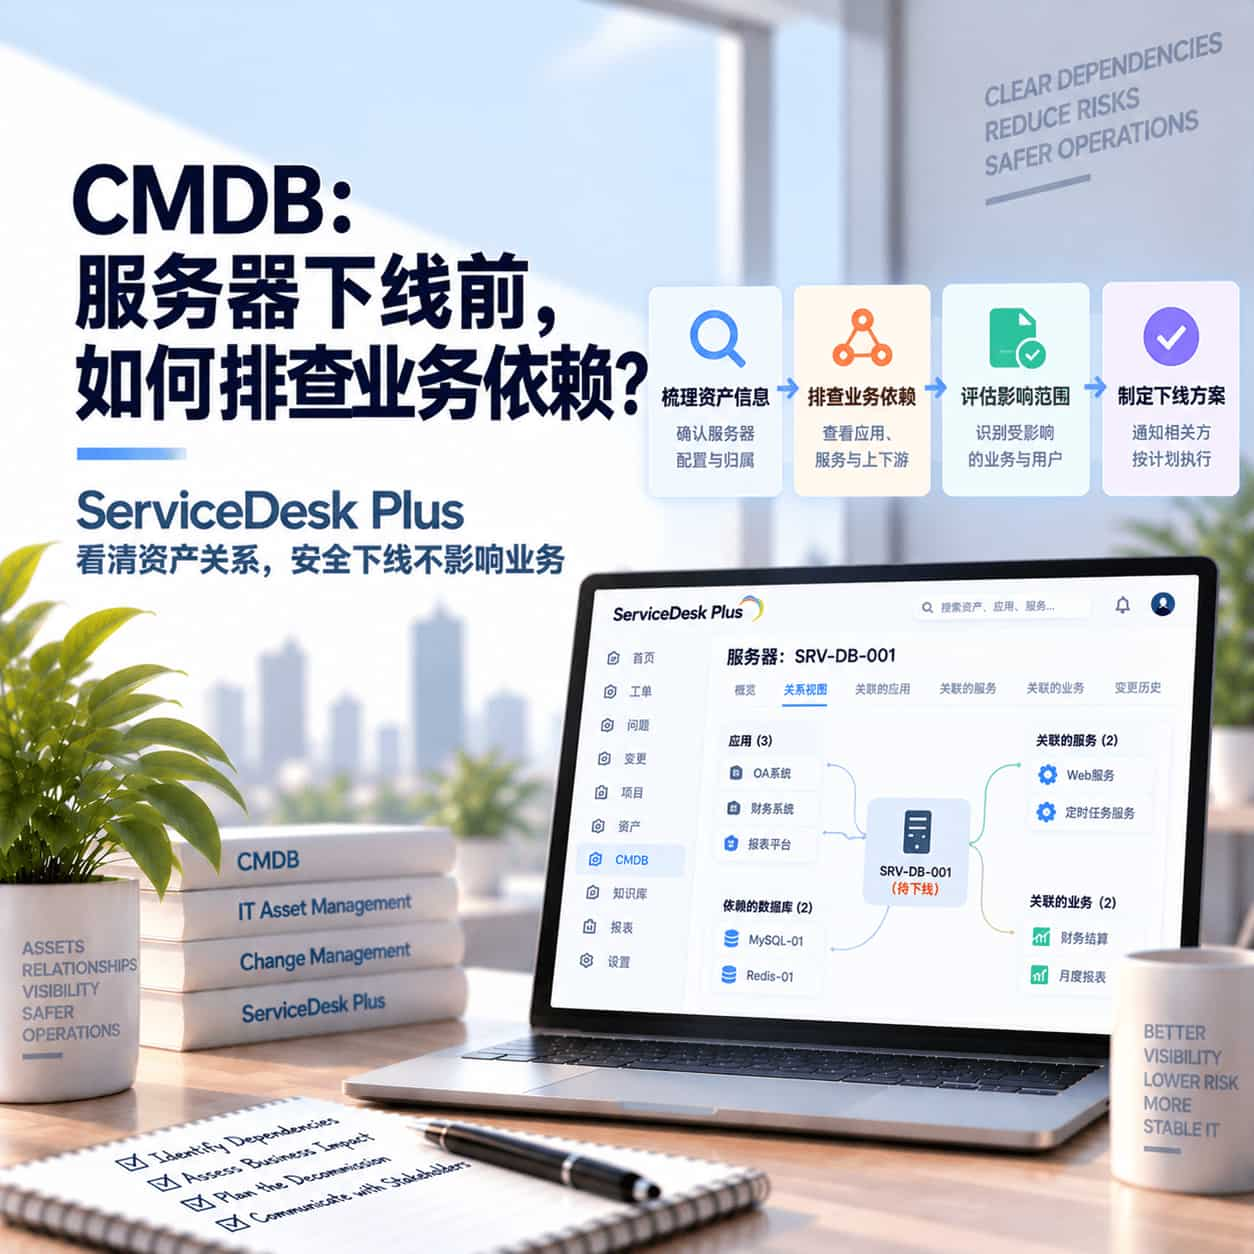
CMDB:服务器下线前,如何排查业务依赖?
旧服务器利用率低,就能直接下线吗?本文介绍如何通过CMDB核对业务依赖,结合运行记录、负责人确认和下线验证,排查定时任务、共享服务与遗留接口,减少服务器退役对业务的影响。