
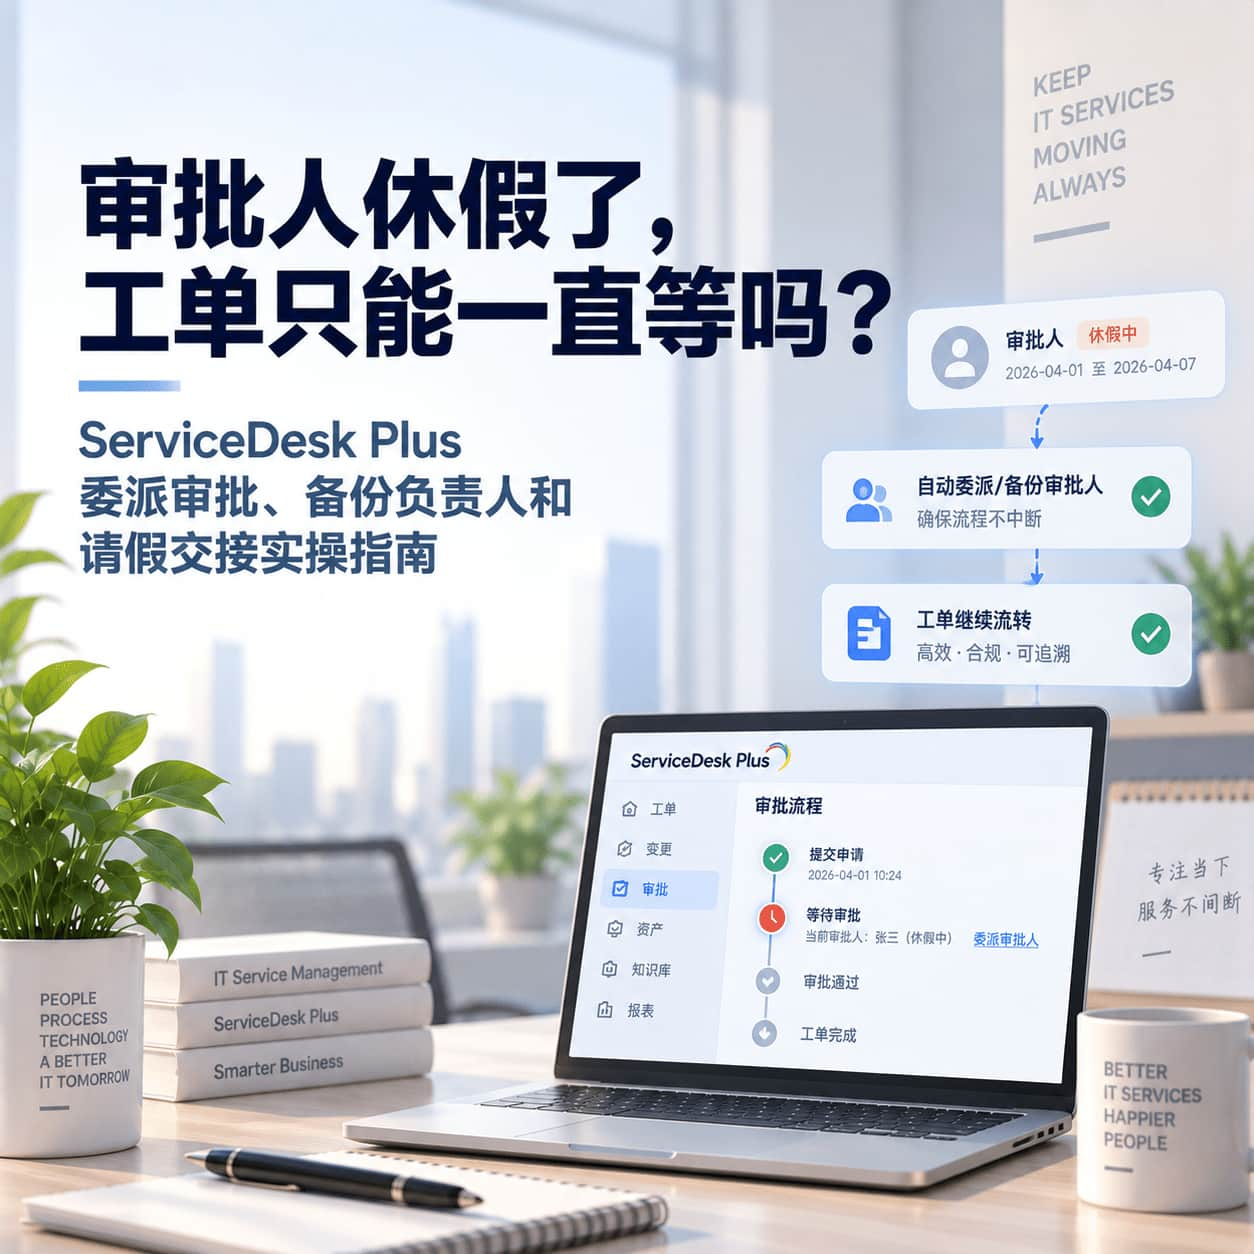
审批人休假了,工单只能一直等吗?ServiceDesk Plus委派审批、备份负责人和请假交接实操指南
服务请求已经提交审批,直属主管却突然休假;变更等待负责人批准,审批人正在出差;技术员请假后名下工单仍然没人接手……人员暂时不可用很容易让IT服务流程产生隐性阻塞。ServiceDesk Plus Cloud支持委派机制,可以针对不可用的技术员和请求者重新分配待处理请求,并将请求、变更、发布、问题和采购单等审批委托给指定用户或组织角色。本文围绕ServiceDesk Plus委派审批、技术员请假交接、备用审批人、请求所有权和审批权限展开,说明企业如何建立请假前委派、临时审批、权限检查、恢复交接和异常复盘机制,减少关键人员不在岗导致的工单积压。
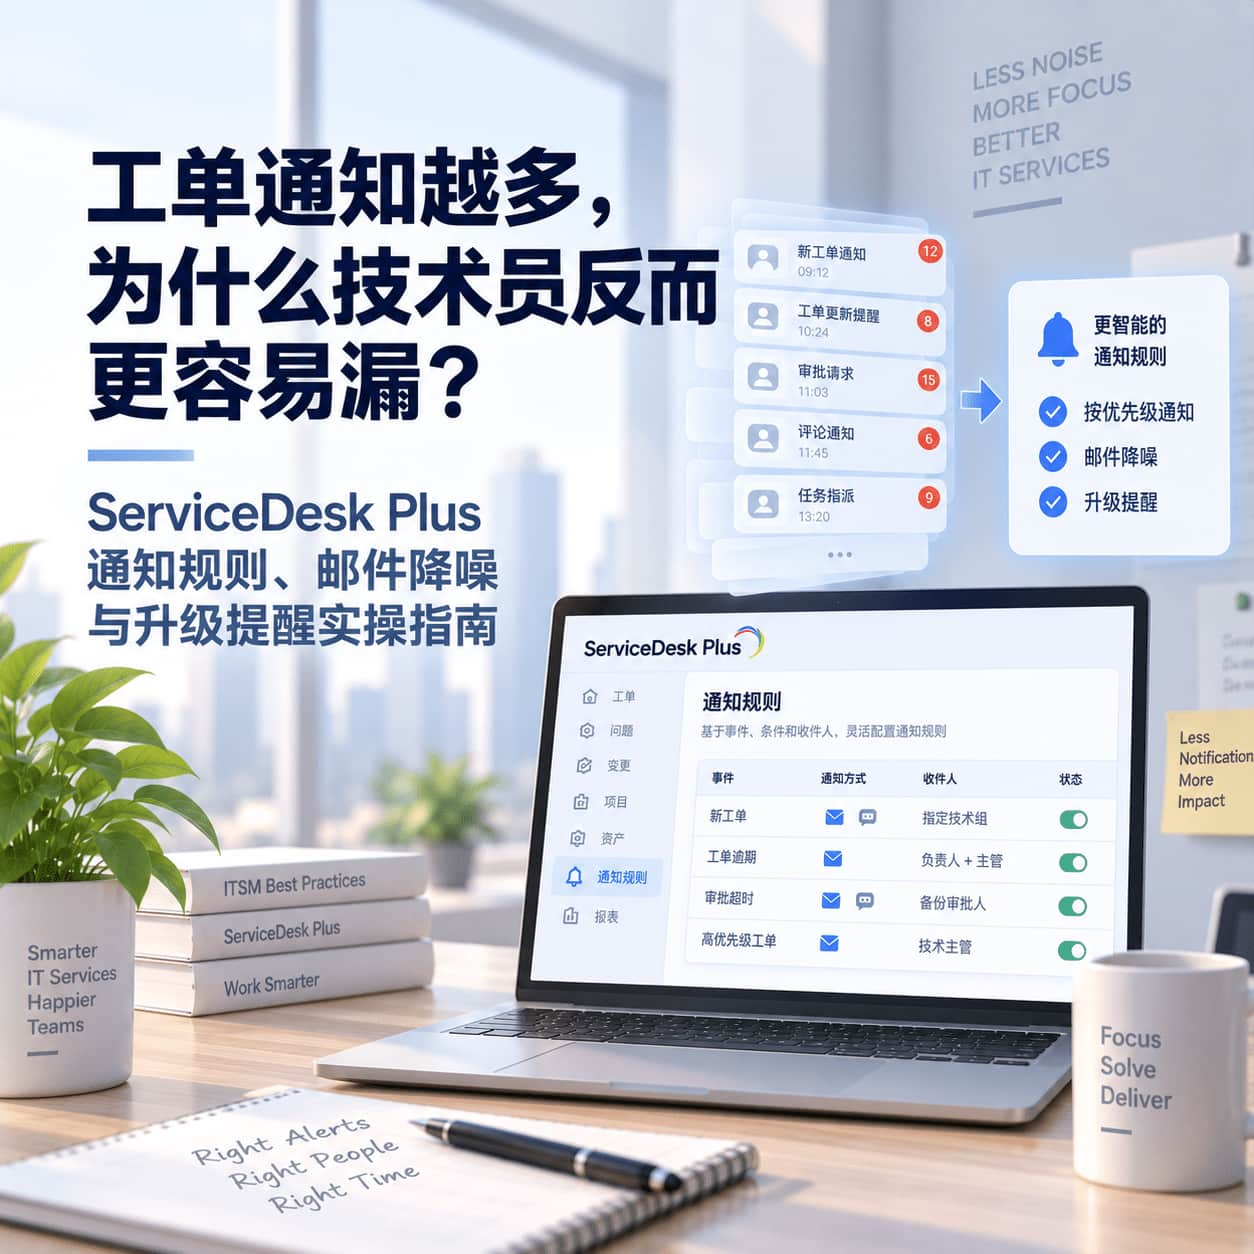
工单通知越多,为什么技术员反而更容易漏?ServiceDesk Plus通知规则、邮件降噪与升级提醒实操指南
新工单发一封、分派发一封、状态变化发一封、技术员回复发一封、SLA快超时再发一封……IT服务台通知配置越来越多,却可能出现用户不看邮件、技术员忽略真正紧急告警、同一事件重复通知多人、普通状态变化淹没关键升级等问题。本文围绕ServiceDesk Plus通知规则、邮件模板、技术员组通知、条件过滤、触发器和请求会话展开,说明企业如何区分确认类、行动类、升级类和异常类通知,减少无效提醒,同时确保真正需要处理的人在真正需要行动的时候收到清楚的信息。
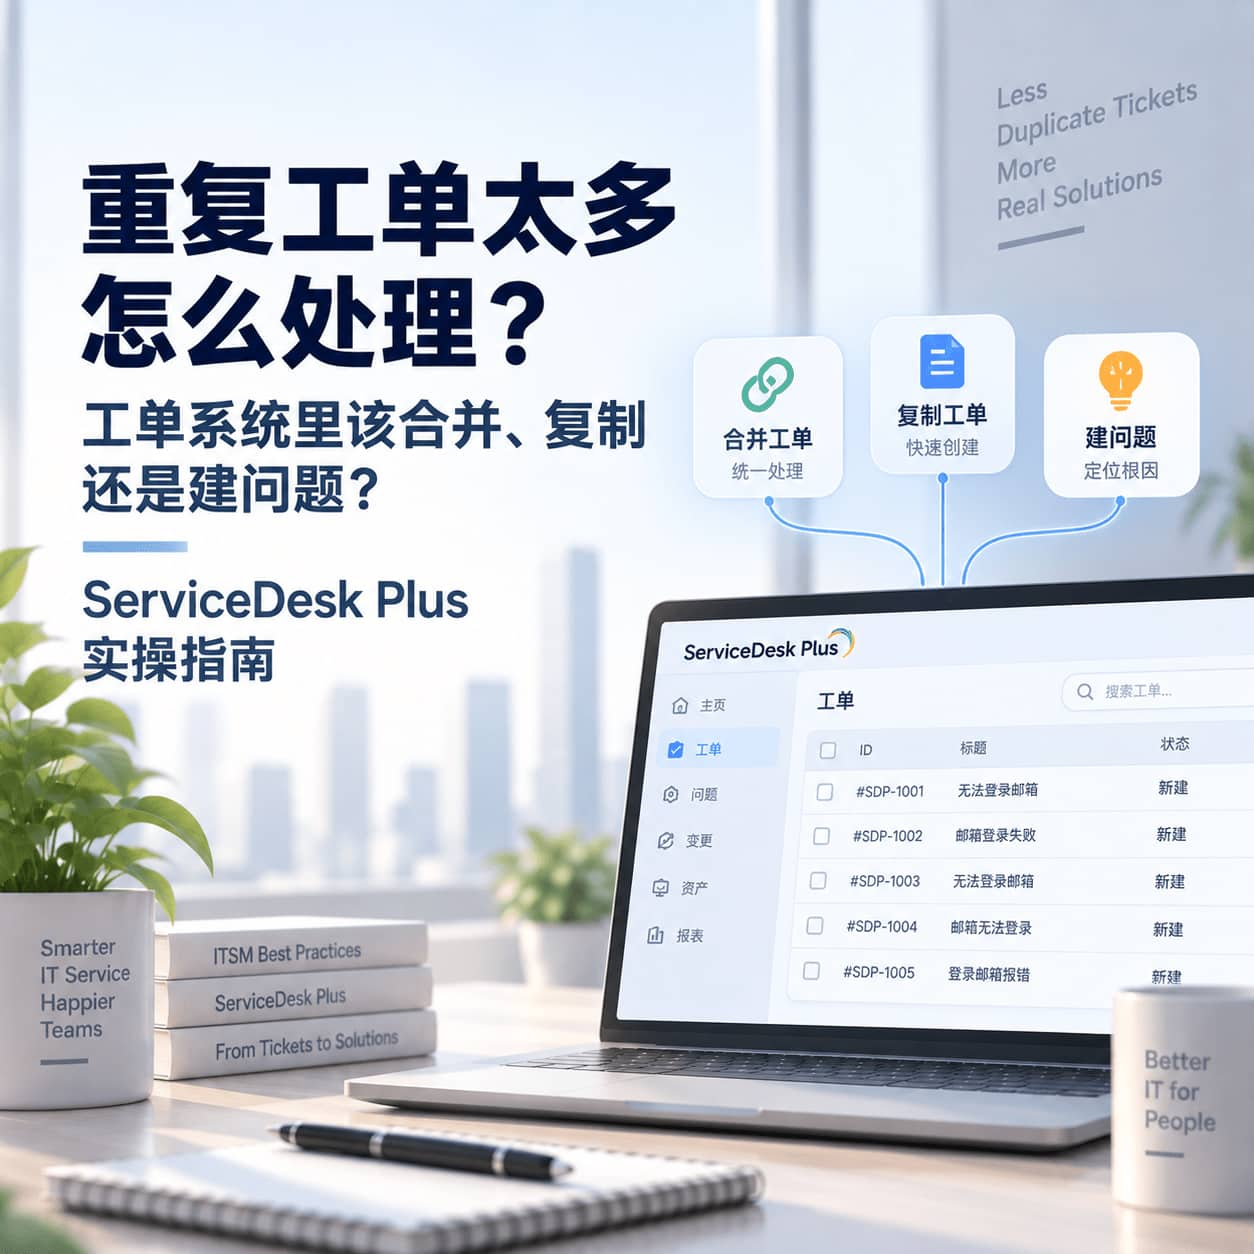
重复工单太多怎么处理?工单系统里该合并、复制还是建问题?ServiceDesk Plus实操指南
用户发完邮件又打电话催、门户提交失败后重新报修、同一系统故障被几十名员工分别提交工单……企业IT服务台很容易产生大量重复工单。但重复工单并不都应该直接删除或合并:同一请求人针对同一事项重复提交,可考虑合并请求;单张工单同时包含多个独立问题,可复制并拆开处理;多个用户同时遭遇相同故障,则更适合关联到问题管理,统一开展根因分析。本文结合ServiceDesk Plus请求合并、请求复制、问题管理、角色权限、请求协作和报表机制,讲清楚不同重复工单应该怎么处理,帮助企业减少重复工作,又保留完整的用户影响、SLA和服务记录。
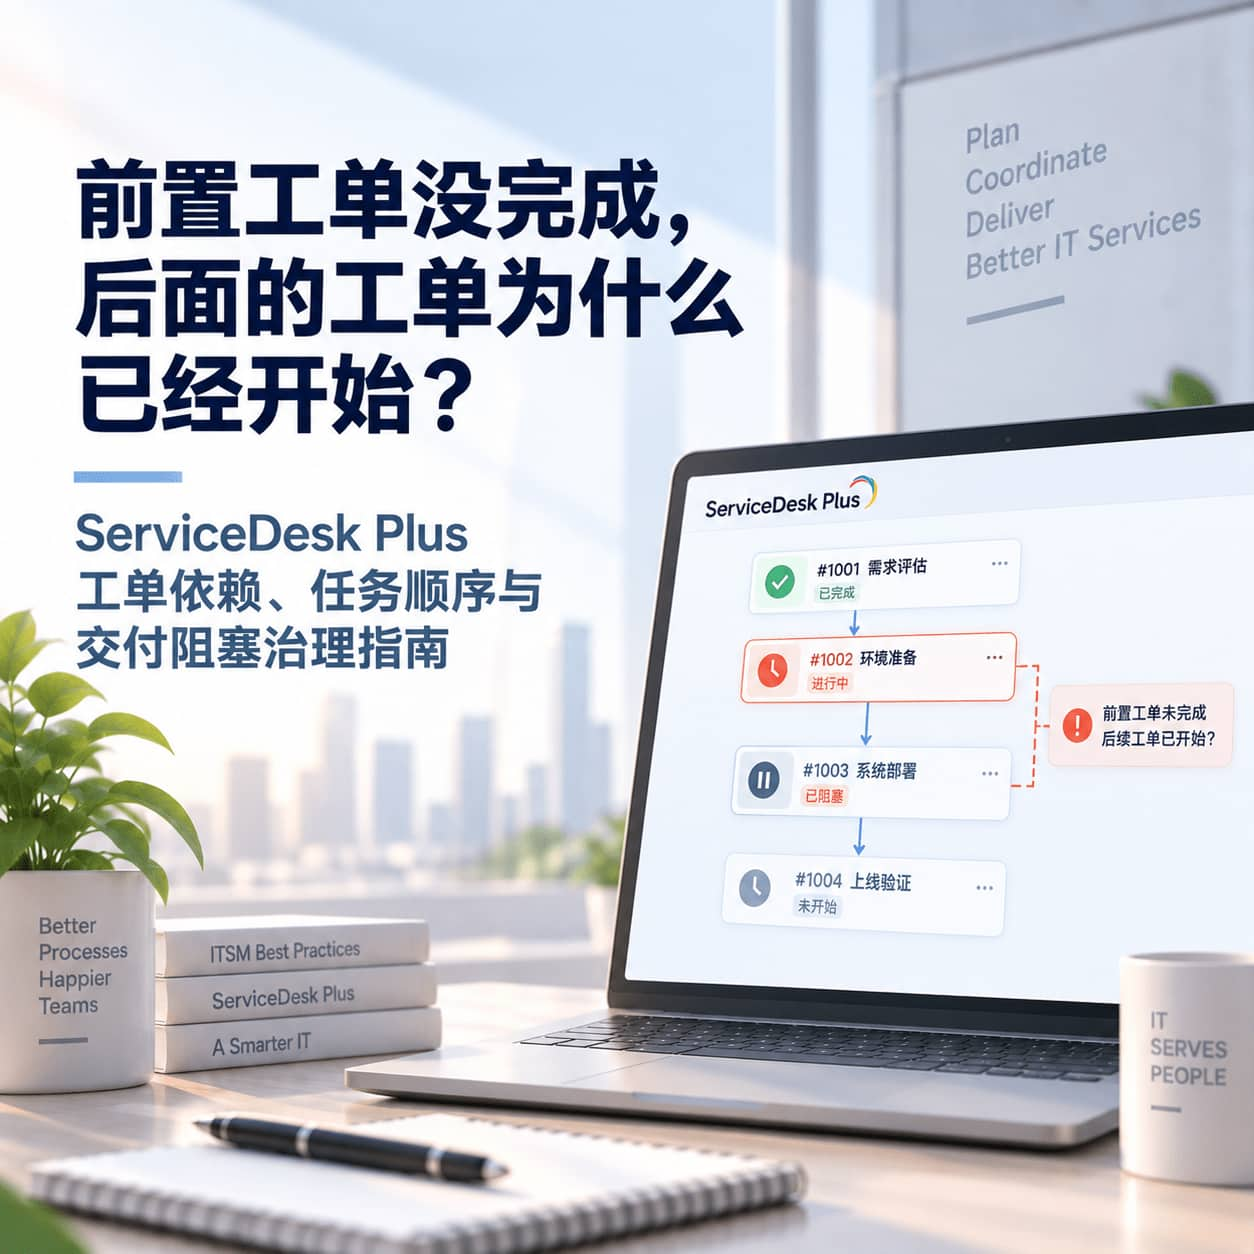
前置工单没完成,后面的工单为什么已经开始?ServiceDesk Plus工单依赖、任务顺序与交付阻塞治理指南
员工入职账号还没创建,软件安装任务已经开始;新服务器还没交付,应用部署工单已经进入处理中;变更实施尚未结束,验证任务却提前被认领……复杂IT服务往往不是一张工单就能独立完成,而是存在明确的前后置依赖。本文围绕ServiceDesk Plus请求依赖、关联请求、任务依赖、服务模板、关闭规则和交付阻塞管理展开,说明企业如何区分“相关”和“依赖”,建立前置完成、后续触发、异常阻塞、责任跟踪和关闭校验机制,让工单系统真正反映服务交付顺序。
同一个IT服务台为什么要接多个大模型?ServiceDesk Plus AI服务商选择、数据边界与切换治理指南
ServiceDesk Plus Cloud允许企业为不同GenAI功能配置不同AI服务提供商,包括Zia、ChatGPT、Azure OpenAI和Google AI Studio,部分Ask Zia场景还支持DeepSeek。但能够接入多个大模型,并不意味着企业应该随意切换。不同功能对文本理解、多模态输入、数据隐私、API密钥、使用统计和模型能力的要求不同。本文围绕ServiceDesk Plus大模型选择、AI服务商配置、数据边界、模型切换和使用效果复盘展开,说明企业如何按照Ask Zia、Workflow Assist、Reply Assist、Conversation Summary、Code Generator等实际场景分配AI服务商,让多模型能力从“选择很多”升级为“配置有依据、数据有边界、切换可验证”的ITSM治理能力。
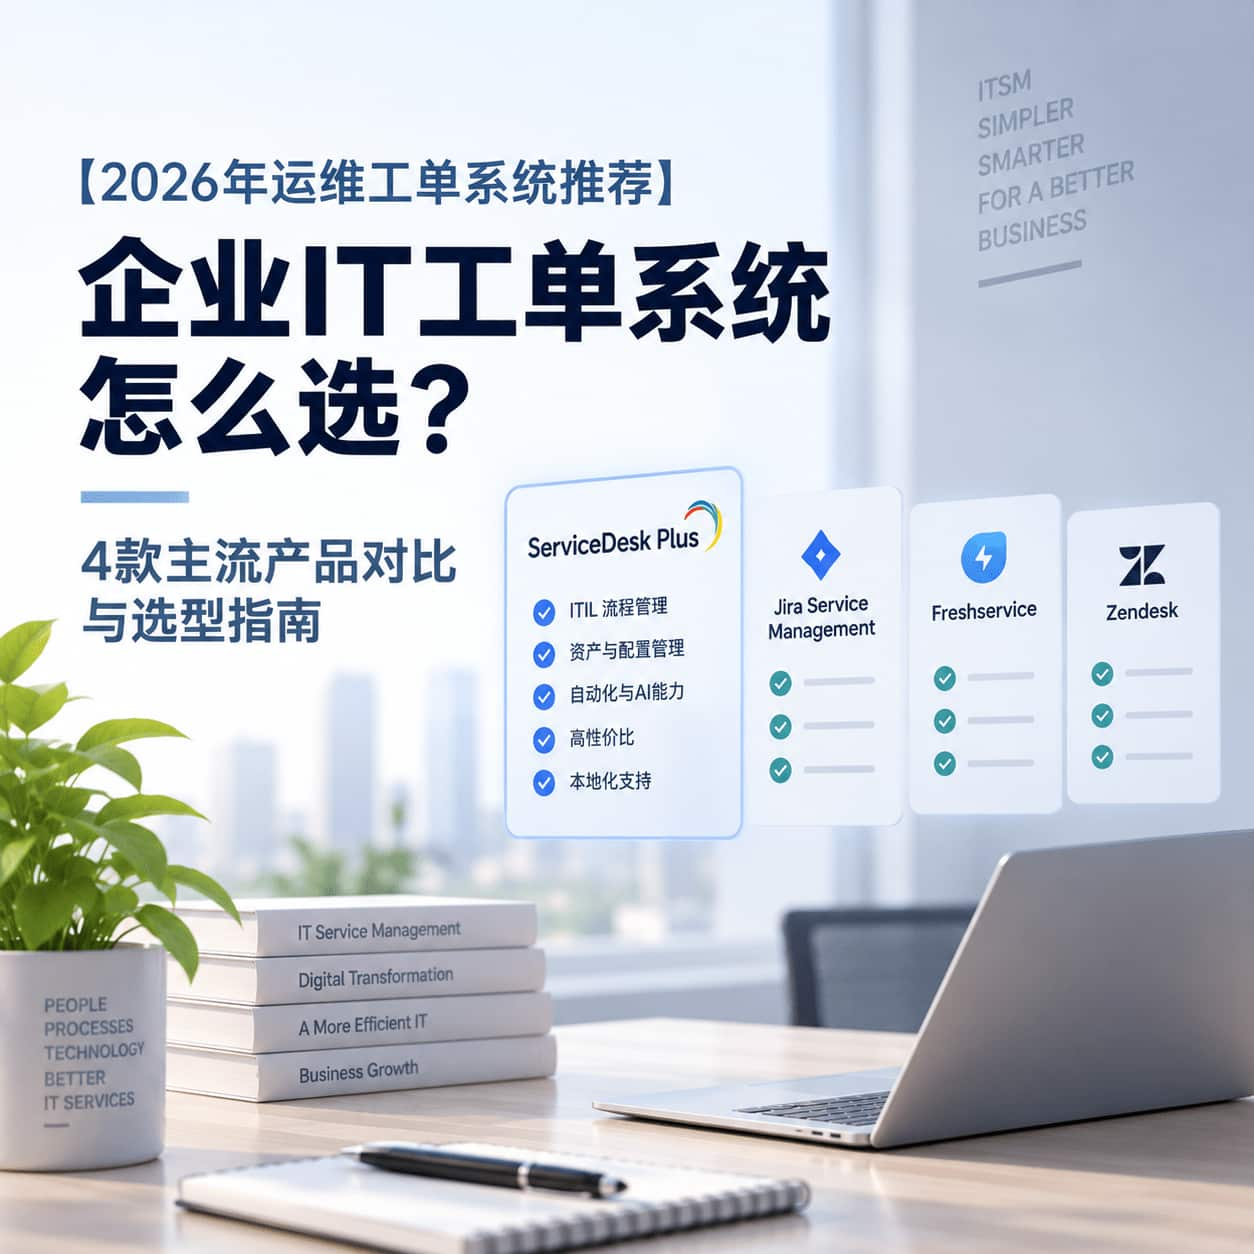
【2026年运维工单系统推荐】企业IT工单系统怎么选?4款主流产品对比与选型指南
2026年企业运维工单系统怎么选?本文从工单管理、ITIL流程、IT资产管理、CMDB、自动化、AI能力、本地部署、DevOps协同、本地办公平台集成和采购成本等维度,对ServiceDesk Plus、Jira Service Management、Freshservice、ServiceNow ITSM四款主流IT工单系统进行对比,并结合中小IT团队、中大型企业、研发运维团队、多地点企业和需要本地部署的组织给出选型思路,帮助企业避开“只看功能列表、上线后才发现不适合”的常见问题。
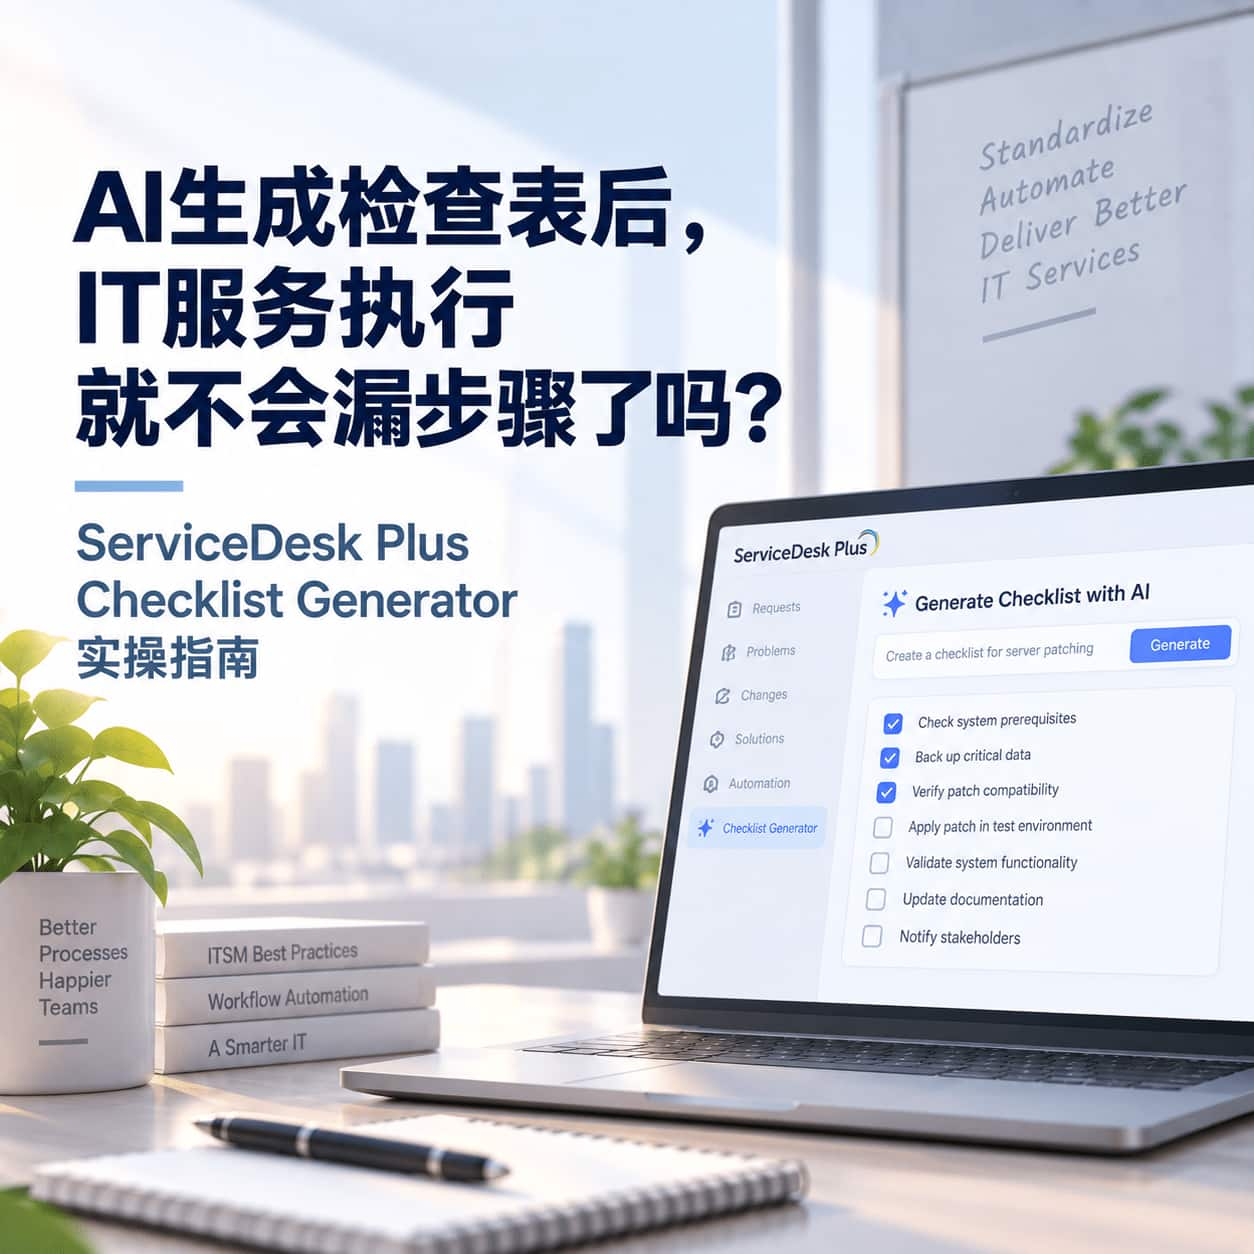
AI生成检查表后,IT服务执行就不会漏步骤了吗?ServiceDesk Plus Checklist Generator实操指南
ServiceDesk Plus Cloud支持通过Checklist Generator根据请求主题、描述或自定义提示自动生成检查项,并将检查表用于请求、模板、工作流、触发器和计时器等场景。但AI生成检查表并不等于服务流程已经标准化,检查项过多、顺序不清、责任不明、关键步骤缺少验证、不同场景共用同一套清单,都可能让检查表流于形式。本文从IT服务台AI检查表生成、服务执行标准化和闭环管理出发,分析企业如何通过ServiceDesk Plus与Checklist Generator建立检查项生成、人工校验、模板复用、任务执行、关闭校验、自动化触发和报表复盘机制,让AI从“帮我列步骤”升级为“帮助团队把每一步真正执行到位”的服务管理能力。
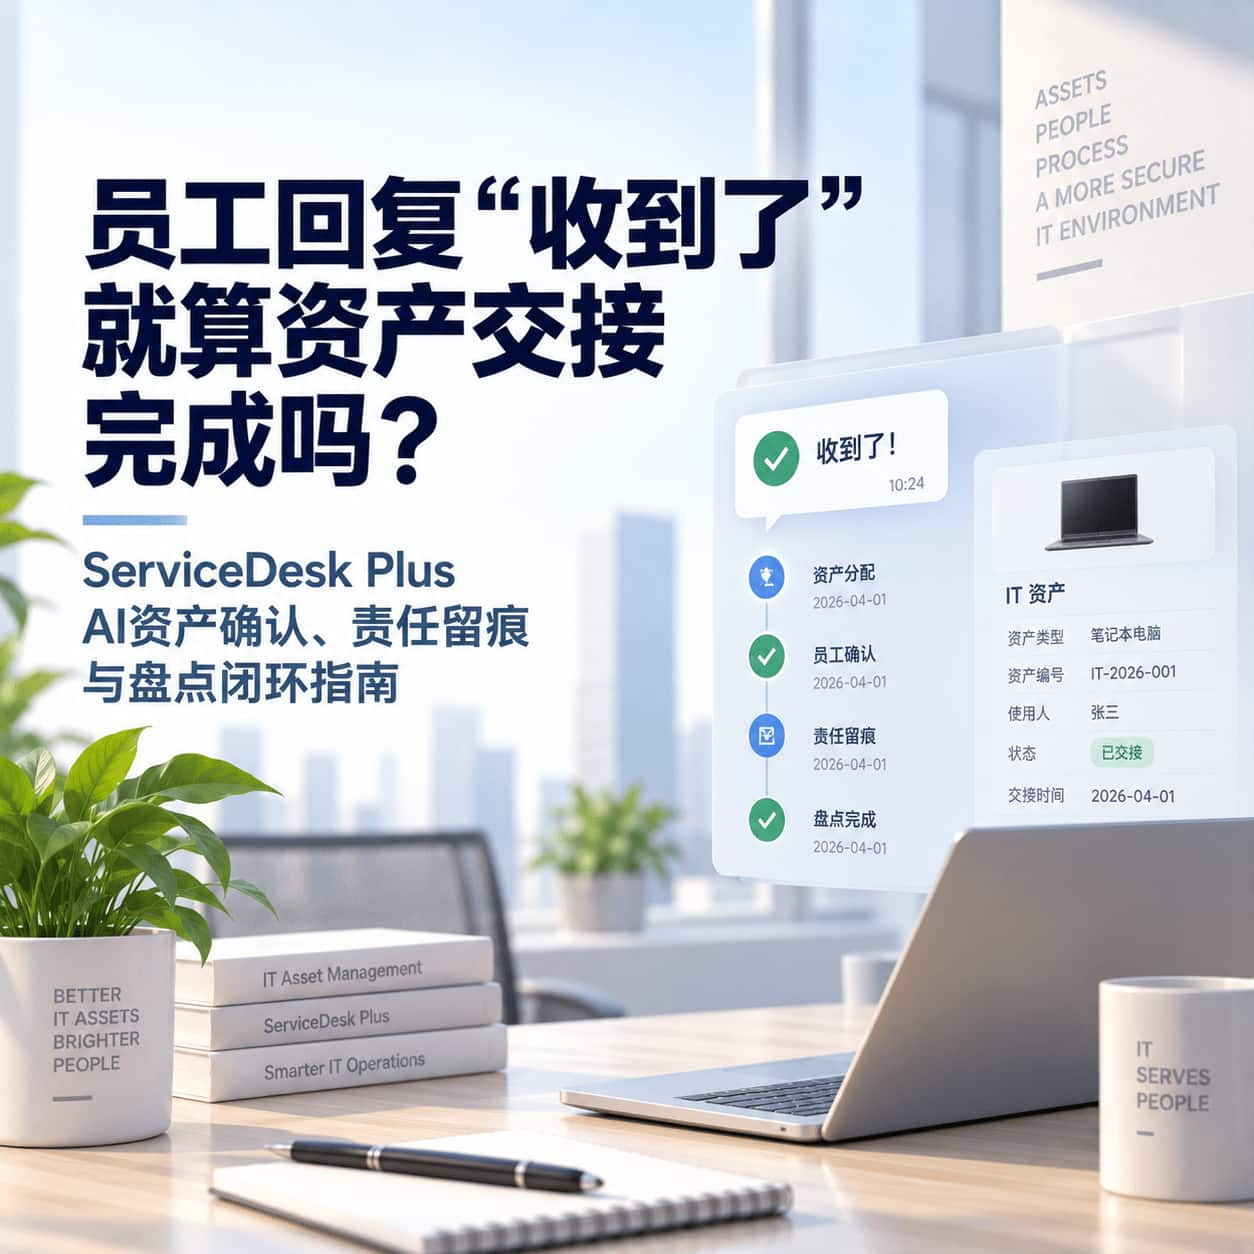
员工回复“收到了”就算资产交接完成吗?ServiceDesk Plus AI资产确认、责任留痕与盘点闭环指南
企业向员工发放笔记本、显示器、手机、配件和其他IT资产后,经常面临“系统显示已分配,但员工到底有没有收到”“邮件回复内容不统一,资产管理员还要人工确认”“盘点时找不到责任证据”“设备已经转交但资产记录没有同步”等问题。ServiceDesk Plus Cloud支持资产确认,并可通过GenAI识别用户直接回复资产确认或提醒邮件中的收货信息。本文围绕AI资产确认、资产交接、责任留痕、未确认提醒、异常处理和盘点审计展开,说明企业如何把资产从“系统里分配给某个人”升级为“用户已确认、责任有记录、异常能跟踪、盘点有证据”的IT资产管理闭环。
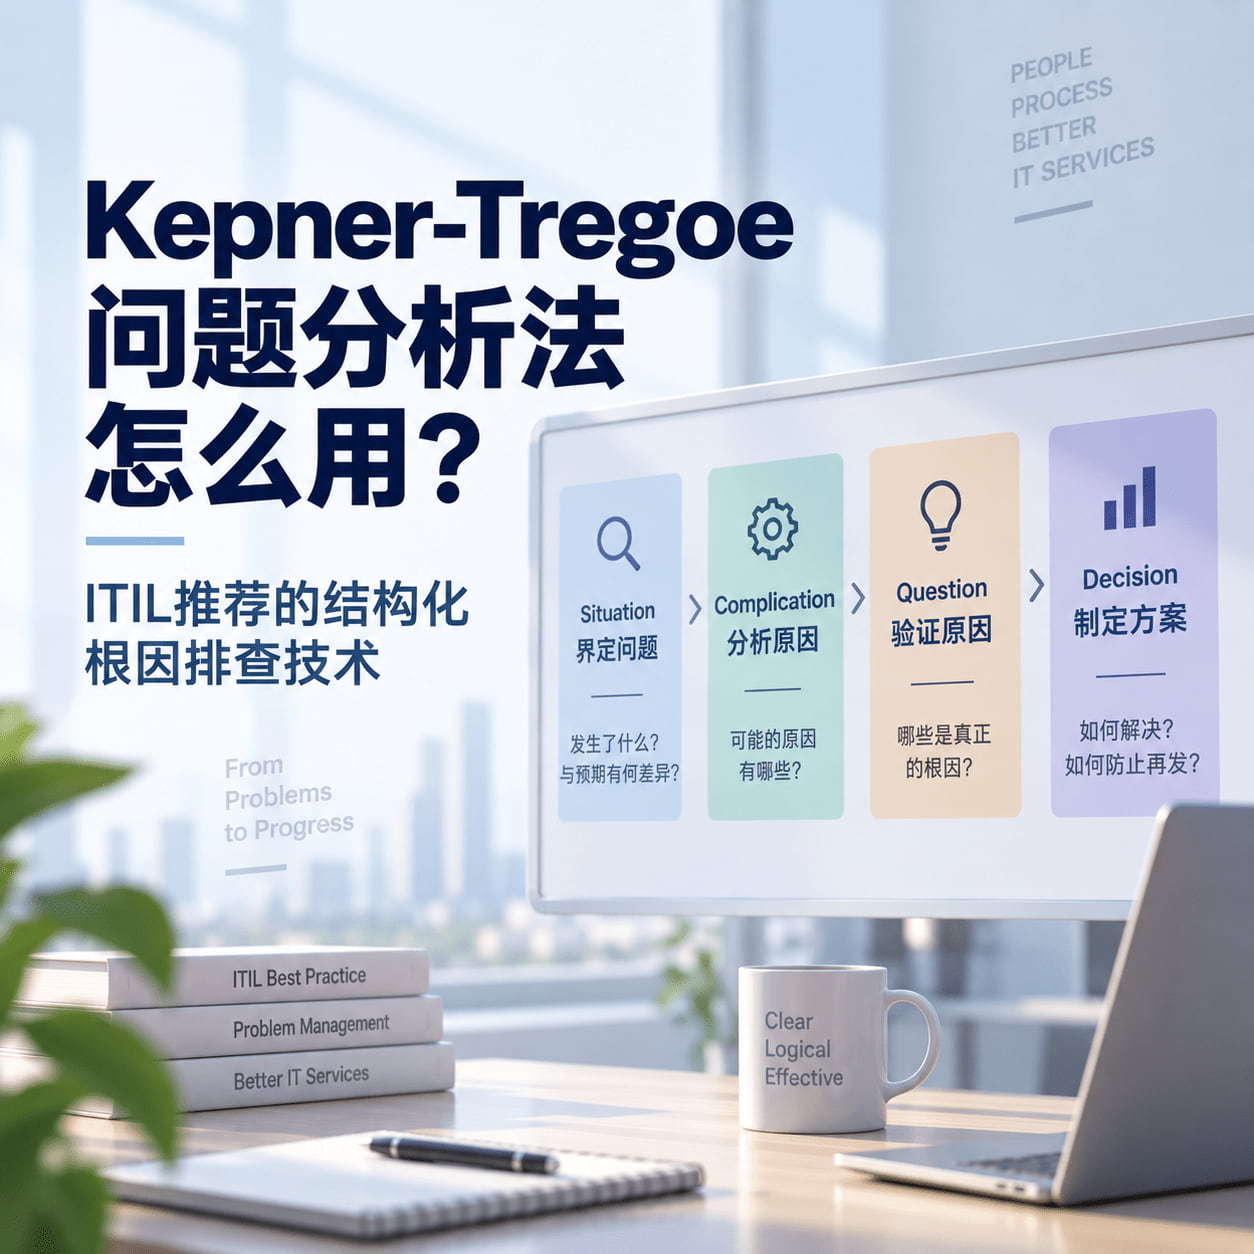
Kepner-Tregoe问题分析法怎么用?ITIL推荐的结构化根因排查技术
面对一个从未见过的复杂故障,团队只能凭经验和直觉猜测原因,猜对了算运气好?本文定义Kepner-Tregoe问题分析法,讲清楚这套ITIL官方推荐的结构化排查技术如何通过对比"是什么、不是什么"来快速锁定根因,帮助团队摆脱纯粹依赖经验和运气的排查方式。
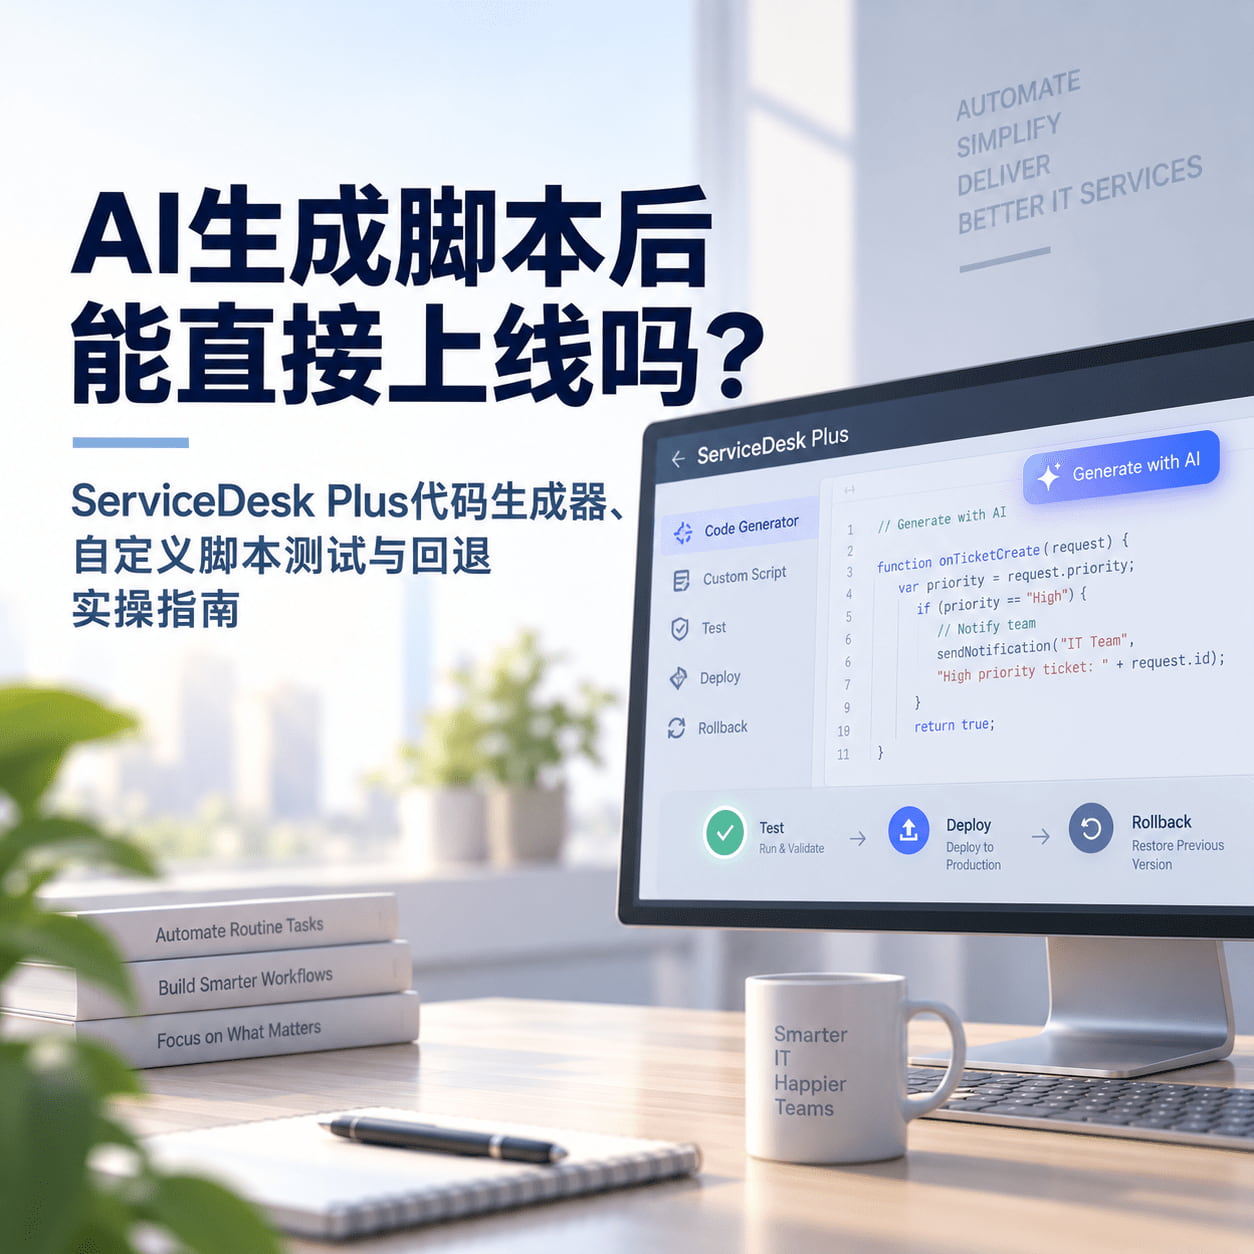
AI生成脚本后能直接上线吗?ServiceDesk Plus代码生成器、自定义脚本测试与回退实操指南
ServiceDesk Plus Cloud已经可以通过AI代码生成器,根据自然语言提示生成自定义脚本和自定义函数代码,但AI生成代码并不等于可以直接用于生产环境。脚本可能修改工单字段、触发业务规则、调用内部或外部API,测试操作也可能真正影响系统数据。本文围绕ServiceDesk Plus AI代码生成器、自定义脚本、自定义函数、Deluge、业务规则、API调用和测试治理展开,说明企业如何建立需求描述、代码审查、样例测试、API副作用检查、分阶段启用、异常停用和效果复盘机制,让低代码自动化从“AI帮我写代码”升级为“代码可审查、执行可控制、异常可处理”的IT服务管理能力。
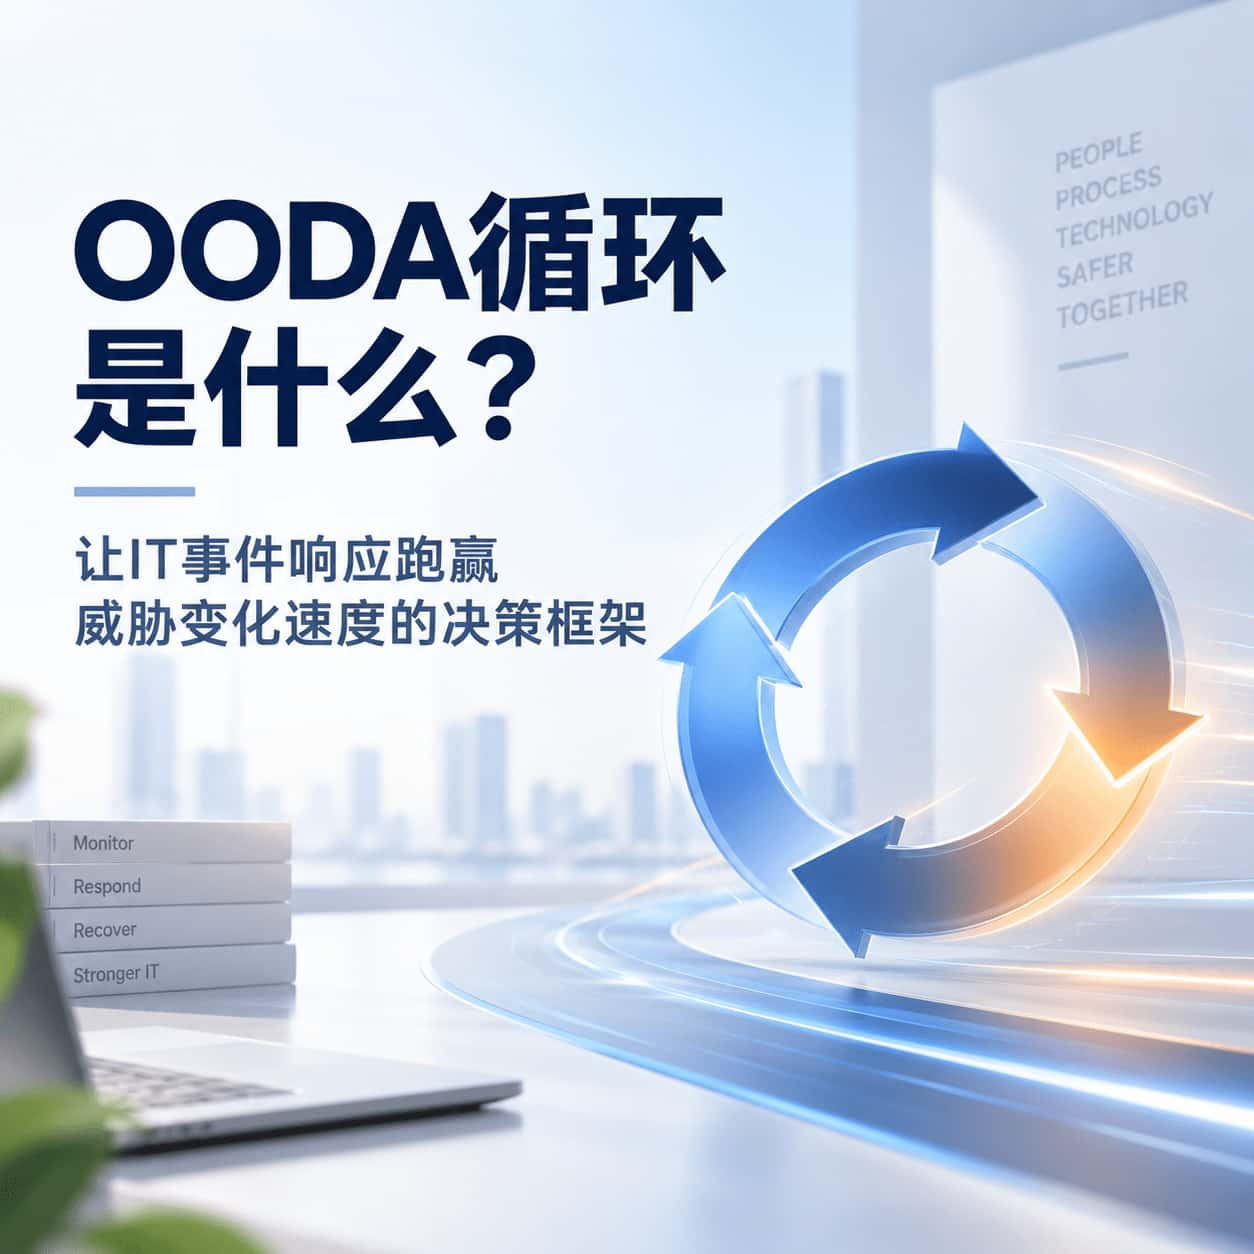
OODA循环是什么?让IT事件响应跑赢威胁变化速度的决策框架
面对不断变化的安全威胁或突发事件,团队的响应速度总是慢半拍?本文定义OODA循环(观察、判断、决策、行动),回顾军事战略家John Boyd提出这一决策框架的背景,讲清楚为什么循环速度本身就是一种竞争优势,以及企业该如何借助这套框架让IT事件响应真正跑赢威胁变化的节奏。
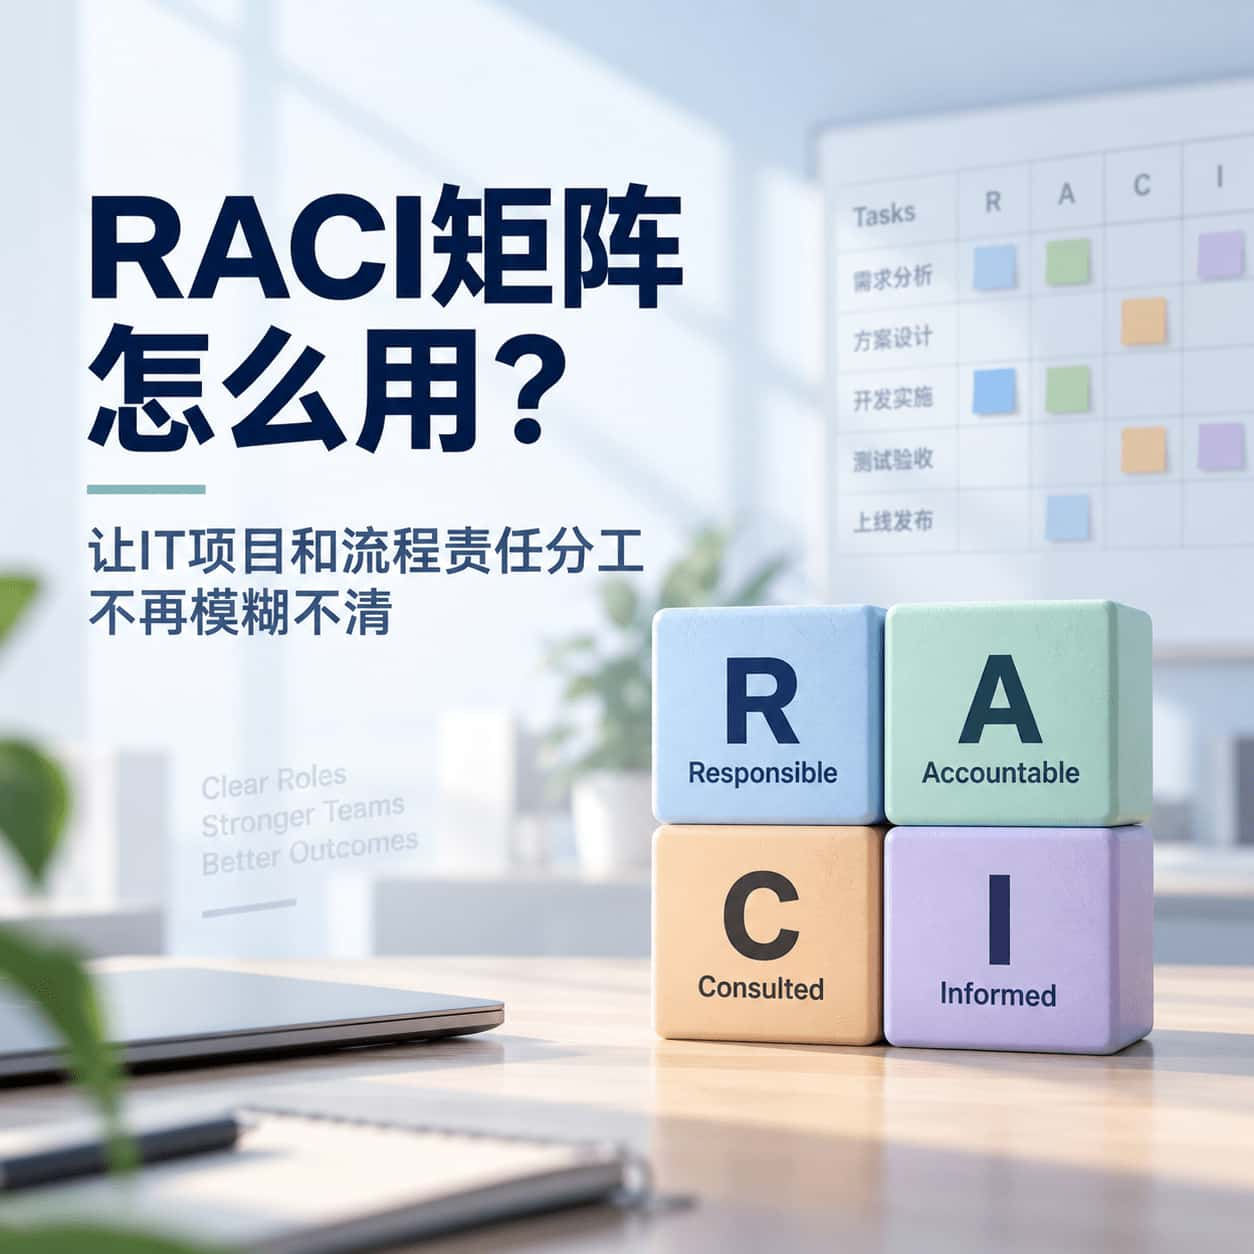
RACI矩阵怎么用?让IT项目和流程责任分工不再模糊不清
一个任务出了问题,团队互相推诿都说"我以为是对方负责"?本文定义RACI矩阵,讲清楚负责人、批准人、咨询对象、知情对象四种角色的区别与黄金法则,帮助企业在跨部门IT项目和流程中彻底厘清责任分工。

SRE黄金信号是什么?四个指标看懂系统健康状况
监控大屏上密密麻麻几十个指标,真正出问题时却依然找不到重点?本文基于Google SRE官方手册,定义延迟、流量、错误、饱和度这四个黄金信号,讲清楚为什么这四个指标是理解系统健康状况的最小必要集合,帮助企业把监控精力聚焦在真正重要的地方。

帕累托原则(80/20法则)怎么用?找到那20%真正值得优先解决的工单
IT团队每天被上百个不同类型的工单淹没,却始终没有精力系统性地根治任何一类问题?本文定义帕累托原则(80/20法则),讲清楚企业该如何把这套经典的优先级判断工具应用到IT工单分诊中,找到那真正值得投入精力优先解决的少数问题类型。
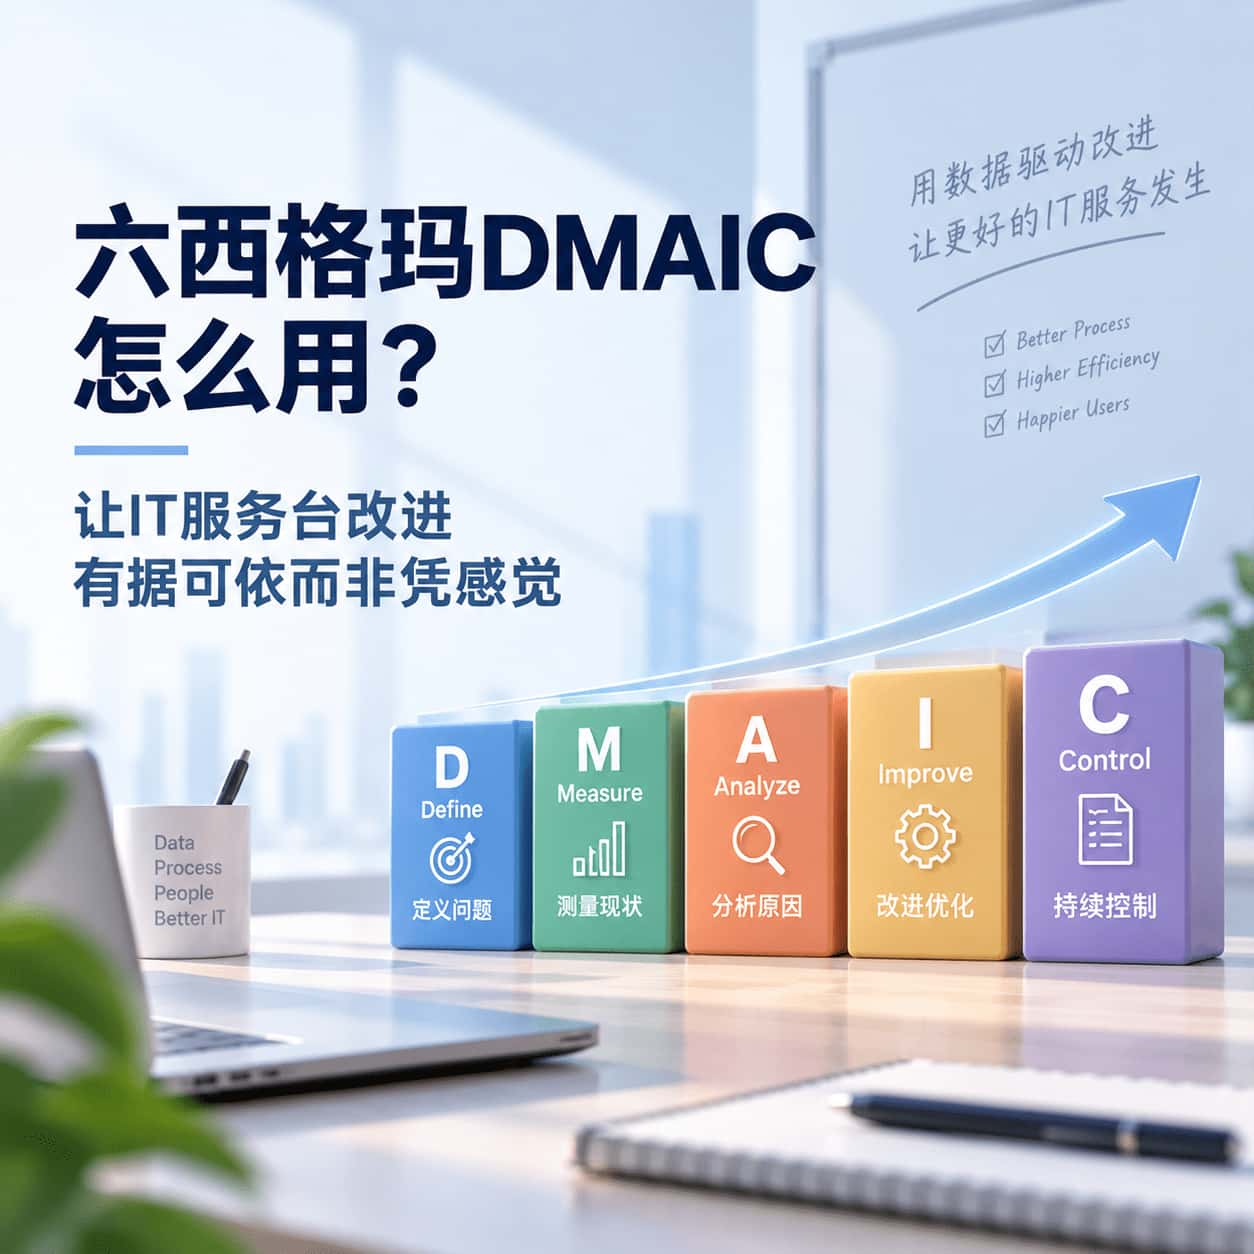
六西格玛DMAIC怎么用?让IT服务台改进有据可依而非凭感觉
团队凭感觉推行了一轮又一轮流程改进,却始终说不清效果到底提升了多少?本文定义六西格玛DMAIC方法论,讲清楚定义、测量、分析、改进、控制五个阶段具体该怎么做,帮助IT服务台把流程改进从凭感觉的尝试,变成一套有数据支撑、可验证效果的规范流程。