应用服务地图没人看?让依赖拓扑真正用起来

AI 摘要
应用服务地图没人看,问题通常不在地图本身,而在图上缺了三样东西:没有健康度——连线只是连线,看不出谁好谁坏;没有分层——几十个节点挤在一张平面图上,分不清用户、服务、中间件、数据库和网络设备;没有联动——告警在告警系统里,地图在地图页面里,两边对不上。本文给出三个改法——给节点叠实时健康度、把依赖关系按五层拆开、让告警在地图上点亮影响面,并把依赖拓扑接进日常巡检、故障定位、变更评估三个场景,让地图从「评审时截一次图」变成每天都要打开的工具。
答案先说:应用服务地图没人看,不是图没用,而是图上缺了三样东西——健康度、分层、联动。只有连线的地图回答不了「现在谁有问题」,平面堆叠的地图回答不了「出事会带上谁」,和告警对不上的地图更回答不了「这条告警影响多大」。三个问题不解,图自然没人看。
这篇给出三个改法:给节点叠上实时健康度状态色,把依赖关系按「用户 → 应用服务 → 中间件 → 数据库 → 网络设备」五层拆开,让每条告警在地图上点亮自己的影响面。再配一张「依赖拓扑三种日常用法」对照表,把地图接进巡检、定位、变更评估的日常动作里。
ManageEngine OpManager在这件事里的位置,是把拓扑从静态截图变成活数据:设备与链路的网络映射负责自动发现和更新连接关系,与应用监控插件打通后,服务与接口的健康度直接叠在地图节点上,告警触发时同步点亮关联链路。
核心要点
- 地图没人看的根因不是「画得不好」,而是缺健康度、缺分层、缺与告警的联动——三个都不补,图就只是评审素材。
- 改法一:节点状态色直接反映实时可用性,打开地图第一眼先看哪里变色,而不是先找图例。
- 改法二:依赖关系按「用户 → 应用服务 → 中间件 → 数据库 → 网络设备」五层拆开,每一层回答一类问题。
- 改法三:告警与地图联动,一条告警触发时在地图上点亮受影响的上游服务和下游链路,影响面一眼可见。

为什么地图总是没人看:三个断层
先说结论:应用服务地图被冷落,不是运维不爱看图,而是图回答不了运维要问的问题。断层有三个。第一,只有连线没有状态——图上每个节点都长一个样,好坏要靠点进去逐个查,那还不如直接看告警列表;第二,一张平面图堆几十个节点——用户请求、应用服务、数据库、交换机挤在一起,分不清谁依赖谁、谁影响谁;第三,和告警两张皮——告警在告警平台响,地图在地图页面挂着的还是上个月导出的快照。
三个断层对应的正是地图本该给出的三种判断:现在谁有问题(健康度)、出事会带上谁(分层依赖)、这条告警影响多大(联动)。缺了这三样,地图就只在架构评审和汇报 PPT 里出现一次,日常没人打开。
三个改法:给地图装上「判断」
改法一:节点叠实时健康度。连线回答的是「谁连着谁」,健康度回答的是「现在谁不对劲」。把每个节点的实时状态用色标直接画在地图上——绿的正常、黄的越限、红的失效,打开地图第一眼先扫颜色,异常节点自己会浮出来。这一步等于是把可用性监控的结果画到图上:地图和监控用同一份实时数据,而不是两套各说各话。
改法二:依赖关系按五层拆开。用户 → 应用服务 → 中间件 → 数据库 → 网络设备,一层一列。分层之后每层只回答一类问题:服务层看哪个接口慢了,中间件层看队列堵没堵,数据库层看哪个实例拖了后腿,网络层看哪条链路抖了。平面上找不到的「谁依赖谁」,分层图上一眼就能看到——排障时沿着依赖线从上往下走,比在海量告警里捞线索快得多。
改法三:告警与地图联动。一条告警触发时,地图自动定位到告警节点,同时点亮它的下游连接和上游服务。这样接警的人打开地图,看到的不只是「这台设备挂了」,而是「这台设备挂了会带走哪两个服务、影响哪条业务线」。影响面从图上看出来,比在群里挨个问快,也比事后复盘时补画准确。
把地图接进日常:三种用法对照
三个改法做完,地图就从「评审素材」变成了工具。下面这张表是它的三种日常用法,右列同样给一条可执行的验收动作——答不上来,说明这一格还没用起来。
| 日常场景 | 地图上做什么 | 一条可执行的验收动作 |
|---|---|---|
| 日常巡检 | 只看状态色异常的节点与其下游依赖,十秒扫一层 | 早班巡检先开地图再看告警列表:异常节点和告警能互相印证吗 |
| 故障定位 | 从变色节点沿依赖线找上下游,圈出影响面再动手 | 抽最近一次故障:影响面是看地图定的,还是靠嘴问出来的 |
| 变更评估 | 变更前查目标节点的依赖,列出会被波及的上游服务 | 下次变更单附一张依赖截图:受影响服务列全了吗 |
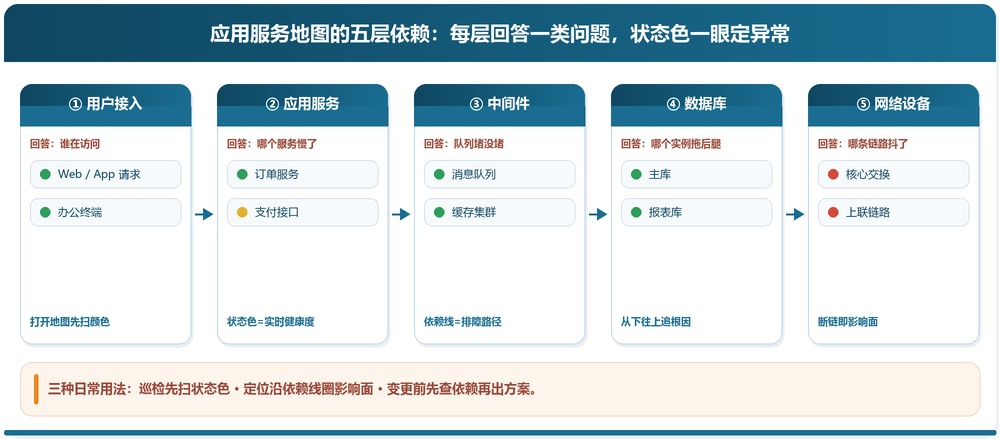
三行的共同点是「先看图、再做动作」:巡检先扫颜色再核对告警,定位先圈影响面再动手,变更前先查依赖再出方案。地图一旦接进这三个动作,更新和准确就有了日常校验——图错了马上会被发现,而不是等到出事那天。
分工边界:网络映射与应用服务地图各管一层
实务里最常见的混淆,是把设备级拓扑和服务级依赖当成同一张图。分工这样切:网络映射管设备与链路这一层——交换机、路由器、防火墙之间谁连着谁,靠自动发现保持更新;应用服务地图管服务这一层——一个业务请求会经过哪些服务、中间件和数据库,依赖关系从哪里来、断了会带走谁。两张图共享同一份监控数据,排障时从网络层一路穿到服务层,这才是全链路视角。
服务层的健康度和接口延迟,通常要靠应用监控能力补进来:应用侧发不上力,服务层节点在地图上就只剩一个名字。网络侧先把自己这层的连接关系维护准——设备增减、链路变更自动进图,服务层接入后地图才真正立得住。临近年底业务变更密集,大改之前先用依赖图过一遍影响面,是这个工具最划算的一笔回报。
参考来源
1. Google SRE《Monitoring Distributed Systems》(分布式系统监控中健康状态、依赖与告警联动的经典框架)
2. Google SRE Workbook「Managing Overload」章节(级联故障与依赖过载的处置原则,对依赖分层与影响面判断的直接依据)
说明:文中三个改法与三层用法为通用实践归纳,请结合自身架构与工具能力调整;产品能力以官方页面为准。
一句话总结:应用服务地图没人看,是因为它只画了连接、没给判断——叠上健康度、拆开五层依赖、接通告警联动,再把它按进巡检、定位、变更评估三个日常动作,图才能一直活下来。
延伸阅读
想把依赖拓扑用起来?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 应用服务地图和网络拓扑图是一回事吗?
答:不是,两者分工不同。网络拓扑图管设备与链路:交换机、路由器、防火墙之间谁连着谁,靠自动发现维护;应用服务地图管服务依赖:一个业务请求经过哪些服务、中间件和数据库。实务上建议两张图共用同一份数据源——包括可用性监控的实时状态——分层呈现:排障时从网络层穿到服务层,才是全链路视角。
- 依赖关系怎么自动发现?要手工维护吗?
答:设备层连接靠发现协议与 SNMP 自动收集,端口、邻居、VLAN 关系可以做到准实时更新;服务层依赖可以按业务在监控工具里登记(每新增一个服务时顺手把上下游填上),有应用监控能力时也可以从调用数据里自动生成。完全手工维护的地图一定会过期,能自动的交给自动,剩下的以「变更时同步更新」作为纪律。
- 地图节点太多、线太乱怎么办?
答:按五层拆开显示,每层只看自己关心的一层;再用过滤器把视角收窄——比如只显示某个业务线相关的节点,或者只显示状态异常的节点及其直接依赖。一张图塞下全网本来就是错误用法:图的价值在于回答具体问题,问题越具体,图就该越聚焦。
- 变更评估时地图怎么用?
答:变更前在地图上定位目标节点,沿依赖线列出上游受影响的服务和下游依赖的资源,形成影响面清单附进变更单。这一步同时校验了两件事:依赖关系是否维护得准(图对不上现实就要先补数据),以及这次变更的回滚预案是否覆盖了所有受影响服务。
- 小规模网络也需要应用服务地图吗?
答:看业务对连续性的要求,不看设备数量。几十台设备、两三个核心业务的团队,一张分好层的简单地图就够用,重点是两条:设备连接自动发现、核心业务的依赖登记。反而是小团队没有专人盯告警,一张能直接看出影响面的地图,比一堆告警列表更能帮值班的人做判断。

