网络流量分析工具能回答什么?六个运维场景的对照表

AI 摘要
AI 摘要:网络流量分析工具的价值不在「采了多少流量」,而在「能回答哪些问题」。本文先把常见问题归成六类——谁在占用带宽、用在哪个应用上、是否异常、容量何时到顶、出账依据、安全事件取证——再给一张「问题 → 指标 → 能看到什么 → 看不到什么」的对照表,最后列出三个答不上来的边界:加密流量(TLS 1.3 / ECH)、大比例采样后的单流、以及无 agent 的老设备。买工具前先问「我要回答哪个问题」,比问「支持多少协议」更有用。
答案先说:网络流量分析工具的价值不在「采了多少流量」,而在「能回答哪些问题」。同一份流数据,问「谁在占带宽」和问「容量何时到顶」,要用的是完全不同的指标与聚合方式。先想清楚要回答哪个问题,再谈工具,才不至于买回来只用来画带宽曲线。
流量分析这件事有一个容易被忽略的事实:从设备导出流数据,到最终给出一个能支撑决策的答案,中间隔着一整层「指标设计」。流数据本身只记录了五元组、字节数、包数、时间戳这些原始事实,它不直接告诉你「这是视频会议」或者「这是一次异常」——那些结论来自你怎么聚合、和什么基线比。
所以本文不堆协议名词,而是把运维里真实会问的问题归成六类,逐个说清楚:回答它需要什么指标、能看到什么、又注定看不到什么。最后再补三个目前工具普遍答不上来的边界,免得在选型时被「全都能看」的宣传误导。
核心要点
- 网络流量分析工具的核心不是「采得多」,而是「指标设计」:同一份流数据,换个问题就要换一套聚合与基线。
- 六类常见问题:谁在占用带宽、用在哪个应用上、是否异常、容量何时到顶、出账依据、安全事件取证。
- 三个答不上来的边界:加密流量(TLS 1.3 / ECH)看不到内容、大比例采样算不准单流、无 agent 老设备只能靠流数据。
- 选型时先问「我要回答哪个问题」,比问「支持多少种流协议」更能避免买错。
先分清「看得见」和「答得准」
很多团队第一次做网络流量分析,关注点都停在「接上去了吗」:流协议对不对、端口通不通、Top-N 有没有数据。接入成功当然重要,但它只解决了「看得见」。真正决定工具有没有用的是下一步——「答得准」:同样一条「带宽利用率 80%」的曲线,有人能据此判断该扩容还是该限流,有人只能看着数字发呆,差别就在指标设计。
这也是本文的基本立场:不要问一个流量分析工具「支持多少种流协议」,而要问它「能不能把我关心的那个问题,变成一个我能读懂、能拿去决策的指标」。下面六类问题,就是运维现场最常被问到、也最值得用工具回答的六件事。
六类问题,六个场景:一张对照表说清能力边界
把六个场景放在一张表里,右边两列是关键——「能看到什么」和「看不到什么」。选型时如果只读左边三列,很容易高估工具;把右边两列也读一遍,才知道它到底能替你回答到哪一步。
| 运维场景 | 要回答的问题 | 核心指标 | 网络流量分析工具能看到什么 | 看不到什么 |
|---|---|---|---|---|
| ① 谁在占用带宽 | 哪台主机 / 哪个会话吃掉了大半带宽 | Top-N 会话、源/目的 IP、流量排行 | 最大的那个「谁」和它的流量量级 | 它传的具体内容是什么 |
| ② 用在哪个应用上 | 这些流量属于视频、备份还是数据库同步 | 应用识别(DPI / NBAR)、端口与协议 | 应用分类与各自占比 | 加密载荷里的具体操作 |
| ③ 是否异常 | 今天和过去几周比,哪里不对劲 | 时段基线、偏离倍数、突增突降 | 与历史相比的突变点 | 突变到底是攻击还是业务变化 |
| ④ 容量何时到顶 | 按现在的增长,链路多久会打满 | 95 百分位、增长斜率、趋势外推 | 扩容的时间窗口 | 计划外的突发峰值 |
| ⑤ 出账依据 | 按 IP / 网段 / 客户该怎么算流量 | 流量明细、多维度聚合、留存期 | 可计价的流量口径 | 计费策略本身是否合理 |
| ⑥ 安全事件取证 | 某个时刻到底发生了什么 | 五元组回溯、会话留存时长 | 某时段的会话轨迹 | 已加密流量里的载荷内容 |
场景一 · 谁在占用带宽:先找到「那个谁」
这是最基础也最高频的问题。大多数网络流量监控工具都会提供 Top-N 会话统计:按源 IP、目的 IP 等维度排个序,谁大谁小一目了然。它擅长回答「量级」,不擅长回答「内容」——你知道了某台主机占了 40% 的带宽,但不知道它在传什么。凡是遇到「网络慢」的投诉,这一步几乎都是起点:先定位到具体的主机与会话,再往下追。
场景二 · 用在哪个应用上:给流量贴上应用标签
知道了「谁」,下一个问题是「在干什么」。这要靠流量分析系统的应用识别能力:基于深度包检测(DPI)或设备侧的应用分类,把流量归到视频会议、备份、数据库同步、对象存储这些类别里。有了应用标签,「备份窗口和视频会议撞车」这类问题才能被解释清楚。需要注意的是,应用识别对加密流量的判断会退化——加密之后能看到的往往只剩端口和少量握手信息,识别准确率会明显下降。
场景三 · 是否异常:和「过去的自己」比
「异常」不是一个绝对值,而是一个相对量。判断异常要靠基线:按工作日、按小时段建一条历史曲线,再看今天的实际值偏离了多少倍。基线做得细,异常就抓得准;基线做得粗,不是天天误报就是漏报。要提醒的是,工具能告诉你「这里偏离了基线」,但「偏离」不等于「攻击」——一次大促、一次批量备份都会让流量偏离,判断性质还得结合业务日历与安全事件。
场景四 · 容量何时到顶:用 95 百分位而不是平均值
扩容决策最怕用平均值:平均值会把峰值抹平,让你误以为还有余量,而不少网络流量监控工具默认展示的恰恰是平均值。更靠谱的口径是 95 百分位——把一天里 95% 的时间都覆盖住的那个水位,再叠加增长斜率做趋势外推。这样得出的「还有几个月打满」,才是能拿去申请预算的数字。它答不了的是计划外的突发峰值:一次演练、一次故障切换都可能瞬间打满,那属于容量冗余设计,不是趋势外推能解决的。
场景五 · 出账依据:把流量变成可计价的明细
对专线服务商、多租户环境来说,流量不只是运维指标,还是账单依据。这时需要一套流量分析系统提供按 IP、网段、客户维度聚合的流量明细,以及足够长的留存期来支撑对账——网络流量监控工具的聚合口径,直接决定了这张账能不能对上。这类场景对「聚合维度」的要求远高于对「实时性」的要求——账要算得清、查得到、能复核。至于计费策略本身合不合理(单价、阶梯怎么定),那是业务问题,工具不背这个锅。
场景六 · 安全事件取证:靠留存时长和五元组回溯
出事之后最常见的追问是「那天晚上到底发生了什么」。一套流量分析系统能否回答这个问题,取决于留存时长加五元组回溯:五元组(源 IP、目的 IP、源端口、目的端口、协议)加上时间戳,能把某个时刻的会话轨迹还原出来。这里的关键参数是留存期——留得短,事后就查不到;留得长,存储成本就上去了。而它同样有边界:加密流量能还原「谁和谁通信」,还原不了「聊了什么」。
三个答不上来的边界,选型前必须知道
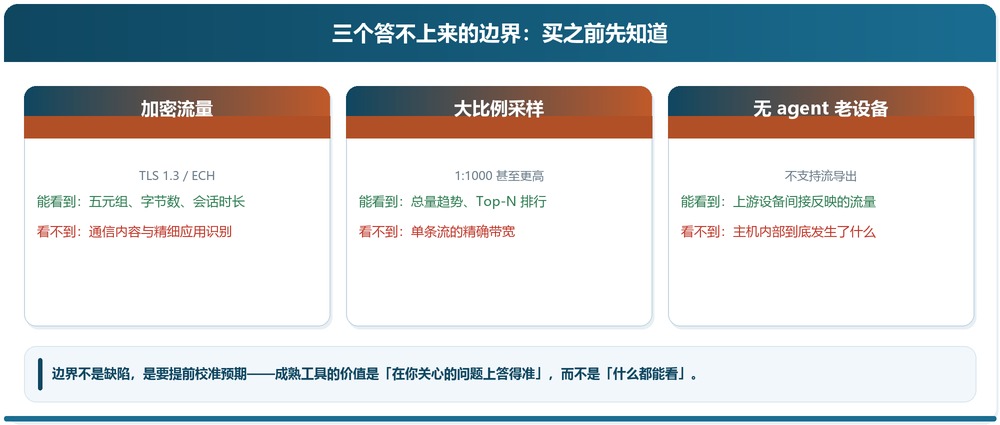
上面六个场景听着都很顺,但真实的流量分析有三个绕不过去的边界。选型时如果不提前知道,上线后就会变成「明明买了却查不出来」的尴尬。
边界一 · 加密流量。TLS 1.3 普及后,连 SNI 都可能被 ECH(Encrypted Client Hello)加密。结果是你能看到「谁和谁在通信、通了多少」,却看不到「通信内容是什么」,应用识别也随之退化。
边界二 · 大比例采样。为了减轻设备负载,很多网络按 1:1000 甚至更高的比例采样。采样后看总量趋势没问题,但拿去算「某一条流的精确带宽」就会失真——单流精度和采样率是一对矛盾。
边界三 · 无 agent 的老设备。没有 agent、又不支持流导出的老设备,只能靠上游设备的流数据「间接看见」,主机内部发生了什么,流数据是看不到的。
把这三个边界说清楚,不是为了唱衰工具,而是为了把预期校准到正确的位置:一个成熟的流量分析系统,卖点从来不是「什么都能看」,而是「在你关心的那几个问题上答得准、答得稳」。
参考来源
1. IETF RFC 7011《Specification of the IP Flow Information Export (IPFIX) Protocol》(流信息导出协议规范,定义了模板、数据集与传输方式)
2. IETF RFC 7012《Information Model for IP Flow Information Export (IPFIX)》(流信息的字段与语义定义,是「五元组 + 字节数 + 包数」这些指标的标准来源)
说明:文中六场景与三个边界为通用实践归纳,请结合自身网络规模与采集方式调整;协议字段与语义以 IETF RFC 为准,产品能力以官方页面为准。
一句话总结:网络流量分析工具能回答的问题,取决于你怎么设计指标——六类场景(谁占带宽、什么应用、是否异常、何时到顶、如何出账、如何取证)各有对应的指标与边界;选型时先对准「我要回答哪个问题」,再避开加密、采样、无 agent 这三个答不上来的边界。
延伸阅读
想把这六个场景对着自己的网络过一遍?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 流量分析工具能看出是什么应用吗?
答:能,但有条件。基于深度包检测(DPI)或设备侧应用分类,可以把流量归到具体应用或类别;但对加密流量,应用识别会退化为「端口 + 少量握手信息」的判断,准确率明显下降。所以「能不能识别应用」要问一句:在加密占比多少的情况下,准确率是多少。
- 采样率设多少才准?
答:没有统一答案,取决于你要回答什么。看总量趋势,1:1000 的采样通常够用;要算某条流的精确带宽或做精细计费,采样比例就得显著提高,甚至关闭采样。原则是:精度要求越高,采样率越不能低,同时要评估设备与存储能不能承受。
- 加密流量还能分析吗?
答:能分析「元数据」,分析不了「内容」。加密之后,五元组、会话时长、字节数这些仍然可见,所以「谁和谁通信、通了多少」依然能回答;但「通信内容是什么」以及精细的应用识别会失效。TLS 1.3 加上 ECH 之后,连 SNI 都可能被加密,识别难度进一步上升。
- 流数据和抓包(端口镜像)到底有什么区别?
答:流数据是设备对会话的「统计摘要」,轻量、可长期留存、适合趋势与排行,但看不到包内容;抓包是完整的包级记录,能看到内容与细节,但数据量极大、难以长期全量留存。实践中两者是互补的:平时用流数据看全局,定位到具体问题再对关键链路抓包。
- 只采 Top-N 够不够定位问题?
答:定位「谁占带宽」够,定位「为什么」不够。Top-N 告诉你「量级排行」,但要解释原因,还得结合应用识别、基线偏离和会话细节。建议把 Top-N 当作入口,而不是结论——它负责把你带到嫌疑对象面前,剩下的靠其他维度补齐。