网络嗅探器抓得到包,却定位不了问题:三个断层与补齐方式

AI 摘要
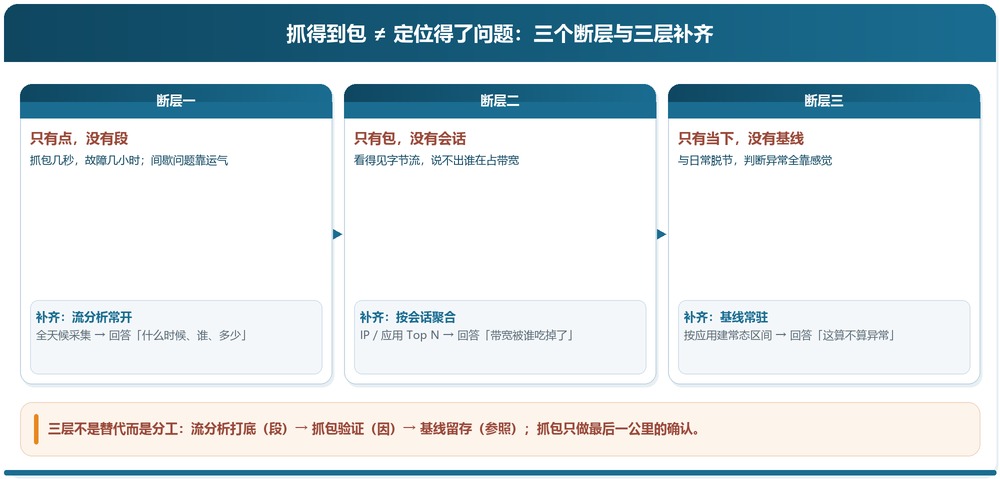
抓包工具抓得到包,定位不了问题,卡在三个断层:一是只有点、没有段——抓包是一次几秒到几分钟的采样,间歇性故障撞上采样窗口全靠运气;二是只有包、没有会话——原始报文里看不到按 IP、应用、会话聚合的视角,「谁在占带宽」答不上来;三是只有当下、没有基线——事后抓的包与日常没有关联,判断「这算不算异常」只能凭感觉。补齐方式也有三层:流分析常开打底(回答什么时候、谁、用了多少)、抓包定向验证(回答为什么)、基线长期留存(回答这是不是异常)。三层各管一段,才能把「抓得到」变成「定位得了」。
答案先说:网络嗅探器抓得到包、定位不了问题,不是因为工具不行,而是它只提供了一小段时间窗口内的原始报文——而排障要的是「什么时候、谁、为什么」。卡点集中在三个断层:只有点没有段、只有包没有会话、只有当下没有基线。
补齐也不靠换工具:流分析常开打底,抓包定向验证,基线长期留存——三层各管一段。这篇把三个断层逐个拆开,说明每一层该补什么、补到什么程度算够,末尾给一张对照表,可以直接拿去对现有的排障流程。
ManageEngine NetFlow Analyzer把这三层放在同一个平台里:流分析常开采集并按应用聚合,基线自动比对生成异常告警,需要时再对指定会话做定向抓包——三层各就各位,排障才能从「碰运气」变成按单推进。
核心要点
- 抓包擅长回答「这个报文长什么样」,不擅长回答「什么时候、谁、为什么」——三个断层就出在这里。
- 断层一:只有点没有段。抓包是几秒到几分钟的采样,间歇性故障撞上采样窗口全靠运气。
- 断层二:只有包没有会话。原始报文里没有按 IP、应用聚合的视角,「谁在占带宽」答不上来。
- 断层三:只有当下没有基线。没有历史可比,「这算不算异常」只能凭感觉;补齐靠流分析打底 + 抓包验证 + 基线留存。
抓包工具能给你什么,给不了什么
先把期待摆正。抓包工具的长处是很确定的:它能让你看到报文级别的细节——重传、乱序、握手失败、TLS 告警,这些是任何聚合视图都给不了的。它也足够轻,装在一台机器上就能开。所以它不是「不好用」,而是「管得太窄」。
它给不了的东西同样明确:第一,它只在被打开的那段时间里记录,而故障不会挑时间;第二,它记录的是原始报文,不负责把报文归并成「谁在用、用在哪」;第三,它不知道昨天同一时刻是什么样,所以它判断不了「现在算不算不正常」。三个「给不了」正好对应三个断层——排障卡住,往往不是抓得不够细,而是这三段是空的。
断层一:只有点,没有段
第一个断层是时间。抓包是一次采样:打开、抓几十秒到几分钟、保存、分析。而用户报的「下午卡」,往往持续一两个小时、间歇性发作。用几分钟的采样去覆盖两小时的间歇故障,命中率全看运气——更麻烦的是,抓不到的时候你会误判成「没有异常」,而不是「没抓到」。
补这一段靠的是常开的汇总视图:让交换机把流信息(NetFlow / sFlow / IPFIX)持续发到分析平台,接口级、IP 级、应用级的流量全天候留存。它不记录报文内容,但记录了「什么时候、哪条链路、多少流量」——这一步先把故障从「两小时」压缩到「某十分钟」,抓包再去这十分钟里做定向验证。先有段,再取点,顺序反了就是现在这种抓不到的局面。
断层二:只有包,没有会话
第二个断层是视角。原始报文是字节流的集合,你可以按五元组过滤,但要回答「带宽被谁吃掉了」,得先自己把成千上万条流归并成会话、再排序——这活儿人工做一遍要一下午,而问题往往要求十分钟内给答复。
补齐靠的是聚合口径:按 IP 出 Top N、按应用分类、按方向区分上下行,并且这些聚合要能直接对着时间轴看趋势。这一步正是流量分析要解决的事——把「谁在用什么」变成一张随时能调出来的榜,而不是一次性的脚本输出。有了聚合视图,抓包才有的放矢:先定位到具体的 IP 与应用,再去抓那个会话的报文细节。
断层三:只有当下,没有基线
第三个断层是参照系。抓到异常流量之后,最常被问的问题是「这个量正常吗」——如果没有历史数据,这个问题只能靠经验回答,而经验在不同人嘴里答案不同。更典型的是慢速渗漏:某个备份任务悄悄把窗口从凌晨挪到了上午,流量峰值抬高了两成,但没有任何一刻「看起来像故障」。
基线要按应用而不是按接口建:同一台服务器上跑着数据库、备份、监控上报,接口总量平稳不代表每一类流量都平稳。把流量按应用打标、留存日/周周期的常态区间,异常检测才有依据——偏离基线两成就告警,比等用户投诉早得多。这一层是三层里最容易被跳过、也最值钱的一层:它把排障从「救火」变成「提前发现」。
三层补齐:流分析打底、抓包验证、基线常开
三层的关系不是替代,而是分工:流分析回答「什么时候、谁、多少」,抓包回答「为什么」,基线回答「这算不算异常」。下表把三个断层与对应的补齐方式、验收动作对齐——每一行的右列答不上来,就说明这一层还没真正用起来。
| 断层 | 现象 | 补齐方式 | 一条可执行的验收动作 |
|---|---|---|---|
| ① 只有点,没有段 | 抓包几秒,故障几小时;间歇问题抓十次不中一次 | 流分析常开:全天候、全接口采集,先定位时间窗 | 随便挑一次「用户说卡」的投诉:能回看当时哪条链路、哪个 IP 在跑吗 |
| ② 只有包,没有会话 | 看得见字节流,说不出谁在占带宽、走向哪里 | 按会话聚合:按 IP / 应用 / 方向出 Top N | 问一句「现在带宽被谁吃掉了」:五分钟内能出前五名吗 |
| ③ 只有当下,没有基线 | 事后抓的包与日常脱节,判断异常全靠感觉 | 基线留存:按应用建常驻基线,异常自动比对 | 查上周同一时段:应用流量基线是多少、有没有偏离 |
三层里最容易被误解的是深度包检测的位置:它不是「更高级的抓包」,而是把报文识别能力叠到流上——识别出应用之后,流量就能按业务分类,基线与告警也才有业务语义。抓包负责某一次的具体原因,深度包检测负责让长期的流数据「认识应用」,两者解决的是不同层面的问题。
参考来源
1. RFC 7011《Specification of the IPFIX Protocol for the Exchange of Flow Information》(流信息导出与模板机制的国际标准,流分析采集的协议基础)
2. RFC 5470《Architecture for IP Flow Information Export》(流信息的定义与导出架构,说明「流」与「报文」的口径差异)
说明:三层补齐为通用实践归纳,具体采集方式请结合设备能力与合规要求选择;产品能力以官方页面为准。
一句话总结:网络嗅探器抓得到包、定位不了问题,缺的是「段」「会话」「基线」这三样——流分析补时间、聚合补视角、基线补参照,抓包才能从「碰运气」变成「最后一公里的确认」。
延伸阅读
想把三层补齐?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 抓包和流分析需要都装吗,还是选一个就行?
答:看你要回答什么问题。只想在出事时看报文细节,抓包够用;想回答「什么时候、谁、为什么慢」,两者都要——因为流分析给的是时间和对象,抓包给的是原因。实务上的分工是:流分析常开、抓包按需。全接口全时段抓包既存不下也看不完,而流数据的体量小几个数量级,可以长期留存。
- 流分析会不会漏掉报文级的问题?
答:会——流数据是聚合后的统计,重传、乱序、握手失败这些细节看不到。但它的价值在于「快速把范围缩小」:先确定是哪条链路、哪个 IP、哪个应用、哪十分钟,再用抓包去这段时间窗口里取细节。漏掉的细节不是问题,问题是只用一种手段硬扛所有场景。
- 基线要跑多久才有参考价值?
答:至少覆盖一个完整的业务周期。办公网络通常两周到一个月能看出日/周规律;有明显月度波动的业务(对账、备份、结账日)需要两三个月。起步阶段可以先用「同周同期对比」凑合,但真正的基线要能自动更新——业务量在涨,一年前的基线拿到今天用只会天天误报。
- 抓包影响性能吗,能不能长期开着?
答:不能长期全量开。全量抓包对设备 CPU、存储和镜像端口带宽都有明显开销,通常只在定位阶段定向开启,抓完即关。需要「长期可见」的部分交给流分析与定期采样:常开的是汇总,按需的是细节——这个分工既保住了可见性,也不至于把设备拖垮。
- 三层补齐先从哪一层做起?
答:从流分析开始,性价比最高:一次配置就能覆盖全部接口与全部 IP,马上能回答「谁在占带宽」这个最高频的问题。第二步补基线——有了流数据,基线就是顺带留存的事;最后才是深度包检测之类的增强能力。顺序反过来(先上复杂识别、再补基础采集)最容易做成半拉子工程。