网络流量分析怎么定责:从微软 11·12 全球宕机说起

AI 摘要
11 月 12 日美东时间,Microsoft 365、Outlook、Teams 等多项服务中断数小时,微软给出的原因是「多台服务器因负载过高意外离线,并非访问流量激增」——一句话把「流量」和「负载」两件事分开了。本文以这次事故为切口,讲清流量问题与负载问题在监控面板上为什么长得几乎一样,给出用接口带宽利用率、并发会话数、TCP 重传率与 Top Talkers 四组数据做故障定责的五步法,以及结论落地时只有限流错峰、扩容链路、移交证据三条路。核心结论:定责靠的不是更强的工具,而是能被三方同时复核的同一份 flow 数据。
答案先说:故障定责的僵局几乎都是同一句话——应用方说「网络卡」,网络方说「服务器慢」,各拿一张面板截图,谁也说服不了谁。打破僵局不需要解密,也不需要抓包,只需要 flow 数据:它同时记录了谁、跟谁、传了多少、什么时候,三方看到的是同一份记录。
11 月 12 日美东时间,Microsoft 365、Outlook、Teams 等多项服务中断数小时,Outlook 的问题报告量一度冲到 13.8 万起。微软给出的原因是「多台服务器因负载过高意外离线,并非访问流量激增」——一句话把「流量」和「负载」拆开了,而这两件事在面板上长得极像,定性一错,处置就全错。
下面从网络流量分析的视角给一套五步定责法,把「互相甩锅」变成可复核的证据链。
核心要点
- 流量打满看接口吞吐贴着上限走平,负载过高看主机资源与队列,两种曲线形状完全不同。
- 三个证据位:带宽利用率、并发会话数、TCP 重传率。同向变化指向流量,反向指向主机。
- 找突变比找最大有用:故障时刻新冒出来的会话,比常年排第一的备份更可疑。
- 没有基线就没有「异常」:和上周同一时段比,不和昨天比,也不和平均值比。
- 结论落地只有三条路:限流错峰、扩容链路、移交证据链,选错等于白查。
一、微软那句「并非访问流量激增」,为什么值得记下来
事实是:美东 11 月 12 日,Microsoft 365、Outlook、Teams 等应用中断数小时,Outlook 的问题报告量在美东下午 1 点前后达到 138058 起,傍晚回落到约 34490 起;Microsoft 365 到 17 点 47 分降至近 13000 起、Teams 为 763 起。中断还波及 OpenAI、Anthropic 相关服务所用的连接组件。微软当天的定性是「多台服务器因负载过高意外离线,并非访问流量激增」。(重庆日报 · 2026-11-13 报道)
这句话重要,是因为定性直接决定动作:定性成「流量打爆」,动作是限流、扩带宽、加 QoS;定性成「负载过高」,动作是查进程、扩实例、调超时与重试。方向错了,钱花了、设备上了,故障照旧。而且「并非流量激增」这个结论本身可验证——打开接口吞吐与会话数据,五分钟就能证实或推翻。
二、流量问题和负载问题,在监控面板上长得几乎一样
两类故障的外部表现都是「慢」和「超时」,只盯一个指标几乎必然误判。把六个观测点并排放,区别才显出来:
| 观测点 | 流量打满(链路侧) | 负载过高(主机侧) |
|---|---|---|
| 接口带宽利用率 | 贴近上限并高位走平 | 未必高,仍有下行余量 |
| 并发会话数 | 随流量同步抬升 | 抬升后突跌——队列满、拒绝连接 |
| TCP 重传与 RTT | 全链路普遍上升 | 集中在特定端口,其他正常 |
| Top Talkers | 出现新名字或排序突变 | 名单稳定,总量也不高 |
| 受影响范围 | 走这条链路的都慢 | 集中在单个服务或集群 |
| 限流试验 | 限掉大流量后立刻缓解 | 无效,甚至更慢(重试放大) |
这张表的用法是反向读数:带宽不高但重传暴涨,可排除链路拥塞;会话数在故障前一分钟断崖下跌,多半是后端拒绝服务而非丢包;限流之后更慢,说明瓶颈不在带宽。定责不是找「谁最像」,而是找「哪组证据互相矛盾」。
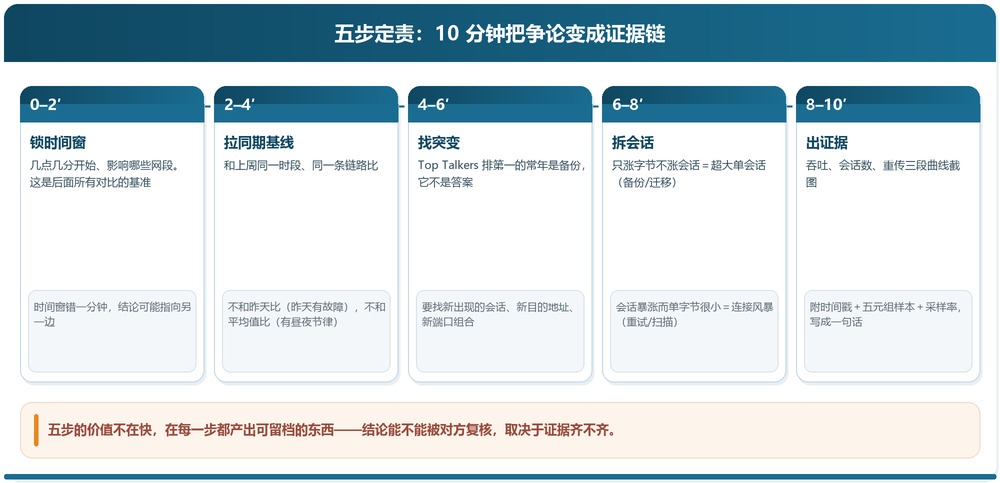
三、五步定责:10 分钟把「互相甩锅」变成证据链
前提是出口与关键链路已开启 flow 导出(NetFlow v9、IPFIX、sFlow 均可),采样率记在案。五步走:
第 1 步(0–2 分钟)锁时间窗。确定「慢」从几点几分开始、影响哪些网段。这一步是后面所有对比的基准,时间窗错一分钟,结论就可能指向另一边。
第 2 步(2–4 分钟)拉同期基线。和上周同一时段、同一条链路比。不和昨天比——昨天的故障会污染基线;也不和平均值比——业务有昼夜节律。
第 3 步(4–6 分钟)找突变。Top Talkers 排第一的常年是备份,它不是答案。要找的是故障时刻新出现的会话、新目的地址、新端口组合。
第 4 步(6–8 分钟)拆会话。只涨字节不涨会话,通常是一个超大单会话(备份、迁移、同步);会话暴涨而单会话字节很小,是连接风暴(重试、扫描、短连接)。两者处置方式完全相反。
第 5 步(8–10 分钟)出结论并留证。接口吞吐、会话数、重传三段曲线截图,附时间戳、五元组样本与采样率,写成一句话——对方能否复核,就看这三样齐不齐。
四、结论落地只有三条路,选错一条等于白查
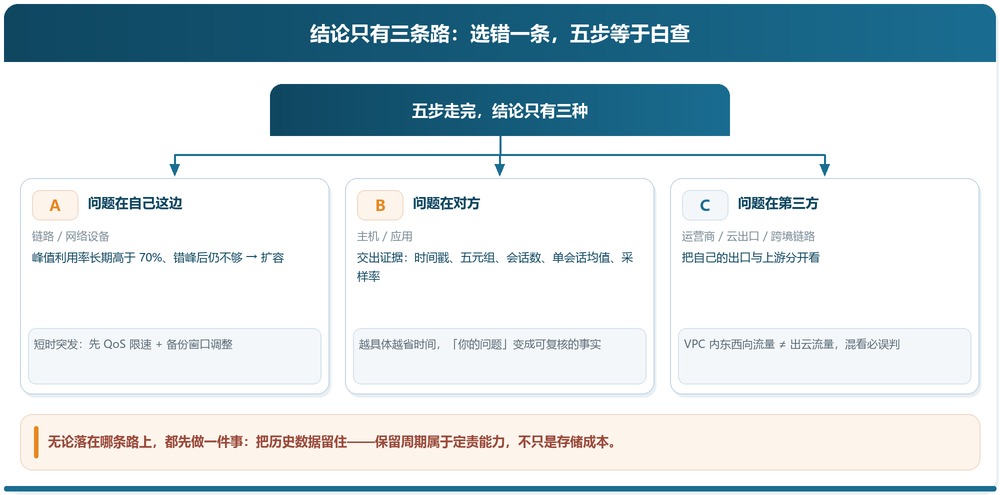
五步走完,结论无非三种,对应三种动作,不能混:
其一,问题在自己这边(链路或设备)。峰值利用率长期高于七成、错峰后仍不够,才是扩容信号;短时突发先做 QoS 限速与备份窗口调整。把扩容当第一反应,往往是把钱花在不拥堵的路上。
其二,问题在对方(主机或应用)。把证据交出去,越具体越省时间——「10:42 起,A 网段到 B 集群 8080 端口的会话数从 300 涨到 9000,单会话均值 1.2KB,重传率无变化」,这一句比十张截图有用。
其三,问题在第三方(运营商、云出口、跨境链路)。这时要能把「自己的出口」与「上游」分开看——VPC 内的东西向流量和出云流量是两套账,混看必误判。
无论落在哪条路上,都要提前做一件事:把历史数据留住。很多团队复盘时才发现明细只留了 24 小时,而故障发生在三天前。保留周期属于定责能力,不只是存储成本——用 带宽利用率 做接口级长期留存、按需保留会话明细,是成本与能力的折中。
这些动作在 ManageEngine NetFlow Analyzer 里是同一个控制台的事:从接口吞吐曲线下钻到应用与会话明细,按基线偏离告警,再把某段时间的明细留成证据。定责缺的从来不是算力,而是一份三方都认的记录。
参考来源
1. IETF RFC 7011《Specification of the IP Flow Information Export (IPFIX) Protocol》:流量元数据导出的标准格式,规定了五元组、字节数、时间戳等字段的语义,是本文「定责可比对」的技术基础。
2. IETF RFC 3954《Cisco Systems NetFlow Services Export Version 9》:NetFlow v9 的模板化导出机制,现网设备最普遍的 flow 格式,采样率与聚合粒度都在这里定义。
说明:文中阈值为典型场景经验值(如接口利用率七成),不同链路与业务容忍度差异较大,请以自身 flow 基线与业务 SLA 为准。
一句话总结:定责的答案不在「谁更强」,而在「哪份数据能被三方同时复核」——flow 只记录事实、不站队;有了它,「是不是流量打爆的」就从一场争论,变成一次读表。
延伸阅读
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 只开了 SNMP,没配 NetFlow,还能做定责吗?
答:能做一半。SNMP 给的是接口级计数——总吞吐、错包、丢包、up/down,足以回答「链路有没有打满」;但回答不了「是谁打满的」。会话级定性必须靠 flow,两者是互补关系,不是替代关系。
- 采样率 1:1000,结论还可信吗?
答:总量与趋势可信,抽样误差主要体现在 Top Talkers 的排序上——第 3 名和第 7 名可能互相换位。定责时要看量级差(十倍、百倍的区别),而不是精确到个位的数值,并在结论里写明采样率,让对方知道这个结论的精度边界。
- 故障已经恢复,还能回溯吗?
答:取决于保留周期。通常接口级聚合数据保留天数长、会话明细保留天数短,建议让保留窗口至少覆盖一个完整业务周期(月度结算、备份轮次、版本发布节奏)。预算有限时,优先拉长接口级数据的留存,会话明细按需短留。
- 出口流量同时在涨,怎么分是业务增长还是异常?
答:看增长形状,不看增长数量:平滑抬升且与工作时间相关,多为业务增长;阶梯式突跳、集中在夜间或整点,多为定时任务或异常;新建目的地址高度集中的,优先怀疑外联或回传。三种形状在曲线上完全不同。
- 结论对方不认,怎么办?
答:先把口径对齐:同一条链路、同一个时间窗、同一个采样率、同一个聚合维度(按会话还是按应用)。多数分歧不是数据不对,而是两边统计的口径不同——这也是为什么结论里要写清这四项。