
网络监控工单只报设备名?OpManager 关系数据同步让根因一步可见

AI 摘要
本文指出ITSM工单只带设备名、缺少CI关系数据,会导致排障慢、优先级错、只能被动响应。OpManager新增关系数据同步能力,通过“四维关系映射法”(Layer2拓扑、上联依赖、虚拟化、应用层)把设备依赖随工单同步到ServiceDeskPlus。文章解析了工作链路、实战场景、价值量化及四步落地清单,并给出三个常见误区,帮助运维团队缩短MTTR,把拓扑经验沉淀为系统数据。
一句话结论:监控告警与ITSM工单之间最大的缺口,不是「有没有告警」,而是「告警的这台设备依赖谁」。ManageEngine OpManager新增的「关系数据同步」能力,把设备的依赖关系映射随工单一起送达,让根因定位从「逐个试错」变成「顺藤摸瓜」。
核心要点
·痛点:ITSM工单只带设备名,缺少设备依赖(CI关系)数据,导致排障慢、优先级错、只能被动响应。
·新功能:OpManager把Organizationmap(组织映射)连同设备数据,同步到ServiceDeskPlus工单。
·数据来源:「四维关系映射法」——Layer2拓扑、上联依赖、虚拟化监控、应用层关系。
·版本要求:ServiceDeskPlus本地版 12.8.300+ ,云版 12.8.628+ 0
·价值:工单自带上下游上下文,缩短MTTR,并把老员工的拓扑经验沉淀为系统数据。

一、为什么「只报设备名」的工单会让排障越走越远
ITSM(IT服务管理)工具的价值,在于把监控告警转化为可跟踪、可协作、可复盘的工单流程。但这条流程有一个常被忽视的前提:工单里必须带上设备之间的依赖关系(CI关系)数据。一旦缺失,工单就退化成一张「设备点名单」——团队只知道哪台设备出问题了,不知道它连着谁、被谁依赖。
按ITIL4的事件管理与问题管理实践,事件的快速恢复依赖对「影响范围」的判断,而影响范围的判断又依赖配置项(CI)之间的关系数据。缺少这层数据,流程再规范也难以命中根因。具体来说,缺失关系数据会带来五个连锁问题:
·排障被拖慢:看不到上游或下游关系,只能处理表象而非源头,事件解决时间被拉长。·优先级排不准:所有事件看起来彼此孤立,人力容易消耗在次要问题上,高影响故障被搁置。·主动管理做不起来:本可提前发现的潜在问题,只能在故障显现后才被动响应。·运维孤岛:网络团队与IT服务团队各看各的数据,重复劳动、沟通断层、响应变慢。
小故障升级成大中断:看不清设备如何互联,小事件可能因依赖关系未被处理而扩散。
这也是为什么网络监控做得再细,故障响应依然可能卡在最后一公里——数据有了,但没有流到真正处理问题的人手里。
二、OpManager同步关系数据做了什么
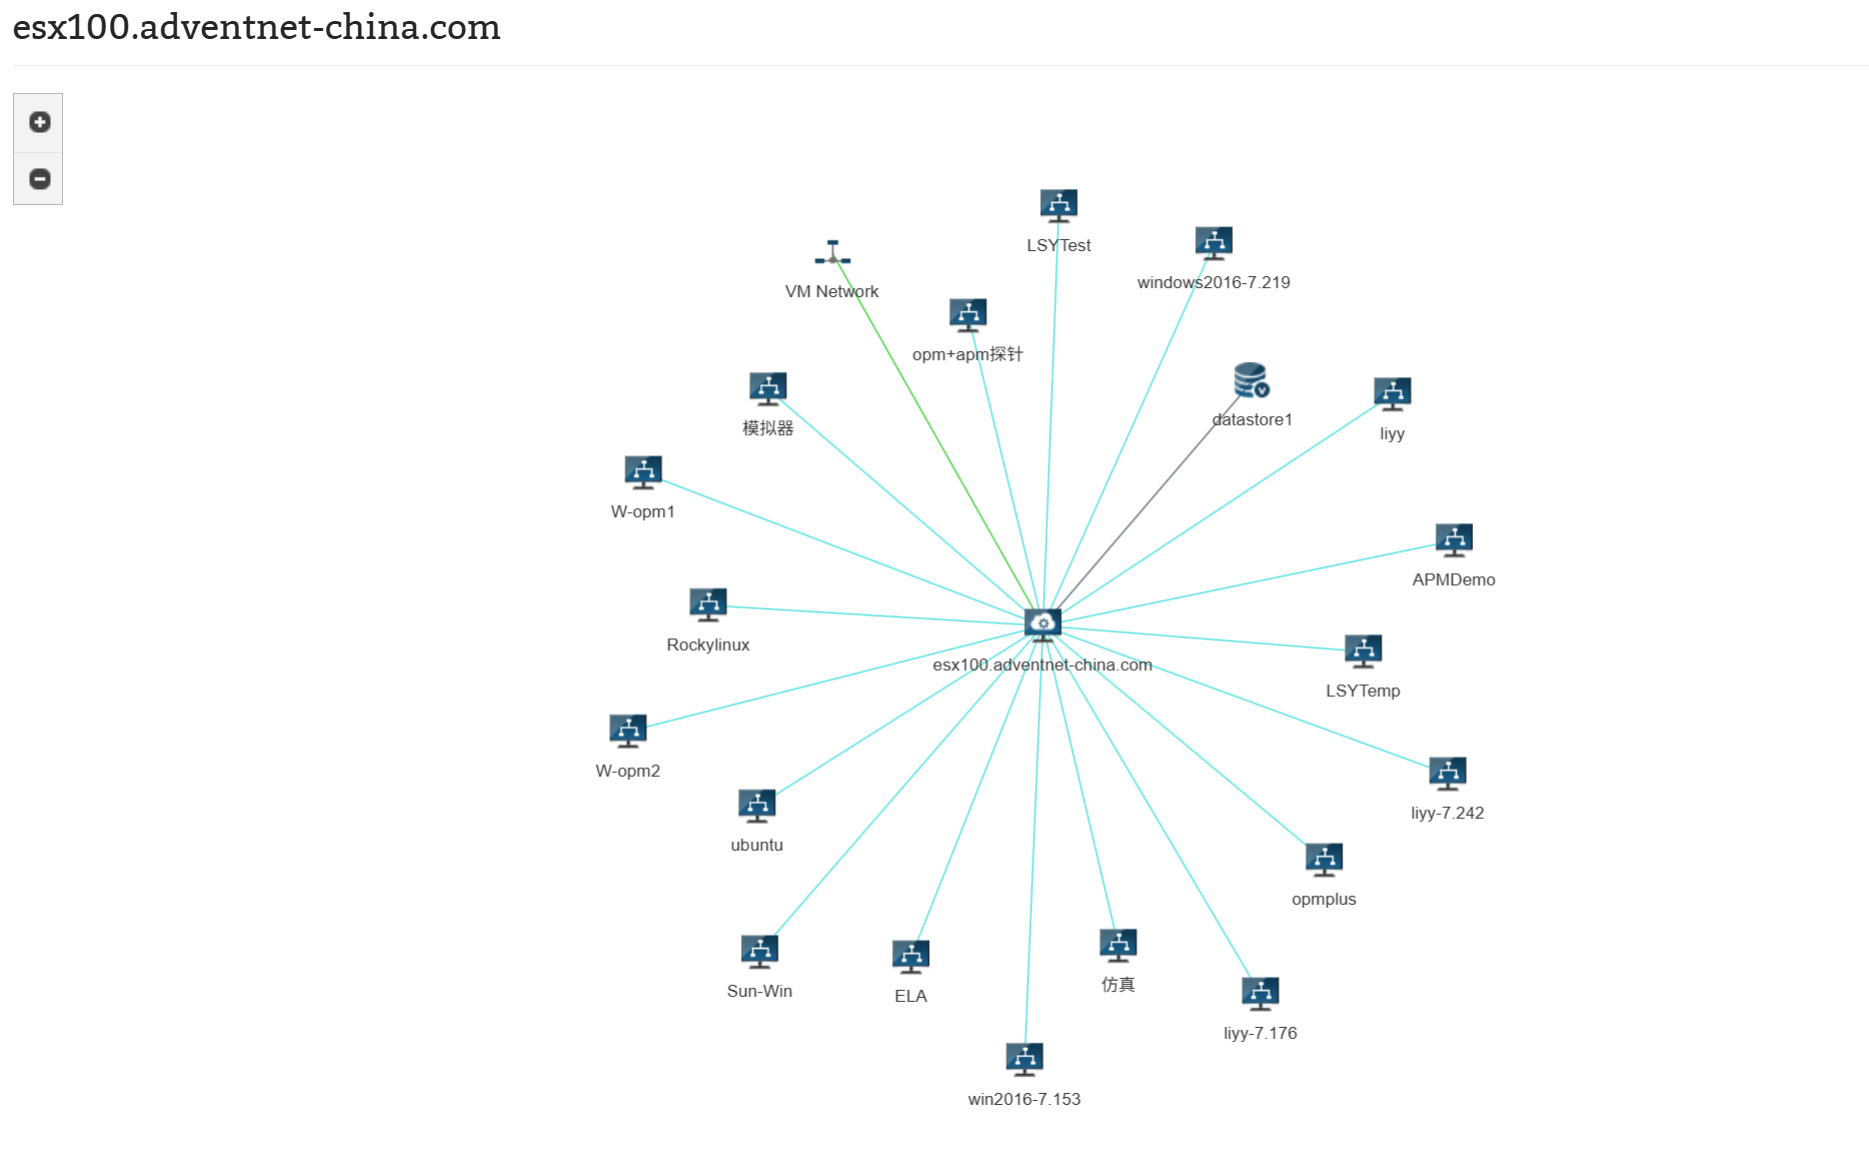
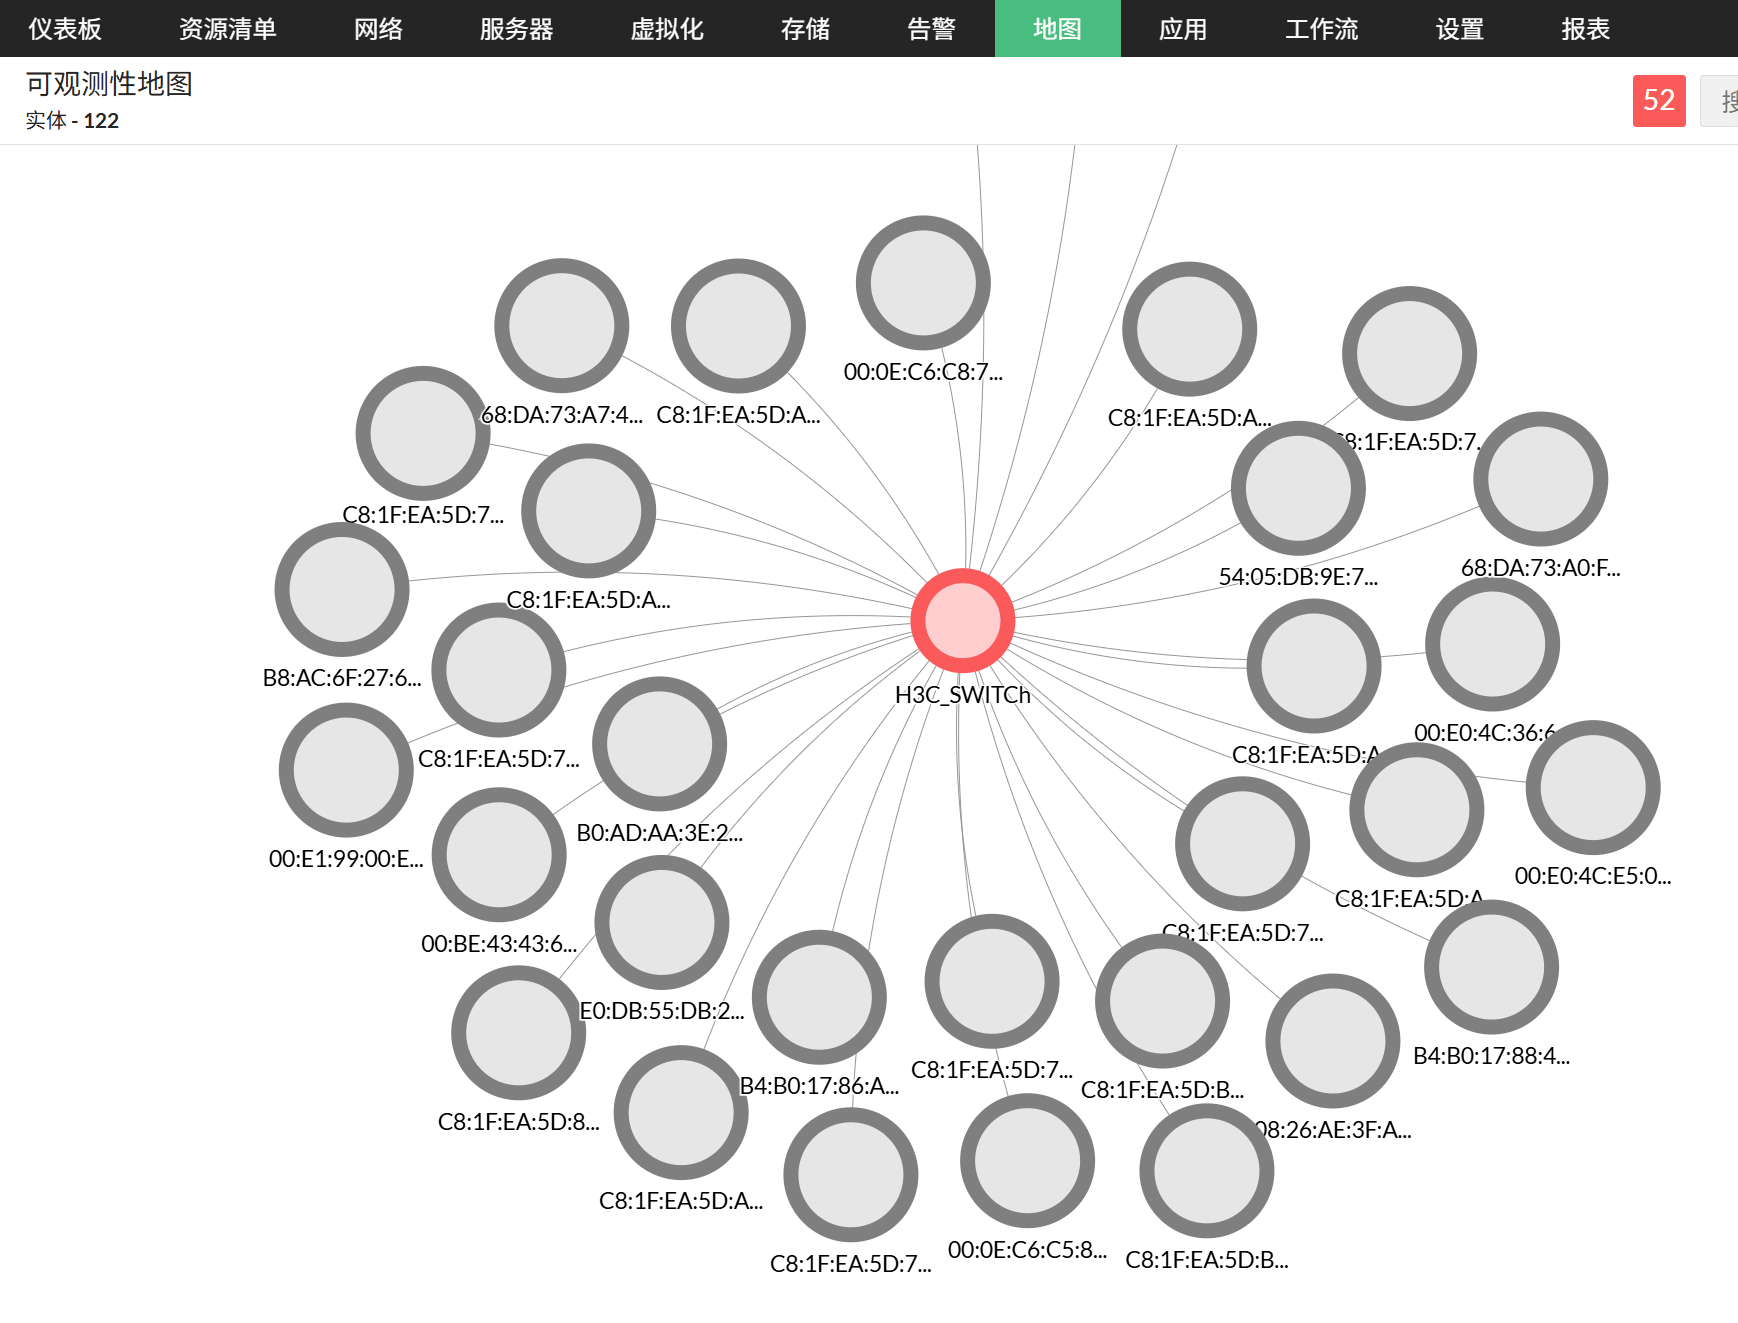
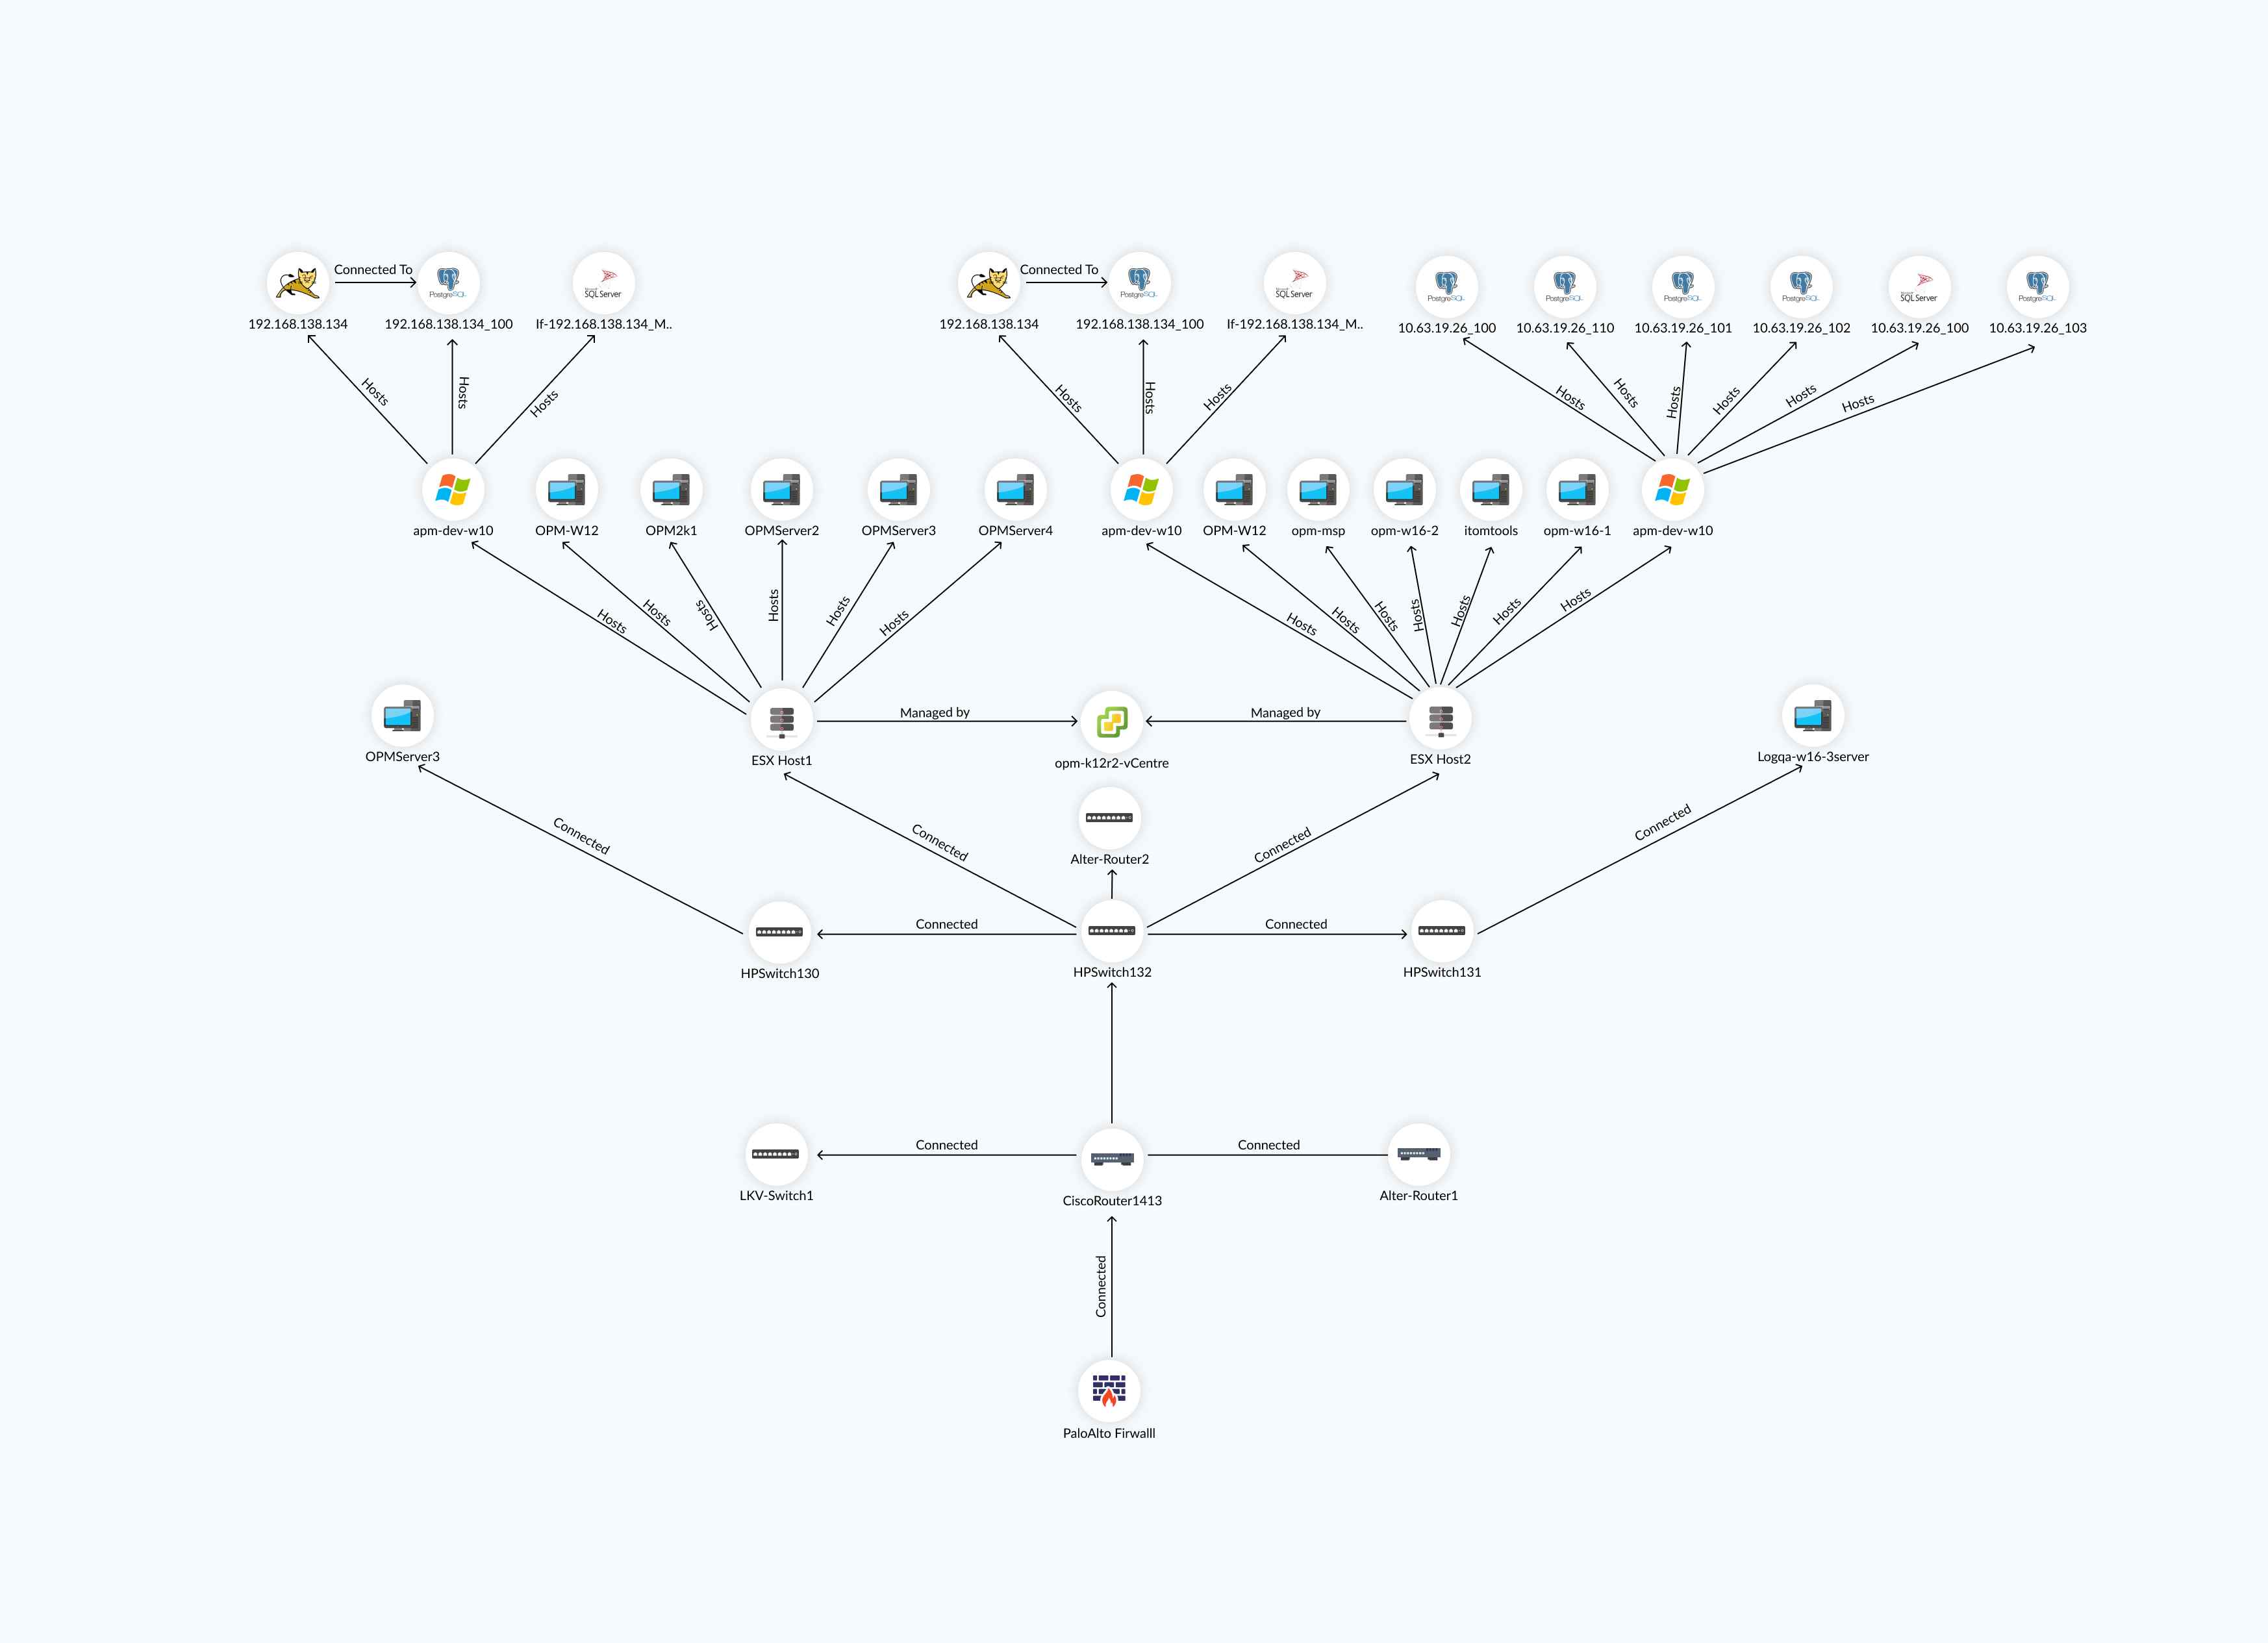
OpManager本身就会综合多个模块的数据,生成一张「组织映射」(Organizationmap),直观呈现设备之间的相互依赖与关联。这张图是网络可视化的核心载体,把抽象的设备依赖变成可读、可追溯的拓扑视图。
此次新增的能力,是在既有的ServiceDeskPlus集成基础上,把这张关系映射图连同设备数据一起同步过去。同步之后,每当针对某台设备产生工单或事件,该设备的关系映射会随工单一起呈现——支持方打开工单,不知道「什么坏了」,还能看到它连了谁、被谁依赖、影响到哪些系统。
需要注意,这项能力是既有「Layer2关系同步」的增强:原有能力只覆盖数据链路层的连接关系,新能力把范围扩展到上联依赖、虚拟化与应用层。当关系数据不再只停留在二层链路,工单上的定位精度才真正上一个台阶。
三、「四维关系映射法」:关系数据从哪来
这套关系映射的准确性,来自四个维度的数据源共同拼接。我们把它概括为「四维关系映射法」——二层拓扑定连接、上联依赖定层级、虚拟化定资源、应用层定业务:
| 数据维度 | 采集内容 | 解决什么盲区 |
|---|---|---|
| Layer 2 拓扑 | 通过 CDP、LLDP、IP 路由、转发数据库、ARP 等协议,从种子路由器发现直连设备 | 看清设备之间「直接连在哪」 |
| 上联依赖 Uplink | 识别设备的父设备(parent)与子设备(child)层级依赖 | 看清「谁挂了会带崩谁」 |
| 虚拟化监控 | 主机、Hypervisor、虚拟机、数据存储及其依赖关系 | 看清物理机上承载的虚拟资源 |
| 应用层关系 | 应用发现与依赖映射(ADDM)、服务器一应用关系、手动依赖映射、云服务父子关系 | 看清故障会影响哪些业务应用 |
单靠人工维护的网络拓扑软件很难达到这个精度:设备一增删、链路一调整,静态图纸就会失真。四维关系映射法的价值,在于让关系数据「自动采集、持续更新」,最终作用于网络管理的每一个环节。
四、工作原理解析:一条完整的发现链路
四个维度的数据并不是简单相加,而是按链路逐层关联。以一次典型的发现过程为例:
| 步骤 | 动作 | 产出 |
|---|---|---|
| 1 | 在种子路由器上执行 Layer 2 发现(CDP/LDP/IP 路由等) | 直连设备清单 |
| 2 | 对核心交换机运行端口扫描(Switch Port Mapper) | 下级连接的服务器、防火墙、打印机等 |
| 3 | 在服务器与桌面设备上运行 ADDM | 发现其上运行的应用 |
| 4 | 使用上联依赖数据继续向下追溯 | 识别子设备层级 |
| 5 | 识别虚拟化环境并补充映射 | 主机、Hypervisor、数据存 |
这条链路串起来,网络管理员就获得了从硬件层一直到应用层的完整视图——这正是「全栈可观测」在网络监控场景里的具体落地,而不只是画出一张拓扑图。
五、实战场景:从「重启没用」到「顺藤摸瓜」
原文给出的例子很有代表性。假设某台交换机失去响应,NOC团队先用工作流自动化尝试重启,或回滚某个配置,都没有效果,甚至可能被迫派人现场检查。
如果这台交换机的关系映射已经随工单同步到ServiceDeskPlus,团队就能直接看到:它的父设备——一台核心路由器——同样处于down状态,而路由器的异常又源于一次防火墙配置问题。排查方向从「这台交换机怎么了」变成「上游链路为什么断」,根本原因分析也就从「逐个试错」变成「顺藤摸瓜」。
对于只有1- 2人的运维团队,这种「工单自带上下文」的价值尤其明显:它把原本依赖老员工口头传递的网络拓扑经验,固化成了系统里可查阅的关系数据,降低了对个别人员经验的依赖,也让人员轮换与交接不再成为风险点。
六、价值量化:同步前 vs 同步后
| 维度 | 同步前 | 同步后 |
|---|---|---|
| 工单信息 | 只有告警设备名 | 设备+上下游依赖关系 |
| 排障方向 | 从告警设备逐个试错 | 直接看向上游根因 |
| 优先级判断 | 事件相互孤立,难分主次 | 按影响的关键系统排序 |
| 团队协作 | 网络与IT服务团队数据割裂 | 共享同一份依赖视图 |
| 经验沉淀 | 依赖个人经验口头传递 | 固化为可查阅的关系数据 |
| MTTR定位 | 依赖靠经验与沟通 | 上下文即时可得,定位更快 |
归纳起来,这项能力带来六点收益:上下文更完整的故障管理、更快的根因分析、更低的MTTR、面向主动监控的统一视图、更聚焦的资源投入,以及跨IT团队(网络监控与IT服务管理)的协作改善。
七、落地清单:四步实施路径
| 步骤 | 动作 | 验收标准 |
|---|---|---|
| 1.检查版本 | 确认 ServiceDesk Plus 版本达线(本地版 12.8.300+/云版 12.8.628+) | 版本号达标,集成通道可用 |
| 2.校准数据 | 核对 Layer 2 拓扑与上联依赖是否与实际网络一致 | 核心链路的父子关系无缺失 |
| 3.开启同步 | 在既有集成中启用关系映射同步 | 组织映射随工单下发 |
| 4.真实验证 | 用一次真实工单验证「打开工单即见上下游」 | 工程师无需额外查询即可看到依赖 |
关系数据的质量决定同步的价值,因此第二步的数据校准值得多花一点时间。如果拓扑本身失真,同步过去的也是一张错的图。
八、三个常见误区
误区一:「有了监控就不需要关系数据」。监控解决的是「是否异常」,关系数据解决的是「异常影响谁」。两者缺一,工单就只剩下一半信息。
误区二:「CMDB里已经有人工维护的依赖」。人工维护的CMDB最大挑战是时效性——网络一变,图纸就过期。自动采集的关系数据正是为了解决这个持续更新问题。
误区三:「小团队用不上」。恰恰相反,小团队最缺经验沉淀,把依赖关系固化进工单后,处理故障不再依赖个别老员工的经验,对轮换与交接尤其友好。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQ)
- 关系数据同步支持哪些ITSM工具?
答:当前面向ManageEngineServiceDeskPlus,分为本地版与云版两个版本通道,对版本号有明确要求(本地版12.8.300+、云版12.8.628+)。
- 它和原来的Layer2关系同步有什么区别?
原有的二层同步只覆盖数据链路层连接。新能力把范围扩展到上联依赖、虚拟化和应用层,形成从硬件到应用的全栈关系映射,定位精度更高。
- 关系映射图包含哪些设备信息?
答:除设备本身外,还包括IP、设备类别、上联依赖关系,以及通过二层拓扑、虚拟化监控、应用依赖映射等模块采集到的关联数据。
- 这个功能能自动判断根因吗?
答:它不直接下根因结论,而是把上下游依赖关系作为上下文随工单呈现。判断仍由人做,但排查范围从「一台设备」缩小到「一条链路」,效率显著提升。
- 关系数据不准怎么办?
答:先校准基础数据——确认二层拓扑与上联依赖和实际网络一致,再开启同步。关系数据的准确性是同步价值的前提,建议在正式启用前做一次链路核对。
- 小团队没有专职NOC,值得用吗?
答:值得。小团队最缺的是经验沉淀,把依赖关系固化进工单后,处理故障不再依赖个别老员工的经验,对人员轮换和交接尤其友好。

