
为什么你的网络监控总是误报?误报背后的 4 个真相

AI 摘要
网络监控误报多,问题往往不在“监控太灵敏”,而出在阈值设置、监控指标选择、告警关联和根因判断四个环节:固定阈值不懂业务波动、监控项越多噪音越大、一个故障被放大成几十条告警、看到的只是症状而非根因。本文逐条拆解真相,并给出“重梳阈值、清理低价值告警、建立告警关联、从看告警转向找根因”四步治理方法,帮运维把噪音降下来、把排障时间省出来。
先给结论:网络监控误报多,通常不是“监控太灵敏”,而是阈值设置、监控指标选择、告警关联和根因判断这四个环节出了问题。静态阈值遇到业务高峰容易频繁报警,监控项过多会放大噪音,缺少拓扑关联会让一个故障变成多条告警,而没有根本原因分析时,运维人员只能在大量“症状”中寻找真正的问题。
真正有效的治理思路,不是简单把阈值调高,而是让系统更准确地判断什么是异常、哪些告警属于同一事件,以及哪一个问题最值得优先处理。

一、真相一:很多误报,源于“固定阈值”不懂业务波动
最常见的场景是:CPU 超过 90%就报警、接口利用率超过 80%就报警、响应时间超过固定值就报警。
这种规则简单、容易配置,但网络运行状态并不是恒定不变的。工作日和周末、白天和夜间、业务高峰和低谷,网络监控指标本身就会发生变化。如果某项指标平时夜间只有 20%,高峰期稳定在 85%,统一静态阈值就可能在高峰期不断产生告警;反过来,阈值设得过高,又可能错过真正的异常。
因此,降低误报的第一步不是“少监控”,而是让阈值更接近真实业务基线。对于具有明显周期性的指标,应关注正常波动范围和异常偏离程度,而不是只盯着一个固定数字。
二、真相二:监控项越多,不代表监控越有效
很多企业部署网络监控软件后,会把能采集的指标全部打开:接口状态、带宽、CPU、内存、磁盘、响应时间、服务状态……结果是数据越来越多,告警也越来越多。
问题在于,并不是每个变化都值得立即通知运维人员。例如,一台设备某项资源短时间波动,可能对业务完全没有影响;但核心链路持续丢包,即使设备仍然“在线”,也可能已经影响多个业务系统。
因此,建议把监控指标按业务影响分层:第一层关注可用性和核心链路,第二层关注性能异常,第三层用于趋势分析和容量规划。真正影响业务、并达到持续异常条件的事件,才应该进入高优先级告警。
三、真相三:一个故障,可能被监控系统放大成几十条告警
假设核心交换机发生故障,下游交换机、服务器和接口可能同时失联。如果监控系统把这些变化都当成独立事件,运维人员看到的可能是几十条告警,但实际上它们可能只是同一个故障的连锁反应。
这时,问题已经从“误报”变成了“重复告警”。真正需要的是告警关联和拓扑感知:先判断设备之间的依赖关系,再区分根因和影响。
OpManager 的告警机制可以基于设备状态、性能阈值、SNMP Trap 等信息产生告警;在根本原因分析场景中,还可以在集中视图中聚合设备、接口等监控数据,帮助运维人员进一步判断问题触发点。
四、真相四:你看到的可能是“症状”,而不是“根因”
网络异常往往不是单点问题。比如,用户反映“系统访问很慢”,表面上可能看到服务器 CPU 升高、接口流量增加、应用响应时间变长,但真正的原因可能是链路拥塞、接口丢包,或者上游设备发生异常。
如果监控系统只负责“看到异常”,却不能把相关数据放在一起分析,运维人员就需要逐条查看告警,再登录不同设备寻找线索。误报和漏报之外,最大的成本其实是排障时间。
这也是为什么根本原因分析(RCA)越来越重要。OpManager 的 RCA 支持在集中窗口中可视化多个实体的监控数据,并基于告警、设备和接口等对象建立 RCA 配置,用于进一步分析网络问题的触发点。
五、怎么把“误报治理”真正落地?
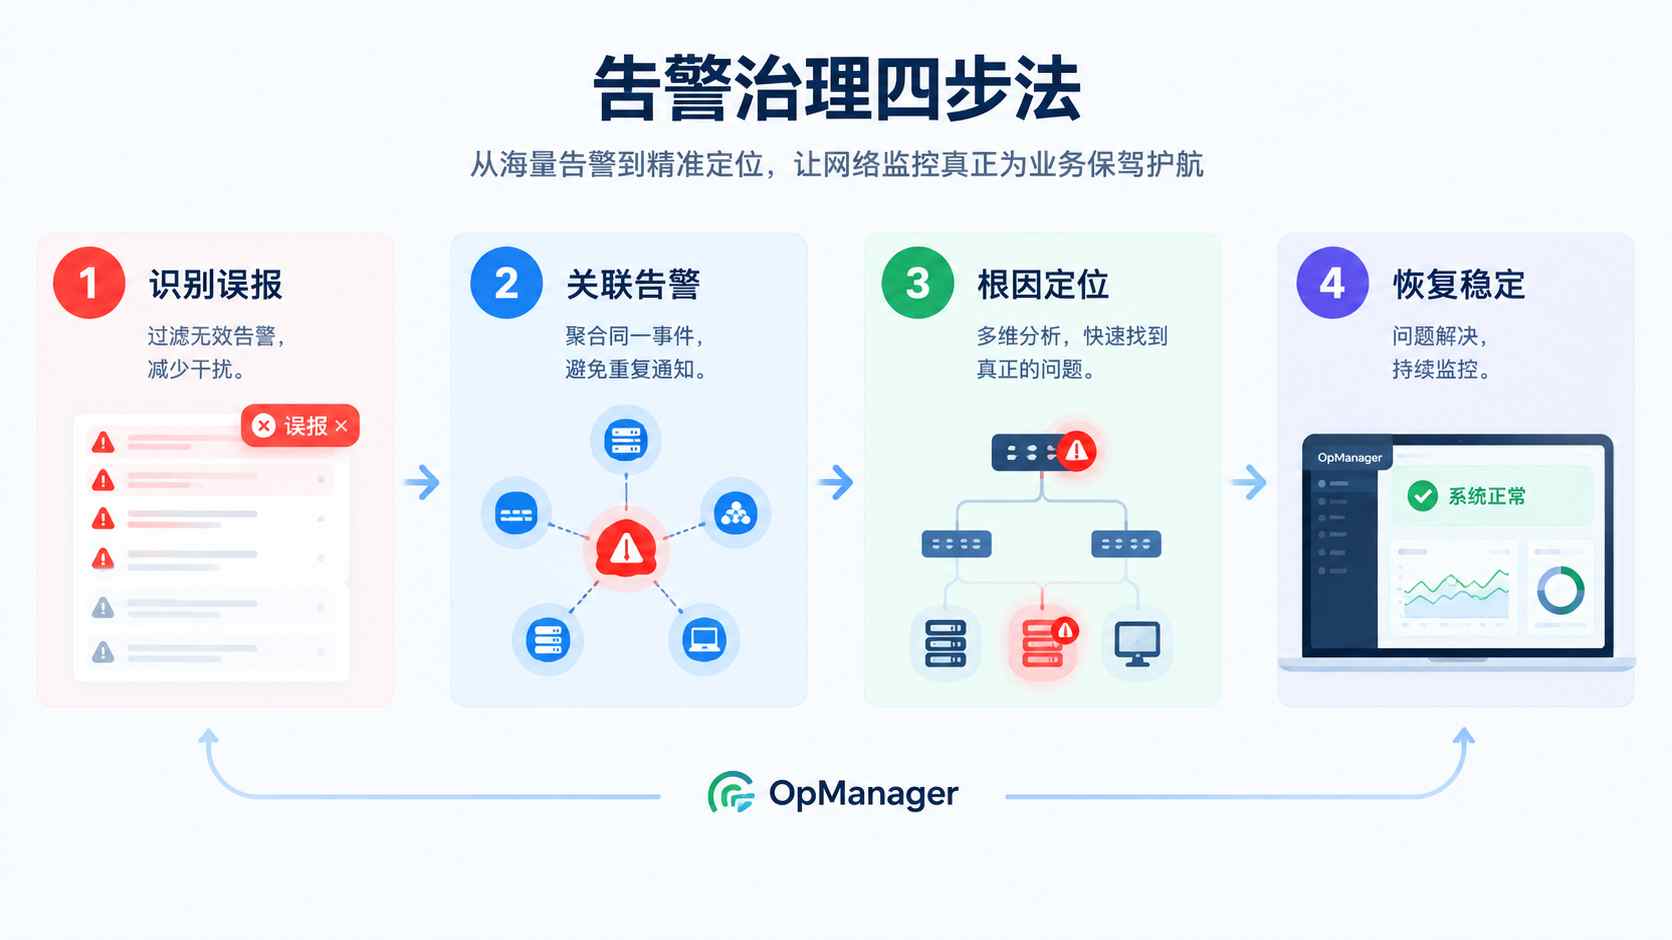
可以用下面这套四步方法做一次排查:
第一步,重新梳理阈值。把固定阈值与实际业务基线对照,区分正常波动和真正异常。
第二步,清理低价值告警。不是所有采集到的监控指标都需要实时通知,优先保留影响可用性、性能和业务连续性的事件。
第三步,建立告警关联。结合网络拓扑和上下游依赖关系,把同一故障引发的连锁告警聚合起来,避免重复通知。
第四步,从“看告警”转向“找根因”。对异常设备、接口和关键指标进行统一分析,判断真正的故障触发点,并记录处理结果,形成后续治理依据。
如果你的网络监控系统每天都在产生大量告警,不妨先不要急着提高所有阈值。先回答三个问题:哪些告警真正影响业务?哪些告警只是同一故障的连锁反应?哪些异常可以通过基线和根因分析提前识别?
对于希望减少告警噪音、提升故障定位效率的企业,可以将 OpManager 纳入 PoC,用真实设备和真实告警验证阈值、告警关联、网络拓扑和根本原因分析等能力,再根据实际运维人力和业务需求评估是否适合长期使用。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQ)
- Q:网络监控误报为什么调高阈值也解决不了?
A:调高阈值只能暂时压住告警量,代价是把真正的异常一起挡在门外。误报的根源通常是固定阈值不懂业务波动、监控项过多放大噪音、一个故障被拆成多条独立告警。正确做法是让阈值贴近真实业务基线,并叠加告警关联与根因分析,而不是一刀切地抬高门槛。
- Q:怎么判断哪些告警值得保留、哪些应该直接清理?
A:建议按业务影响分层评估:第一层关注可用性和核心链路,第二层关注性能异常,第三层用于趋势分析和容量规划。只有真正影响业务、并且达到持续异常条件的事件,才进入高优先级告警。这样一来,短时间的资源波动就不会再占用运维人员的注意力。
- Q:一个故障产生几十条告警,该怎么收敛?
A:需要告警关联和拓扑感知两件事配合:先根据网络拓扑判断设备之间的上下游依赖关系,再把同一故障引发的连锁告警聚合为一个事件,最后区分根因和受影响对象。经过关联处理后,运维人员看到的不是几十条并行告警,而是一条根因加一份影响范围。
- Q:根本原因分析(RCA)对日常排障到底有什么价值?
A:没有 RCA 时,运维人员看到的是“症状”——CPU 升高、流量增加、响应变慢,需要逐条查看告警并登录不同设备找线索,最大的成本是排障时间。RCA 的价值在于把相关实体的监控数据放到同一个视图里分析,帮助快速定位真正的故障触发点,从而缩短从告警到确定影响设备的时间。
- Q:误报治理应该从哪里开始落地?
A:建议按四步走:重新梳理阈值,把固定阈值与业务基线对照;清理低价值告警,只保留影响可用性、性能和业务连续性的事件;建立告警关联,聚合同一故障的连锁告警;从“看告警”转向“找根因”,统一分析异常设备、接口和关键指标,并记录处理结果形成后续依据。

