
网络管理智能运维(AIOps)落地实践:OpManager如何用机器学习实现异常检测与根因推荐?

AI 摘要
企业运维常被海量告警噪音困扰,本文解析OpManager基于Zia‑AI的智能运维落地实践,讲解自适应动态基线、告警事件关联、RCA根因分析技术原理,介绍信创国产化适配能力,对比传统静态阈值缺陷,说明如何把告警风暴转化为可执行运维洞察,缩短故障MTTR。
当前企业IT运维团队面临的核心矛盾并非“看不到问题”,而是“看到太多问题”。一台核心交换机抖动可能触发数百条关联告警,工程师在排查前需要先花大量时间分辨哪些告警是根因、哪些只是连锁反应。据行业观察,多数企业IT团队每天处理的告警中有相当比例属于重复或可抑制类别。ManageEngine OpManager正是为解决这一问题而设计的网络管理平台。
本文将围绕智能运维的异常检测与根因分析能力,从技术机制到落地实践展开剖析,帮助运维团队理解如何将告警噪音转化为可操作的运维洞察。
关键要点(Key Takeaways)
智能运维的核心突破口在于“降噪”而非“多告警”。传统阈值监控在动态网络环境中产生大量误报,基于机器学习的动态基线才是有效路径。
平台的自适应阈值通过Zia AI引擎为每个性能指标自动计算并每小时更新基线,无需人工逐台配置。
根本原因分析模块关联设备状态、拓扑关系与历史事件,可将故障定位时间从小时级压缩至分钟级。
在国产化适配方面,平台已完成与鲲鹏、麒麟、统信UOS及人大金仓数据库的深度兼容,满足信创环境部署需求。
智能运维的终极价值不是替代运维人员,而是将工程师从告警海洋中解放出来,聚焦真正影响业务的故障。

一、告警泛滥时代:网络管理为什么需要智能运维?
当前企业网络管理面临的核心困境在于,传统静态阈值无法适应动态网络环境。管理员凭经验设定CPU超过80%告警、内存超过90%告警,但网络流量的周期性波动、业务高峰期的合理资源拉升,都会让这些固定阈值频繁触发。其结果是运维团队每天被大量低价值告警淹没,真正影响业务的故障反而被淹没在噪音中。
1.1 静态阈值的结构性缺陷
静态阈值的根本问题在于它假设网络行为是恒定的。但实际环境中,一台数据库服务器在凌晨3点的CPU利用率通常为10%,白天业务高峰可能达到60%。如果统一设定80%阈值,凌晨的异常跃升不会触发告警,白天的正常波动却可能触发误报。这种“一刀切”的监控逻辑,是网络管理效率低下的重要原因。
1.2 智能运维的破局思路
智能运维(AIOps)的破局思路,是用机器学习识别每个指标的“正常状态”,而非依赖人工设定固定边界。平台通过持续学习历史监控数据,为每个性能指标建立动态基线。当实际值显著偏离基线时,系统才判定为异常。这种模式将网络管理从“阈值触发”推向“模式识别”,从根源上减少误报和漏报。
二、智能运维的技术底座:从静态阈值到自适应基线
自适应基线是智能运维能力落地的技术底座。它要求系统具备持续学习、实时计算和上下文关联三项能力,缺一不可。
2.1 Zia AI引擎如何学习网络的“正常状态”
平台内置的Zia AI引擎是自适应阈值功能的核心驱动。该引擎在设备接入后会对历史监控数据进行为期14天的训练,通过机器学习算法为每个性能指标计算独立基线。这一基线并非一次性设定,而是每小时重新计算一次,确保能够跟随网络环境的周期性波动实时调整。
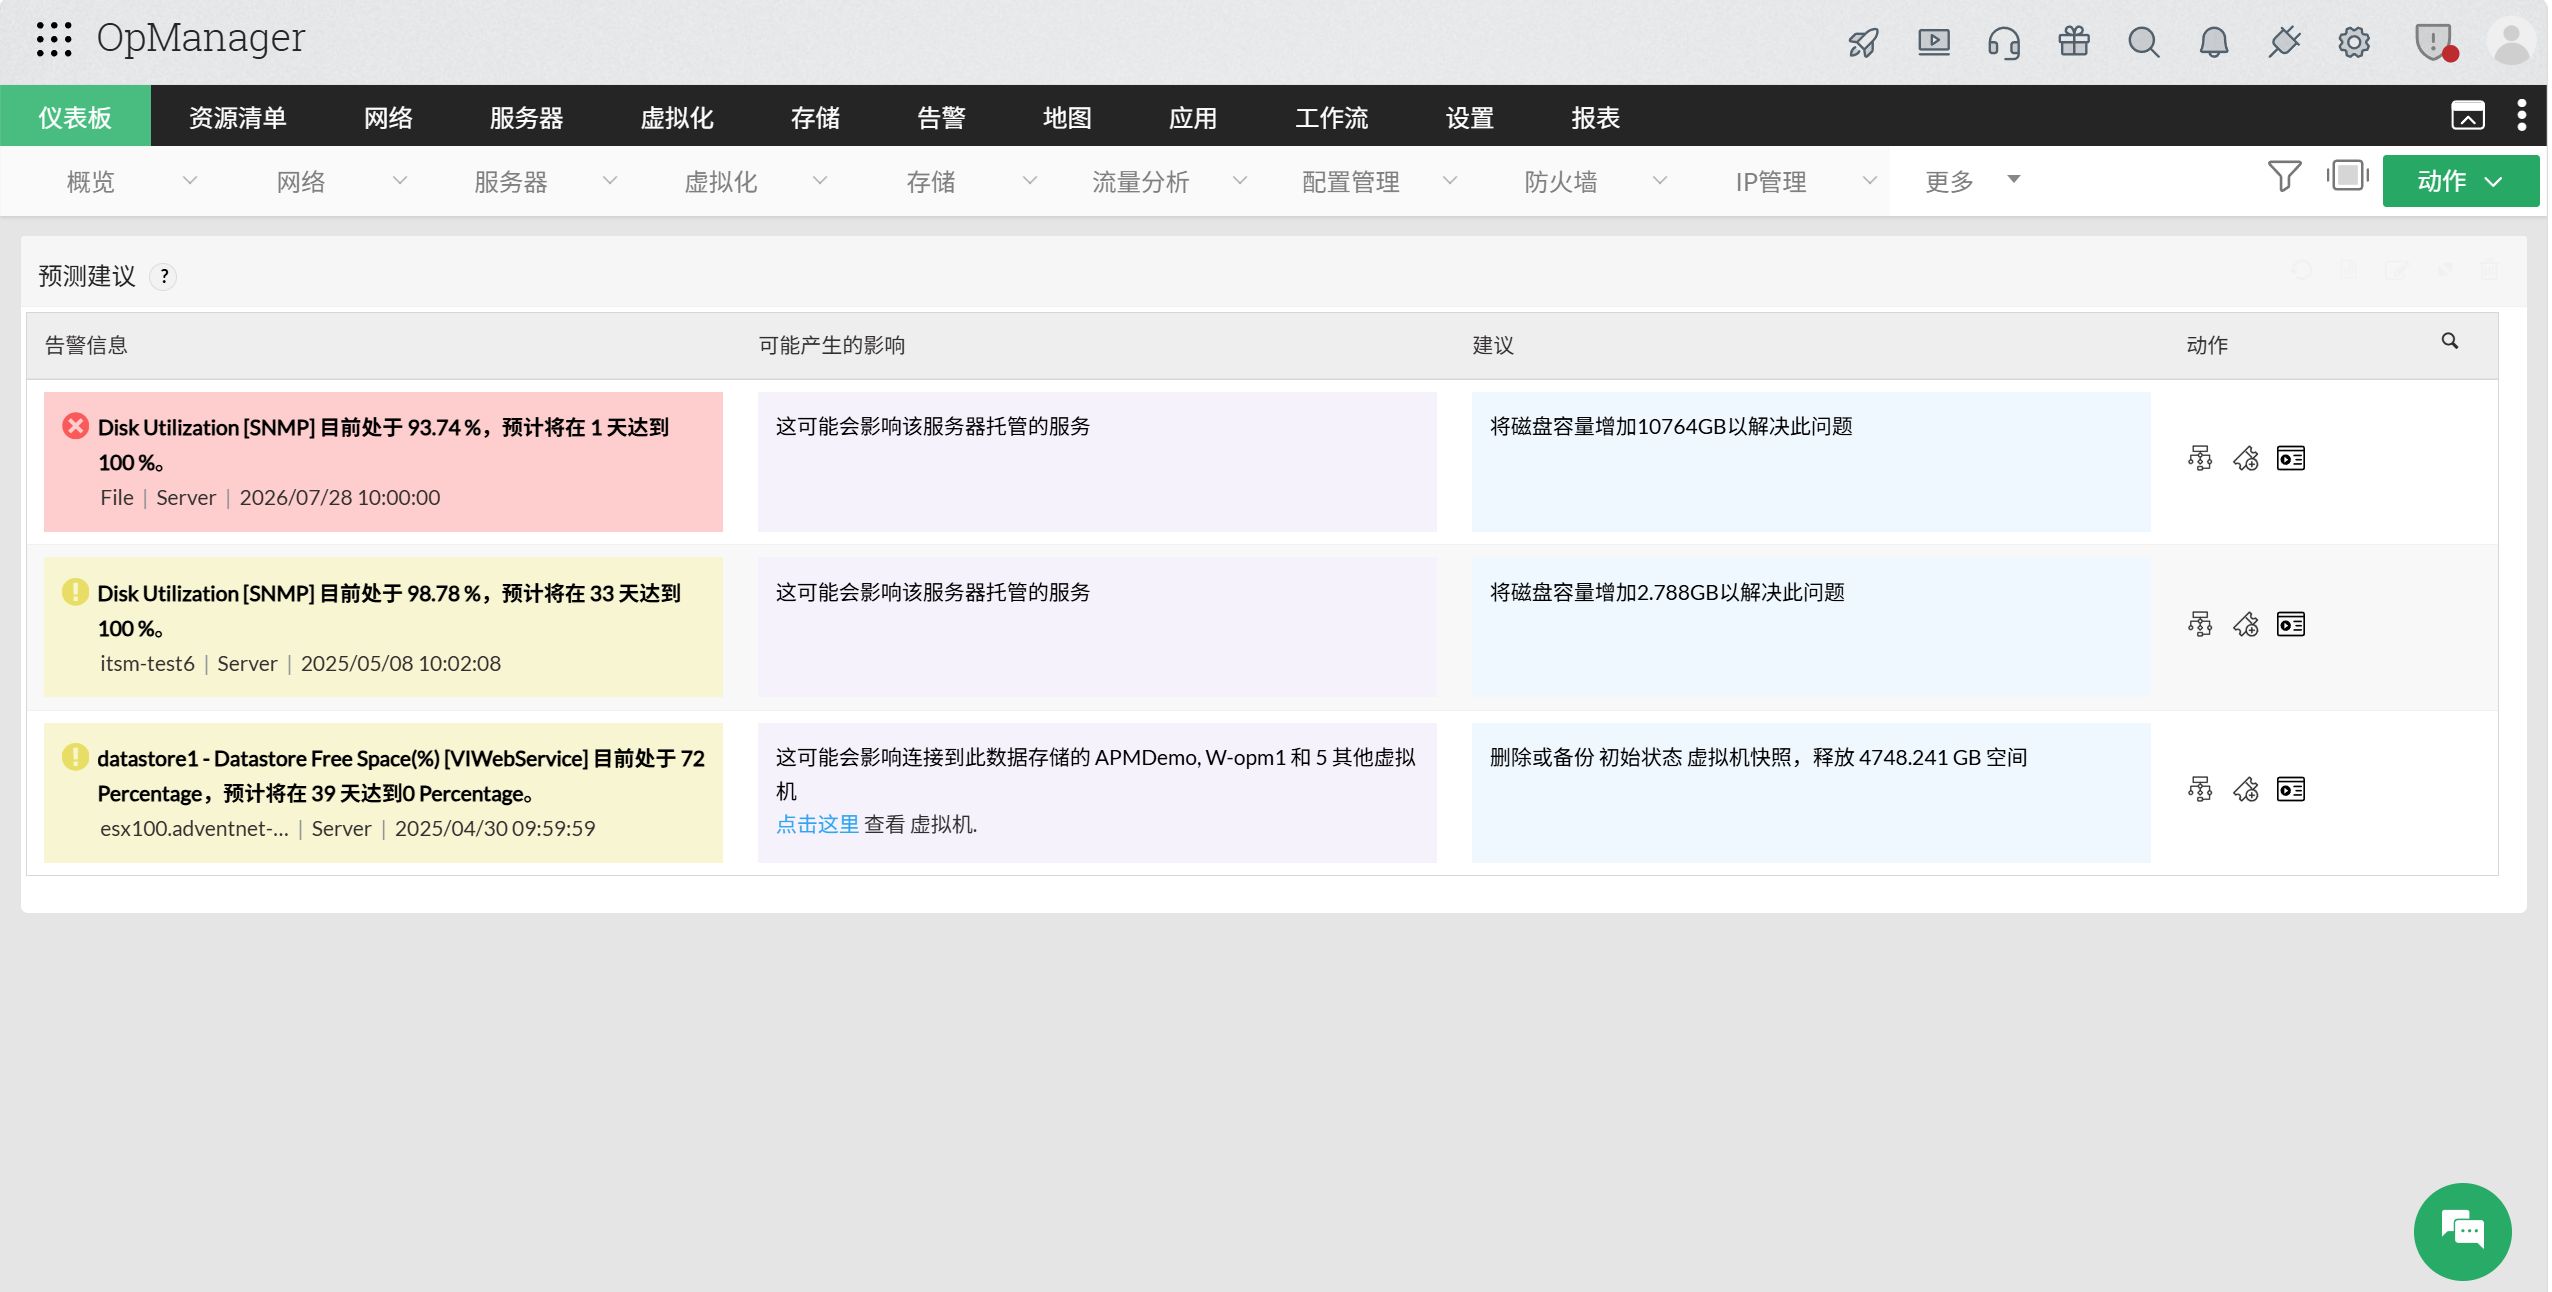
举例来说,一台数据库服务器在凌晨3点的CPU利用率通常为10%。在传统静态阈值体系下,25%的利用率不会触发任何告警。但Zia AI将10%识别为该时段的正常基线后,25%的跃升即被判定为显著偏离,系统会立即生成告警——即便25%在工作时间属于完全正常的水平。这种基于时间上下文的异常识别能力,是网络管理从粗放式监控走向精细化智能运维的关键分水岭。
2.2 告警降噪的工程化实现
平台的智能事件关联功能进一步对告警进行二次治理。当网络中出现连锁故障时,系统基于设备依赖关系和拓扑结构对告警进行聚类,将数百条原始告警压缩为少量高价值事件。在实际对比测试中,告警聚合率可达80%以上,即100条原始告警可聚合约20条事件。
这一能力的工程意义在于:运维工程师不再需要逐条判断告警的优先级。系统在聚合过程中同时标注故障影响范围、关联设备清单和推测的根因方向,使运维人员的注意力可以直接锚定在处理动作上,而非信息筛选上。
三、根本原因分析:智能运维的“最后一公里”
告警降噪解决了“看什么”的问题,根本原因分析则解决“从哪下手”的问题。两者结合,才构成完整的智能运维闭环。
3.1 RCA模块的三层技术架构
平台的根本原因分析模块采用分层架构实现故障定位。数据采集层通过SNMP、NetFlow/sFlow、Syslog等协议实时采集设备性能、流量和日志数据。关联分析层构建设备‑链路‑应用的依赖模型,当故障发生时逐层排查可能的因果链路。算法引擎层则采用贝叶斯网络等算法计算各因素与故障的关联概率。
这一架构的实际效果是:当某台服务器无法访问时,系统会依次检查其直连交换机端口状态、上游路由器路由表、防火墙安全策略,并关联同VLAN内其他设备的异常情况,而非要求工程师手动逐跳排查。
3.2 从MTTR数据看RCA的实际价值
智能运维的价值最终要落到MTTR(平均修复时间)的改善上。传统网络故障排查依赖人工逐台设备检查日志和测试链路,MTTR通常以小时计。平台的RCA模块通过自动化关联分析,可将故障定位时间压缩至分钟级别。
某金融机构的实际案例中,数据中心因存储阵列故障导致业务中断。传统排查方式需要依次检查存储控制器、光纤链路和主机HBA卡等多个环节,预计耗时超过2小时。平台在3分钟内完成了根因锁定并自动生成包含盘位编号和更换步骤的修复方案。这一效率提升对于核心业务系统的可用性保障具有直接价值。
四、智能运维的差异化能力
在具备异常检测和根因分析能力之后,智能运维平台还需要解决两个落地问题:如何让运维人员快速理解AI的判断依据,以及如何在国产化环境中稳定运行。
4.1 从监控工具到运维知识沉淀
平台的Zia AI不仅执行异常检测,还通过对话式界面提供运维洞察。管理员可以用自然语言查询特定设备的性能趋势、告警历史或资源耗尽预测。系统会生成包含影响分析和可执行建议的摘要,将监控数据转化为可操作的运维决策。
此外,OpManager Nexus支持与DeepSeek、OpenAI等大语言模型集成,管理员可以通过AI对话生成自定义监控脚本或自动化诊断流程,进一步降低智能运维能力的使用门槛。
4.2 国产化环境下的智能运维适配
对于国内企业而言,智能运维平台的国产化适配能力是选型时的重要考量。平台已完成与华为鲲鹏、麒麟操作系统、统信UOS的深度兼容,并于12.8.658版本起正式支持人大金仓Kingbase数据库。这一适配使平台能够在“国产硬件+国产系统+国产数据库”的完整信创环境中部署运行,对于政府、金融等对自主可控有明确要求的行业具有实际意义。
五、总结
网络管理智能运维的落地并不依赖某一项“颠覆性技术”,而是通过机器学习对监控数据的持续学习与模式识别,将运维团队从告警噪音中解放出来。平台在这一领域的核心价值体现在三个层面:Zia AI驱动的自适应阈值实现零配置的基线管理,智能事件关联将告警风暴压缩为可操作事件,RCA模块将故障定位从经验驱动升级为数据驱动。
对于正在评估智能运维方案的企业IT团队,建议从告警降噪效果和根因定位准确率两个维度进行实际测试,这两个指标直接决定运维效率的改善幅度。立即访问 ManageEngine 官网体验 OpManager智能监控,支持30天全功能免费试用。
扩展阅读
AIOps 2.0 白皮书——适用于当今 IT 堆栈的智能扩展 | OpManager Nexus
什么是智能运维?一文带你看懂AIOps的底层逻辑 - ManageEngine Article Blogs
2026年智能运维AIOps软件推荐:8款主流平台对比与选型指南 - ManageEngine Article Blogs
网络管理在多云环境下的挑战与对策:CIO的架构选型与运维团队的跨云排障实战 - ManageEngine Article Blogs
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- OpManager的智能运维功能是否需要额外付费?
答:OpManager的自适应阈值、智能事件关联和根本原因分析功能已内置于标准版中,无需额外购买独立模块。Zia AI引擎随平台部署自动启用,经过14天数据积累后开始提供动态基线服务。
- 自适应阈值功能是否适用于所有类型的网络设备?
答:OpManager支持对超过3000种性能指标启用自适应阈值,覆盖主流多厂商网络设备。管理员可以选择对全部设备批量启用,或仅针对特定设备类型和指标启用,配置粒度灵活可控。
- OpManager能否在国产化信创环境中完整运行?
答:可以。OpManager已完成与华为鲲鹏、飞腾服务器的兼容适配,支持麒麟OS、统信UOS操作系统,并自12.8.658版本起支持人大金仓数据库。形成了从硬件到数据库的完整国产化监控部署链路。
- 智能根因分析功能对网络拓扑的完整性有什么要求?
答:OpManager的RCA功能依赖设备‑链路‑应用的关联模型。平台通过自动网络发现功能构建拓扑关系,对主流网络设备的拓扑识别准确率较高。建议在启用RCA前完成一轮完整的网络发现扫描,确保依赖关系数据完整。
- OpManager与开源监控工具(如Zabbix)在智能运维能力上的主要差异是什么?
答:Zabbix提供强大的数据采集和告警框架,但自适应阈值和根因分析需要依赖用户自行编写脚本或集成第三方工具。OpManager将这些能力作为开箱即用的内置功能提供,Zia AI引擎自动完成基线学习和事件关联,降低了智能运维能力的部署门槛。

