告警刷屏却找不到根因?国内服务器监控该换一种打开方式了

AI 摘要
针对国内运维告警刷屏却难以定位根因的普遍痛点,剖析告警噪音、多工具视图割裂、固定阈值误报漏报三大成因。介绍OpManager全栈监控、拓扑告警关联、自适应阈值告警抑制、统一可视化视图等能力,面向中小企业、数据中心等场景给出落地价值,帮助运维从海量告警中收敛出有效排障线索,缩短故障响应时长。
随着企业服务器、网络设备、应用系统和数据库规模持续增长,IT 运维团队每天面对的数据量和告警量也在快速上升。很多团队并不缺少监控工具,却仍然难以从海量告警中快速识别真实故障。ManageEngine OpManager 提供覆盖服务器监控、网络、应用和数据库的全栈监控能力,并通过智能告警降噪与根因定位,帮助运维团队从被动接收告警转向主动、快速排障。
本文将从运维监控、告警降噪和根因定位三个维度,解析国内企业常见的运维挑战,并说明OpManager如何帮助IT团队建立更高效的监控与排障体系。
关键要点(Key Takeaways)
• 国内企业普遍面临告警多、定位慢、工具分散的问题,单纯增加采集指标并不能解决根因定位难题。
• 关键在于把告警关联起来:统一视图、拓扑关联与依赖分析,是把海量告警变为可行动排障线索的前提。
• ManageEngine OpManager提供从基础设施到应用层的全栈监控能力,并支持开箱即用部署。
• 通过自适应阈值、告警抑制与拓扑关联,平台可帮助减少无效告警,让重要问题更突出。
• 统一视图与根因定位能力有助于缩短故障响应时间,尤其适合 IT 人手有限的团队。

一、 为什么告警刷屏,却仍然找不到根因?
许多运维团队都会遇到类似情况:监控平台不断推送告警,但真正影响业务的故障却迟迟无法确认。问题通常不在于监控数量不足,而在于告警缺乏关联、视图分散、阈值设置僵化。下面从三个典型原因展开分析。
1. 告警噪音掩盖真实故障
同一故障常触发大量重复告警。例如核心交换机异常,可能导致后挂服务器连通性告警、数据库连接超时、应用响应变慢等下游症状接连出现。如果平台不能识别告警之间的关联,运维只能逐条排查,真正关键的根因反而被淹没。
2. 监控数据分散,缺少统一视图
不少企业同时使用多套工具查看主机、网络、应用和数据库,排障时要在多个系统间切换、人工对齐时间轴,难以快速判断故障影响范围和传播路径。国内企业设备类型多、架构复杂、国产化环境适配要求高,这种割裂感更明显。
3. 阈值僵化导致误报和漏报并存
固定阈值在业务波动场景中容易误报,例如高峰期CPU、内存阶段性上升被误判为故障;低峰期缓慢恶化的问题又可能被忽略。监控不能只判断“是否超标”,还要结合历史基线、依赖关系和业务场景综合判断。
二、国内服务器监控需要怎样的能力升级?
要解决告警刷屏和定位慢的问题,服务器监控平台需要从“采集数据”升级到“理解数据”。这意味着监控体系不仅要覆盖更多对象,还要能把数据关联起来,形成可行动的排障线索。具体而言,能力升级体现在三个方向。
从单点监控走向全栈关联。
真实故障通常发生在服务器、网络、应用和数据库之间的交互链路上。只有把上层应用告警自动关联到底层主机与链路指标,才能在一个视角内完成“症状—链路—根因”的推理。
从被动告警走向智能降噪。
有效告警管理不是单纯减少通知,而是让重要告警更突出、重复告警被合并、非关键告警被抑制。通过自适应阈值、告警抑制和依赖关系关联,把同一故障引发的几十条告警收敛为少数高优先级事件,并标注疑似根因。
从人工排查走向根因定位。
根因定位的关键是建立对象依赖关系。例如数据库异常时,依赖它的应用可能出现响应变慢、请求堆积。平台若能展示上下游依赖,运维就能更快判断上游根因,减少对资深工程师经验的依赖。
三、 OpManager如何实现告警降噪与根因定位?
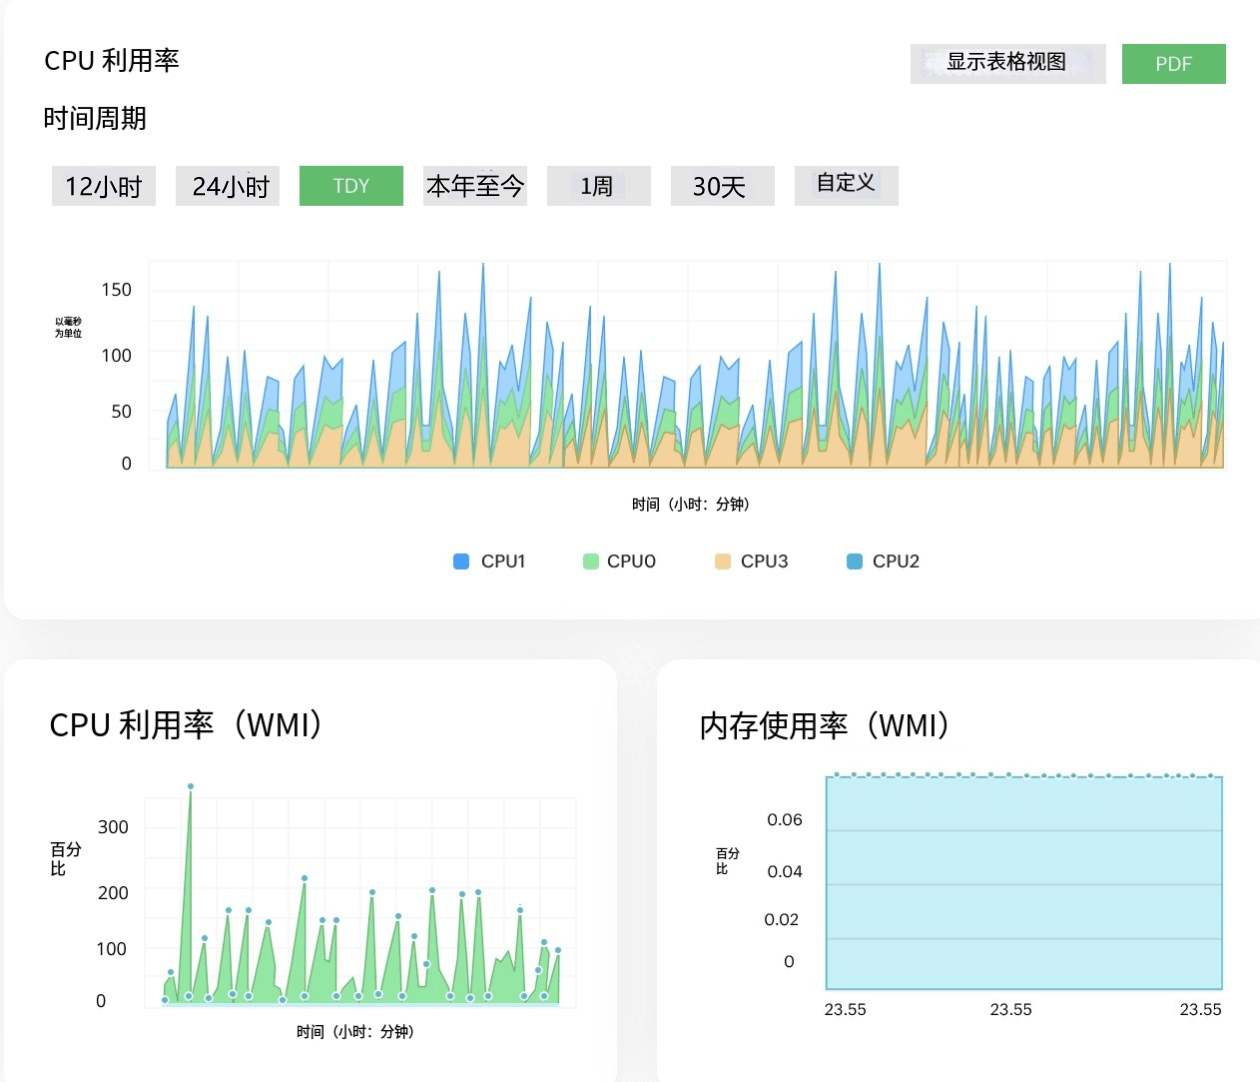
ManageEngine OpManager 将主机监控、网络监控、应用监控和数据库监控整合到统一平台中,帮助 IT 团队在一个视图中查看基础设施运行状态。对于需要兼顾功能覆盖、误报率与性价比的团队来说,这种一体化设计可以减少多工具切换带来的排障成本。其能力主要体现在以下几个方面。
1. 全栈监控统一采集
OpManager将主机、网络、应用和数据库监控整合到统一平台,可采集服务器运行状态、主机可用性、硬件健康度、系统性能指标和网络设备状态,并通过统一仪表板呈现。统一采集不仅减少工具数量,也为后续告警关联和根因分析提供共同数据基础。
2. 基于拓扑的告警关联与依赖分析
平台通过拓扑视图展示设备、链路和服务之间的依赖关系。多个告警同时出现时,运维可结合拓扑判断哪些是根因、哪些是连带影响,从而确定处置优先级,避免在下游症状上反复打转。
3. 自适应阈值与告警抑制
OpManager 支持基于历史数据设置更合理的阈值,并对重复告警、抖动告警进行抑制,降低误报率,避免关键问题被淹没。结合告警分级和升级策略,高风险问题可第一时间触达责任人,低风险事件进入待观察队列。
4. 统一仪表板与可视化视图
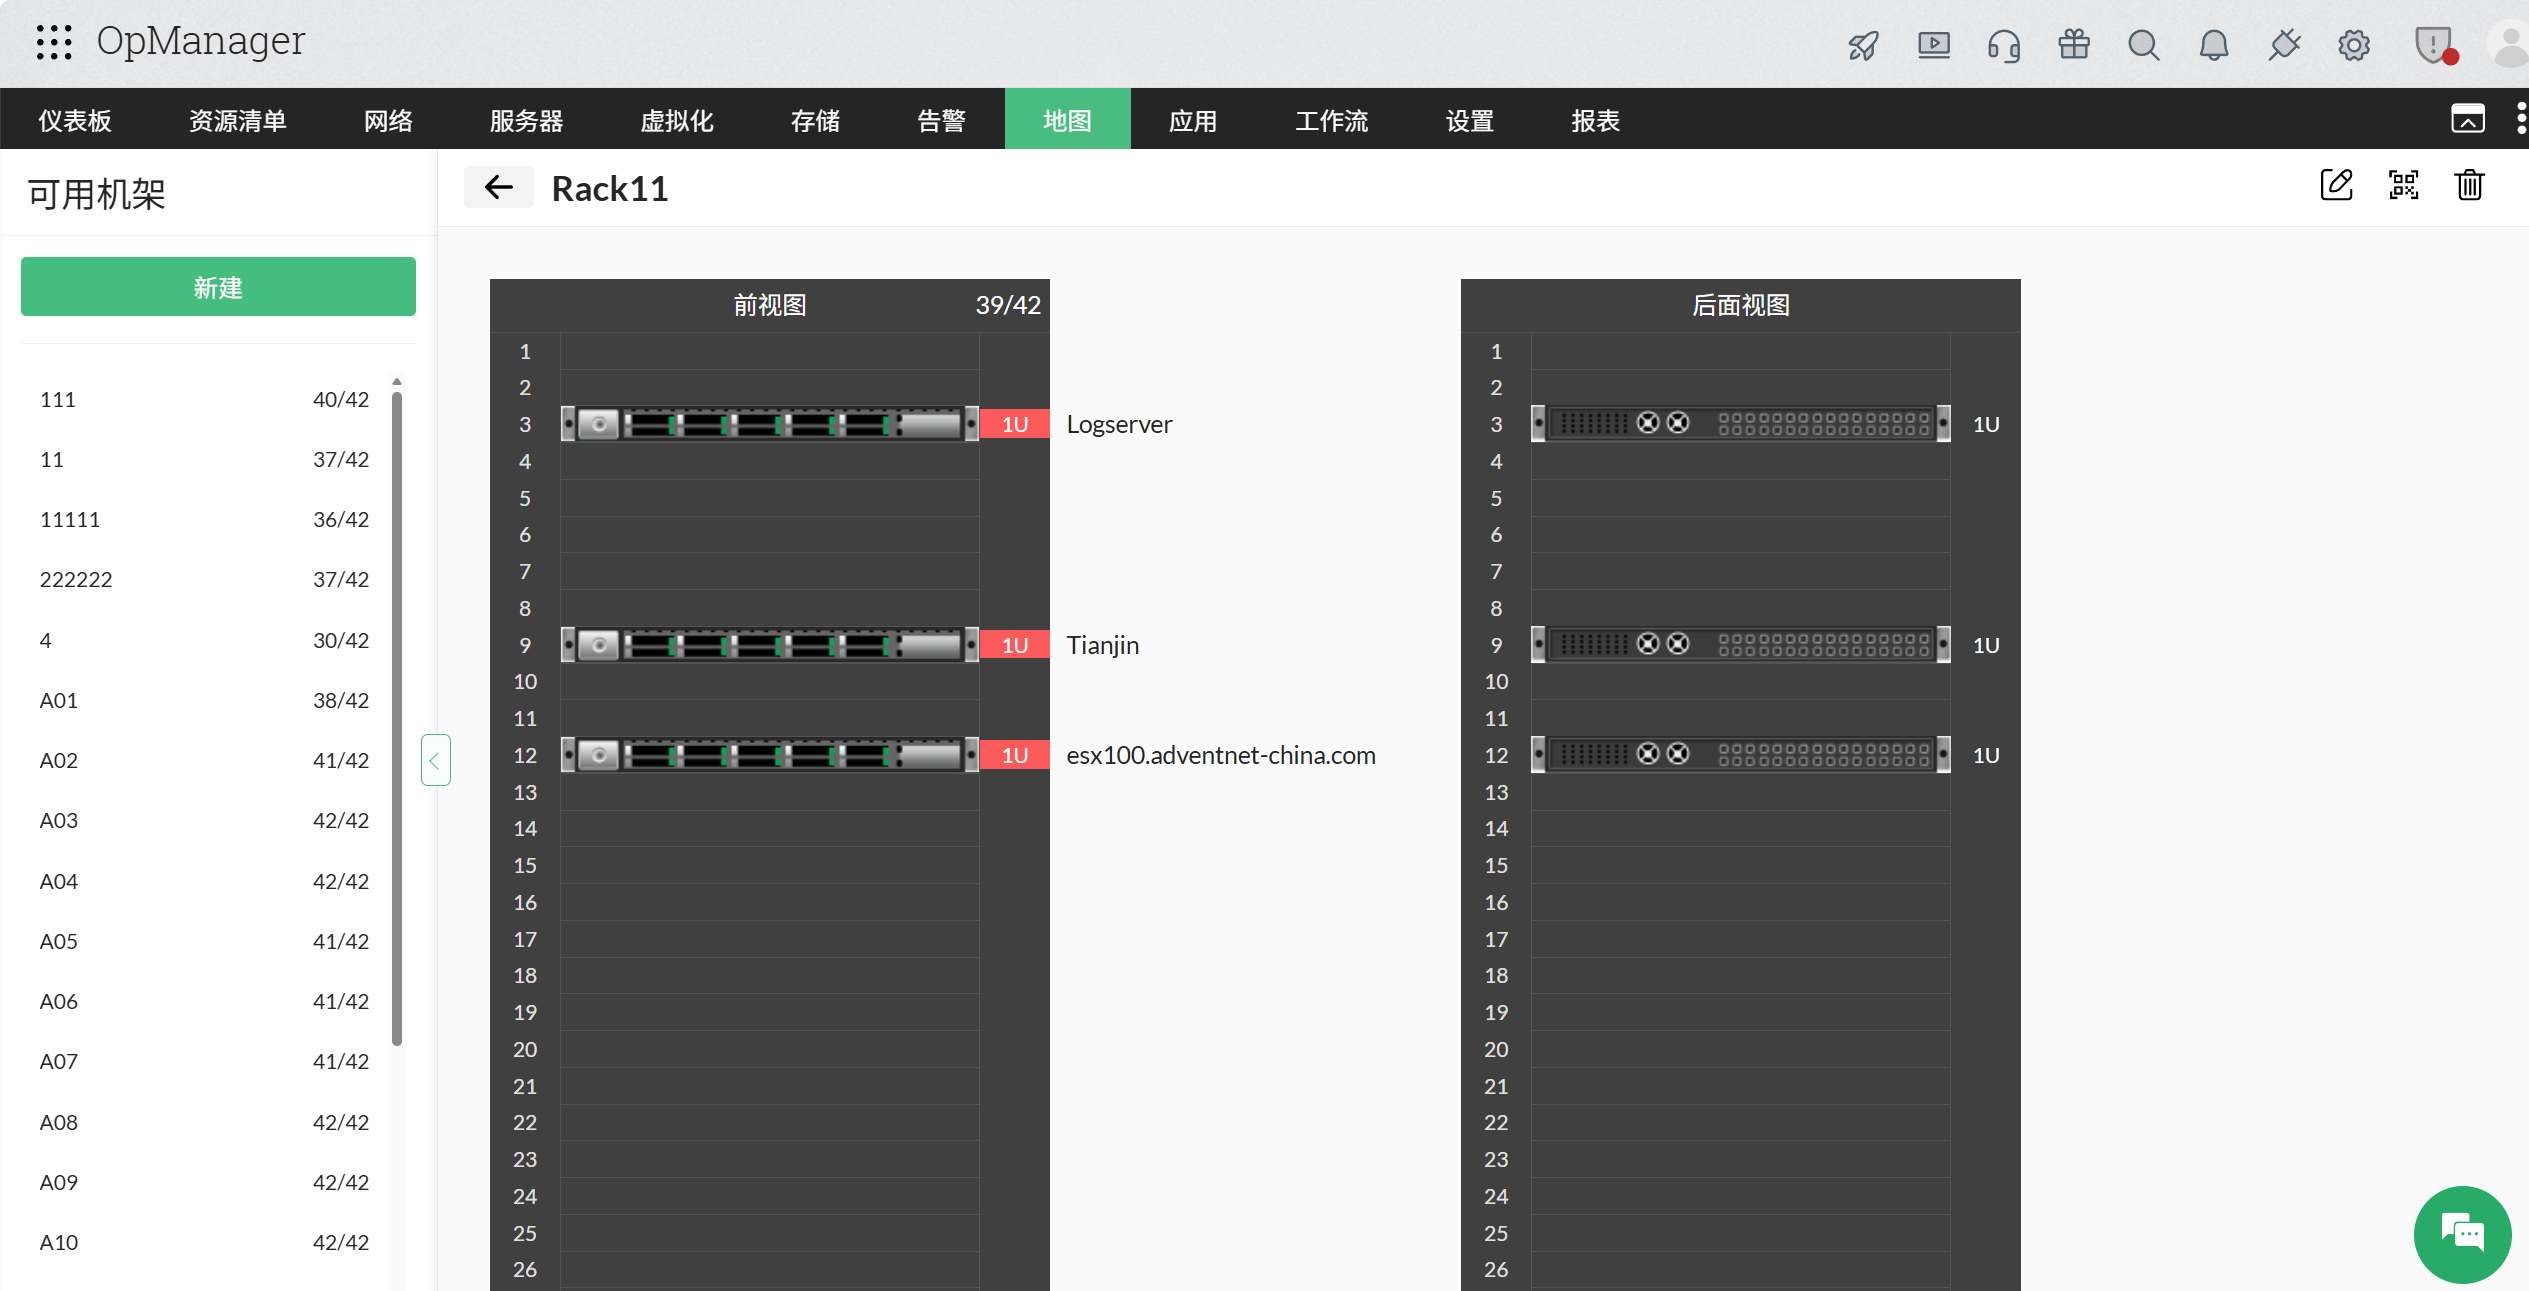
借助统一可观测性仪表板、拓扑视图和性能趋势图,团队可以更直观地观察故障位置、影响范围和变化趋势,必要时结合 3D 机架视图定位具体设备和机柜,缩短从发现异常到确认根因的时间。
5. 面向国内环境的适配与落地
国内企业常见物理机、虚拟化、容器、国产操作系统与数据库混合部署,对兼容性和部署灵活性要求较高。OpManager 支持开箱即用部署,可在较短时间内完成设备发现与纳管,适合缺少专职监控开发人员的团队低门槛起步、按需扩展。
四、哪些场景最需要这种监控方式?
中小企业 IT 基础设施快速扩张。
服务器、网络和应用数量快速增长时,人工巡检和分散工具难以及时发现问题。OpManager可帮助中小企业在有限预算和人力下快速建立统一监控能力。
数据中心运维团队人手有限。
设备多、链路复杂、7×24 小时值守压力大。通过告警降噪和根因定位,团队可减少重复排查,把精力集中在真正影响业务的故障上。
多系统、多设备混合环境排障。
服务器、网络设备、虚拟化、数据库和业务应用混合运行时,单一工具容易留下盲区。全栈监控和依赖分析可降低跨系统、跨厂商环境下的排障难度。
五、总结
国内服务器监控的难点,已经从“能否采集数据”转向“能否从数据中快速定位问题”。ManageEngine OpManager 通过全栈监控、智能告警降噪和根因定位,帮助 IT 团队减少告警噪音、统一监控视图、缩短故障响应时间。相比分散、割裂的传统监控方式,它以开箱即用的部署方式、覆盖基础设施到应用层的统一视图,以及基于拓扑关联的告警收敛能力,为正在评估监控平台或希望优化现有体系的企业,提供了较为完整的一体化方案。
如果你希望进一步了解 OpManager 在运维监控、告警降噪和根因定位方面的能力,可以访问ManageEngine官网。
扩展阅读
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 服务器监控告警太多怎么办?
答:应通过告警降噪、阈值优化和告警关联减少无效通知。OpManager 支持基于拓扑和依赖关系合并相关告警,并抑制重复与抖动告警,帮助运维团队聚焦真实故障。
- 如何通过服务器监控快速定位故障根因?
答:需要把主机、网络、应用和数据库状态放在同一视图中关联分析。OpManager 提供统一仪表板和拓扑视图,可辅助判断故障影响范围与可能根因。
- 告警降噪会不会漏掉真正的问题?
答:合理的降噪只合并重复与连带告警,并不删除异常信息。OpManager 会保留事件明细并按严重级别分级通知,关键问题仍可第一时间触达责任人。
- OpManager适合中小企业使用吗?
答:适合。OpManager 支持开箱即用部署,覆盖主机、网络、应用和数据库监控,适合 IT 人手有限但需要统一监控能力的中小企业和数据中心团队。
- 多套监控工具并存时如何整合?
答:可将 OpManager 作为统一监控入口,纳管主机、网络与应用指标,把分散数据汇聚到同一视图,逐步收敛多工具切换带来的排障成本与数据盲区。

