
SRE四大黄金信号是什么?Google运维方法的落地路径

AI 摘要
本文介绍 SRE 四大黄金信号——延迟、流量、错误和饱和度,并从核心业务、分层监控、调用链和业务影响四个方面说明企业落地路径,结合 Applications Manager 的应用、数据库与基础设施监控能力,形成从发现异常到定位根因的统一监控思路。
ManageEngine Applications Manager 是面向企业应用、数据库和基础设施的监控平台。在实际运维中,系统出现响应变慢、请求激增、错误频发等问题时,如何快速判断故障影响并定位问题?Google SRE(Site Reliability Engineering,站点可靠性工程)提出的“四大黄金信号”,提供了一套清晰的分析框架:延迟、流量、错误和饱和度。对于正在建设 apm、可观测性和应用性能管理体系的企业,这四项指标可以作为建立监控体系的重要基础。

一、SRE四大黄金信号是什么?
SRE四大黄金信号分别是:
| 黄金信号 | 核心问题 | 常见指标 |
|---|---|---|
| 延迟 Latency | 请求处理得快不快? | 响应时间、P95、P99 |
| 流量 Traffic | 系统承受了多少请求? | QPS、TPS、并发量 |
| 错误 Errors | 有多少请求没有正常完成? | 5xx、超时、异常、失败率 |
| 饱和度 Saturation | 系统是否接近资源上限? | CPU、内存、线程池、连接池 |
四个信号并不是独立存在的。
例如,大促期间访问量突然增加,可能导致应用线程池排队、数据库连接池紧张,最终表现为接口延迟升高和错误率增加。通过同时观察四个信号,运维团队可以更快判断问题究竟来自流量变化、资源瓶颈,还是应用本身。
二、四大黄金信号分别应该监控什么?
1. 延迟:判断应用响应是否变慢
延迟是用户最容易感知的性能问题。
进行 应用性能监控 时,不应只观察平均响应时间,还应关注 P95、P99 等百分位指标。平均值可能掩盖少量慢请求,而尾部延迟往往意味着部分用户已经遇到明显的访问卡顿。
实际监控中,可以关注:
- 接口响应时间
- 关键事务耗时
- 服务调用耗时
- 数据库查询耗时
2. 流量:判断系统当前负载
流量反映系统正在处理多少工作量。
对于网站和 API,可以关注 QPS、TPS、吞吐量和并发量。出现性能问题时,除了判断“为什么变慢”,还要确认:
是不是请求突然增加了?
如果流量与延迟同时上涨,可能需要进一步检查系统容量;如果流量保持稳定而延迟突然升高,则应重点排查应用、数据库或外部依赖。
这也是 应用监控 中非常重要的一层:将性能变化与请求负载结合起来分析。
3. 错误:不只是HTTP 500
错误监控不能只统计 HTTP 500。
请求超时、服务调用失败、数据库连接异常、应用异常,以及关键业务操作失败,都可能意味着服务已经出现问题。
例如,订单接口返回 HTTP 200,但订单没有成功创建,从业务角度看依然属于一次失败。因此,错误指标最好同时覆盖系统错误、应用异常和业务失败。
4. 饱和度:提前发现资源瓶颈
饱和度关注的是系统距离资源上限还有多远。
除了 CPU、内存、磁盘 I/O,还需要关注 JVM、线程池、数据库连接池和消息队列等应用级资源。
例如,CPU 使用率只有 40%,并不代表系统一定正常。如果数据库连接池已经达到上限,请求仍然可能大量等待。因此,资源使用率需要结合延迟、流量和错误进行综合分析。
三、企业如何落地四大黄金信号?
第一步:从核心业务开始
不需要一开始就监控所有系统。
可以优先选择登录、订单、支付、核心 API 等关键业务,先建立核心服务的性能基线,再逐步扩展到其他应用。
第二步:建立分层监控体系
可以按照“服务—应用—数据库—基础设施”进行建设:
| 层级 | 重点监控内容 |
|---|---|
| 服务层 | 请求量、响应时间、错误率 |
| 应用层 | JVM、线程池、异常、事务 |
| 数据库层 | 查询耗时、连接数、慢查询 |
| 基础设施层 | CPU、内存、磁盘、网络 |
其中,数据库监控 是应用性能排查的重要组成部分。很多接口变慢问题,最终并不是应用代码本身,而是慢 SQL、数据库连接不足或数据库资源竞争造成的。
第三步:结合调用链定位根因
四大黄金信号可以帮助发现“哪里异常”,但还需要进一步回答“为什么异常”。
例如:
接口变慢 → 应用服务耗时增加 → 数据库调用变慢 → SQL执行时间增加
这时就需要把应用性能数据、调用链和数据库数据关联起来。
站内已有的《什么是APM:理解应用性能管理的基础知识》《分布式追踪实战指南》《数据库监控体系搭建实战:从指标采集到慢查询排查的完整路径》,可以作为这一监控思路的延伸阅读。
第四步:让告警围绕业务影响
监控指标并不是越多越好。
例如单独设置“CPU超过80%”告警,可能产生大量低价值告警。更合理的方式,是结合延迟、错误率和资源指标判断是否真正影响业务。
这样才能让监控从“发现数据异常”,进一步变成“发现需要处理的问题”。
四、Applications Manager如何辅助四大黄金信号?
ManageEngine Applications Manager 可以将应用、数据库和基础设施的监控数据集中起来,为企业建立统一的 应用性能监控 体系。
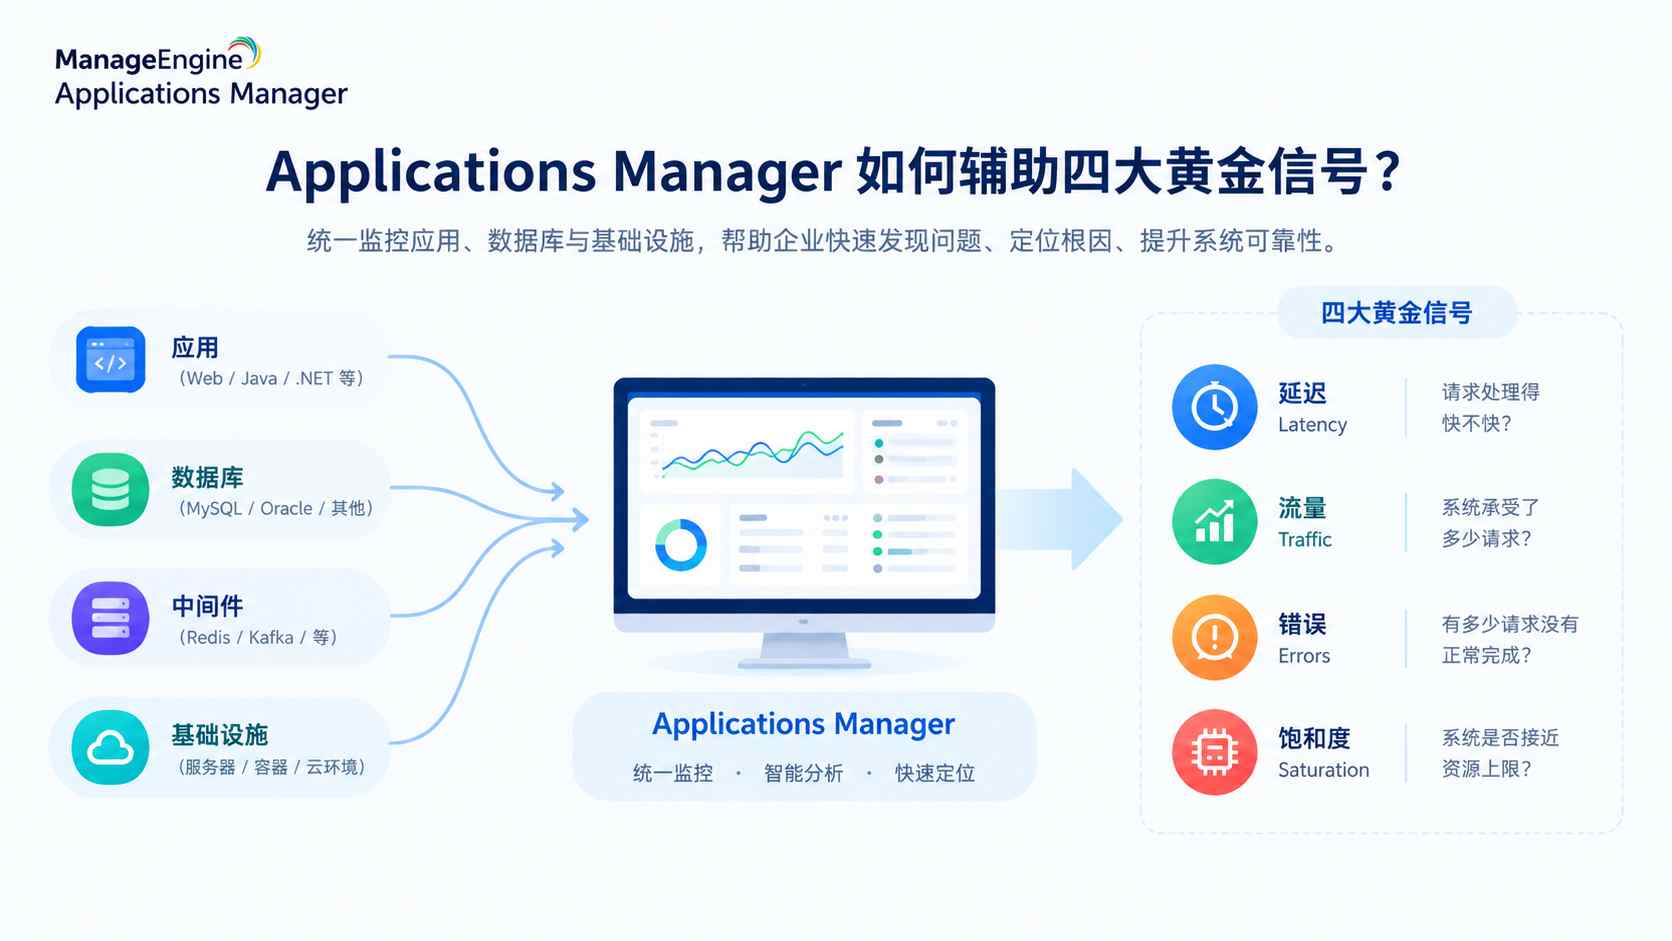
在实际场景中,可以将四大黄金信号与不同监控对象对应起来:
| 黄金信号 | 重点关注 |
|---|---|
| 延迟 | 应用响应时间、事务耗时、SQL执行时间 |
| 流量 | 请求量、吞吐量、并发情况 |
| 错误 | 异常、超时、失败事务 |
| 饱和度 | JVM、CPU、内存、连接池及数据库资源 |
当接口出现性能下降时,可以先通过应用监控判断异常服务,再结合调用链分析上下游依赖,最后通过数据库监控进一步排查 SQL 和数据库资源问题。
这样就形成了从用户请求 → 应用服务 → 数据库 → 基础资源的完整定位路径。
五、四大黄金信号的核心价值
SRE四大黄金信号并不是简单增加四个监控指标,而是提供了一套统一的问题分析方法:
流量看负载,延迟看体验,错误看影响,饱和度看容量。
当这四类指标与 apm、应用监控、数据库监控 和 应用性能监控 结合起来,运维团队就可以形成:
发现异常 → 判断影响 → 定位根因 → 快速处理 → 持续优化
对于正在推进 DevOps、SRE 和可观测性建设的企业,四大黄金信号可以作为建立应用可靠性监控体系的重要起点。
想进一步了解企业应用、数据库及基础设施的统一监控能力,可查看 ManageEngine Applications Manager。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQ)
- SRE四大黄金信号是什么?
答:延迟、流量、错误和饱和度。
- 为什么不能只监控CPU和内存?
答:CPU 和内存只能反映部分资源状态,无法完整体现应用响应、请求负载和错误情况。
- 为什么应用监控要关注P95和P99?
答:百分位延迟可以帮助发现尾部慢请求,避免平均响应时间掩盖部分用户遇到的性能问题。
- 错误监控只需要统计HTTP 500吗?
答:不是,还应该关注超时、应用异常、依赖服务失败以及关键业务失败。
- 数据库监控为什么与应用性能监控有关?
答:数据库是很多应用性能问题的重要影响因素。慢 SQL、连接池不足和数据库资源竞争,都可能进一步导致应用响应时间升高。
