
服务器挂了比交换机挂了更致命:监控覆盖的优先级排法

AI 摘要
很多企业监控习惯优先盯交换机路由器,却忽视服务器故障更容易直接造成业务中断。本文提出监控覆盖四级排法,以业务影响、依赖程度、故障传播范围作为判断依据,区分核心服务器、核心网络设备、链路边缘设备、普通终端四层优先级,讲解服务器完整监控指标,指导企业搭建从设备监控到业务可见的监控体系。
很多企业做监控时,第一反应是先把路由器、交换机、防火墙全部纳入监控,却容易忽略一个事实:如果服务器承载着核心业务,那么服务器故障往往比单台交换机故障更容易直接转化为业务中断。 ManageEngine OpManager 可以同时覆盖网络设备、物理服务器、虚拟服务器、接口、进程和服务等监控对象,因此企业做企业网络监控时,真正应该规划的不是“监控多少台设备”,而是“哪些对象最值得优先监控”。
关键要点(Key Takeaways)

一、为什么不能只盯着交换机和路由器?
传统网络监控通常从设备可用性开始。
交换机有没有宕机?路由器接口有没有掉线?核心链路带宽是不是跑满?这些都是重要的网络监控指标。
但对于企业IT环境来说,网络设备只是业务链路的一层。
一条典型业务链路可能是:
用户终端 → Wi‑Fi/AP → 接入交换机 → 核心交换机 → 防火墙/路由器 → 服务器 → 数据库/应用服务。
其中任何一环出现问题,都可能导致用户无法访问系统。
问题在于,不同故障造成的业务影响完全不同。
例如,一台普通接入交换机出现故障,可能只影响一个办公区域几十名员工;但承载ERP、数据库、OA或核心业务应用的服务器出现故障,影响范围可能瞬间扩大到整个企业。
所以,监控覆盖不能简单按照“设备重要程度”排序,而应该按照业务影响程度排序。
二、监控优先级,建议采用“四级排法”
企业部署网络监控工具时,可以按照“业务影响、依赖关系、故障可发现性、恢复难度”四个维度进行排序。
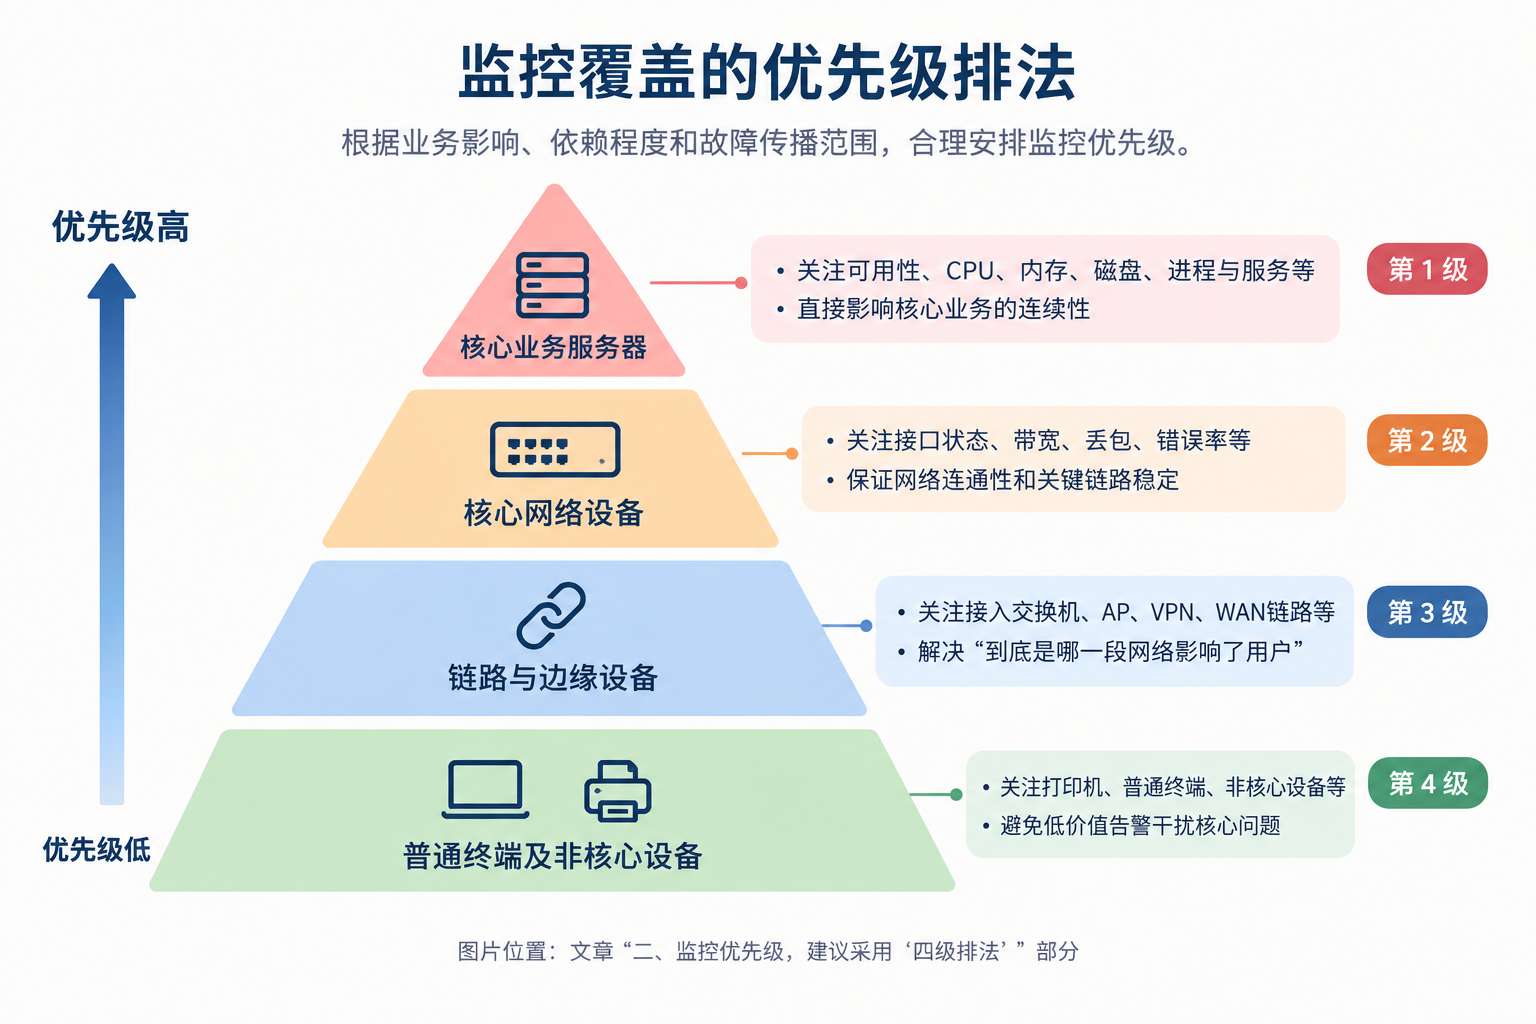
第一级:核心业务服务器
这是服务器监控最应该优先覆盖的一层。
对于承载核心应用的服务器,至少要关注五类指标:
可用性、CPU、内存、磁盘、进程与服务。
例如服务器还在线,但数据库服务已经停止,这时候简单的 Ping 监控并不能发现真正的问题。
因此,系统监控不能只看“服务器在线还是离线”,还要继续向操作系统、进程和应用服务深入。
OpManager 官方服务器监控能力覆盖服务器 uptime、CPU、内存、磁盘、进程和服务,并支持针对不同监控指标配置告警阈值。
这意味着服务器监控应该从“设备是否存活”升级到“业务运行是否健康”。
第二级:核心网络设备
第二优先级才是核心交换机、核心路由器、防火墙以及关键链路。
这一层重点关注:
接口状态、带宽利用率、丢包、错误率、CPU、内存以及设备可用性。
尤其需要关注那些一旦故障就会造成大范围业务中断的设备。
核心交换机和路由器实际上是业务交通枢纽。
因此,网络设备监控的重点不是“每台设备都监控得一样细”,而是首先找出网络中的关键节点。
OpManager 支持对路由器、交换机、服务器、防火墙、负载均衡器以及虚拟化环境等进行统一监控,并提供设备健康、可用性和性能视图。
第三级:链路与网络边缘设备
完成核心设备之后,再逐步扩大监控范围。
这一层包括:
接入交换机、AP、VPN、WAN链路、分支机构设备等。
这时候网络监控的目标,是回答一个非常具体的问题:
“到底是哪一段网络影响了用户?”
例如用户反馈“系统特别慢”,不能只看到服务器CPU正常,就认定服务器没有问题。
还需要同时检查:
Wi‑Fi信号、交换机接口、网络延迟、丢包率、出口带宽以及服务器接口错误。
这也是为什么现代网络监控软件越来越强调统一视图,而不是孤立的设备告警。OpManager 官方产品页支持网络发现、可用性监控、网络设备监控、物理服务器监控、接口监控以及业务视图等能力,可以将多个层面的状态放在同一个监控体系中。
第四级:普通终端及非核心设备
最后再覆盖打印机、普通办公终端、非核心网络设备等对象。
这并不是说这些设备不重要,而是它们通常不应该抢占核心告警的注意力。
如果IT团队每天面对上百条低价值告警,就很容易出现真正重要的服务器或核心链路故障被淹没的问题。
所以监控覆盖的核心原则不是“全”,而是:
先保证关键业务对象可见,再扩大覆盖范围。
三、服务器监控到底该看什么?
服务器监控最容易出现的误区,是只监控CPU。
事实上,CPU利用率只是服务器健康度的一部分。
更完整的服务器监控指标应该至少包括:
| 监控维度 | 重点观察内容 |
|---|---|
| 可用性 | Uptime、响应时间、丢包 |
| 资源 | CPU、内存 |
| 存储 | 磁盘空间、I/O、磁盘延迟 |
| 网络 | 带宽、接口错误、丢包 |
| 服务 | Windows/Linux服务、关键进程 |
| 硬件 | 温度、风扇、电源等硬件状态 |
对于数据库服务器,还需要进一步关注事务、连接数、锁等待等应用相关指标。
OpManager 官方服务器监控页面也列出了 CPU、内存、网络带宽、丢包、接口错误、磁盘I/O、数据库连接等多类监控指标,并支持通过 SNMP、WMI、CLI、API 等方式获取数据。
因此,真正有效的服务器监控不是“CPU监控”,而是建立从可用性→资源→服务→硬件→业务的完整监控链。
四、最实用的监控优先级公式:业务影响 > 设备数量
很多企业做监控规划时,会采用“先监控数量最多的设备”这种思路。
其实更合理的方式是:
监控优先级 = 业务影响 × 依赖程度 × 故障传播范围。
一台普通交换机可能连接50台电脑,但一台核心数据库服务器可能只承载一个应用。
从设备数量看,交换机更值得监控;从业务影响看,服务器可能更优先。
所以,企业不应该问:
“我们应该先监控服务器还是交换机?”
更应该问:
“哪个故障会首先造成业务不可用?”
这才是企业网络监控建设真正应该回答的问题。
五、用OpManager建立从“设备监控”到“业务可见”的体系
以 OpManager 为例,企业可以先通过网络发现建立设备资产视图,再根据业务重要性对服务器、交换机、路由器及其他设备进行分层监控。
之后再利用告警、业务视图、网络可视化和故障排查能力,把“设备异常”进一步关联到“业务影响”。
对于大型企业或多站点环境,OpManager Enterprise Edition 还支持通过 Probe‑Central 架构统一监控分布在不同站点的网络设备和服务器。
这样的网络管理方式,最终目标并不是拥有一个“红点很多”的监控大屏,而是让IT团队更快回答三个问题:
哪里出了问题?
影响了什么业务?
下一步应该先处理什么?
结语:监控不是平均用力,而是把资源放在最关键的地方
服务器挂掉和交换机挂掉,谁更致命,并没有绝对答案。
如果交换机是整个园区网络的核心节点,它的故障同样可能造成全网中断;如果服务器承载的是ERP、数据库或核心交易系统,那么服务器故障也可能直接导致业务停摆。
因此,真正成熟的监控策略不是简单比较“服务器”和“交换机”谁更重要,而是根据业务依赖关系建立优先级:
第一层监控核心服务器,确保业务可用;第二层监控核心网络设备,保证连接稳定;第三层覆盖链路和边缘设备;第四层再逐步扩大到普通终端。
这套思路可以帮助企业从“设备有没有坏”升级到“业务有没有受到影响”。
而这也是现代网络监控软件、系统监控和网络设备监控真正应该解决的问题:不是看见更多告警,而是更快发现真正重要的问题。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 监控优先级为什么优先核心业务服务器而不是交换机?
答:判断依据是业务影响范围。普通接入交换机故障通常只影响局部区域,而承载ERP、数据库的核心服务器故障可直接造成全企业业务中断,因此优先级更高;核心枢纽交换机除外。
- 服务器监控只ping通就够了吗?
答:不够。ping仅判断主机存活,数据库、业务进程停止时主机依然可以ping通,还需要监控CPU、内存、磁盘、进程服务、硬件状态等多层指标。
- 四级监控排法,第三、四级设备是否就不需要监控?
答:不是不需要监控,而是告警优先级做区分。先保证核心业务对象告警不被淹没,再逐步完成边缘、终端设备覆盖,避免低价值告警干扰排障。
- 如何区分核心网络设备和普通网络设备?
答:看故障传播范围。一旦故障会造成大面积业务中断的交换机、路由器、防火墙属于核心网络设备;仅服务局部办公区域的接入设备属于边缘层级。
- 多分支机构场景如何落地这套监控优先级策略?
答:每个站点内部同样套用四级排法,优先各站点本地核心服务器、本地核心网络设备,再接入边缘链路,借助Probe分布式探针完成统一集中管理。

