
大促期间告警暴涨-智能运维如何保障故障响应效率不下降

AI 摘要
大促期间告警量可暴涨三到五倍,传统运维模式面临响应效率断崖式下降的危机。本文以某头部电商双11实战为例,剖析智能运维如何通过告警降噪、AI根因分析与自动化处置闭环,将MTTR从小时级压缩至分钟级,并结合ManageEngine OpManager Nexus的自适应阈值、智能事件关联与全栈可观测性能力,给出大促全周期运维保障方案,确保故障响应效率不随告警量波动。
每逢大促,电商与零售企业的IT系统都会迎来流量洪峰,实例成倍扩容、告警复杂度陡升,运维团队极易陷入"告警风暴"。从网络监控、服务器监控到应用性能监控(APM),智能运维的价值贯穿全栈。智能运维(AIOps)是将AI引入监控、分析与响应环节的运维模式,其核心价值正是在告警暴涨期守住故障响应效率的生命线。据行业观察,大促峰值时段的告警量可达日常的三到五倍。


一、大促告警风暴:故障响应效率为何断崖式下降
某头部电商品牌在去年双11大促期间,一度面临运维体系几乎崩溃的危机。大促启动后两小时,其核心交易链路的告警量从日常日均约800条瞬间飙升至3700余条,涨幅超过四倍。然而,告警量暴涨只是表象,更深层的问题在于传统告警处理模式与流量洪峰之间的结构性错配。
告警量指数级暴涨,人工研判触达天花板
大促期间应用扩容、容器实例翻倍、链路调用密度骤增,监控指标采集基数随之膨胀。该品牌一次支付数据库的轻微抖动,便沿调用链引发了超过2000条级联告警,涵盖应用超时、容器重启、数据库连接池满等多个维度。值班工程师被各平台通知刷屏,逐条研判根本无从下手,真正指向根因的有效告警被淹没在噪音之中——告警量上涨与人力带宽不匹配,故障响应效率反向下降成为必然。
混合架构下的告警孤岛,根因定位链路过长
该品牌的IT架构横跨公有云、本地IDC与CDN节点,各层监控系统各自为政:网络告警、云资源告警与应用性能数据分散在五个不同的监控平台。故障发生时,工程师需要反复切换界面、手工拼接时间线,从海量数据中拼凑出故障全貌。这一次数据库抖动引发的连锁反应,团队耗费了近40分钟才锁定问题源头——而大促中每延迟一分钟,损失都以百万计,MTTR随之失控。
告警疲劳:被忽视的隐性成本
比告警量更危险的是告警疲劳。该品牌值班工程师连续数小时面对高密度低质量告警,敏感度出现系统性钝化,部分高危告警险些被下意识忽略。长期告警过载的团队漏判率明显上升,大促的连续作战场景更将风险成倍放大——故障响应效率的下降,不仅是技术问题,更是人因问题。
智能运维重构故障响应效率的三条路径
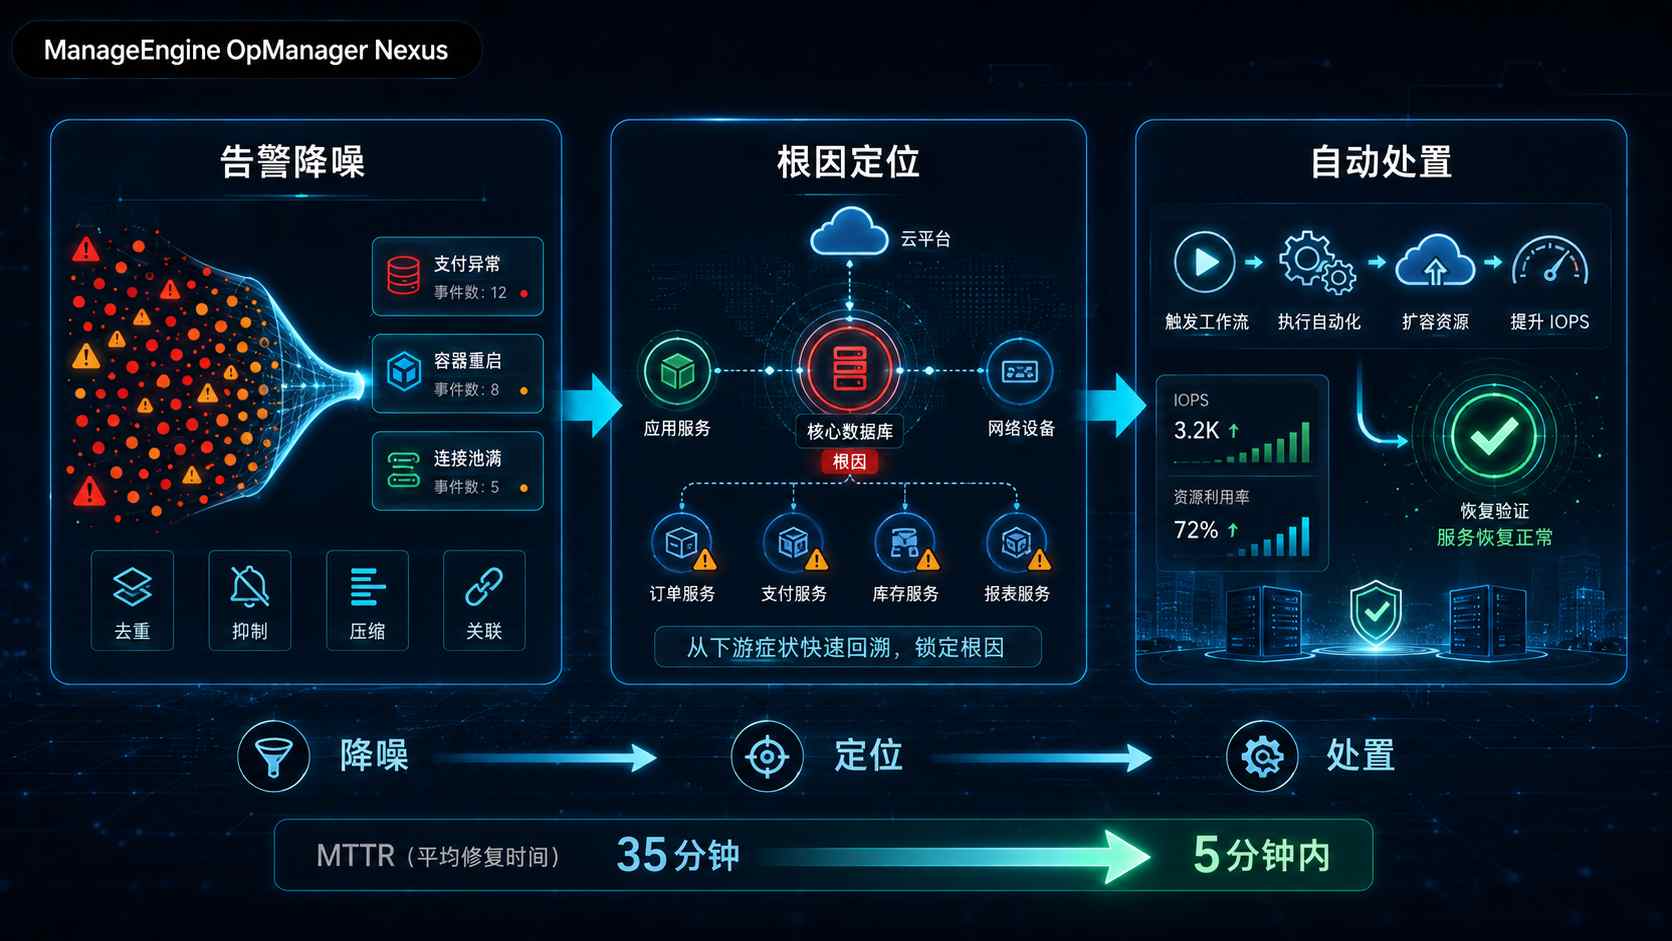
面对上述危机,该品牌借助OpManager Nexus智能运维平台,用算法替代人力完成告警链路中最耗时的环节,让工程师只做"判断题",不再做"检索题"。具体到大促场景,智能运维的逻辑沿降噪、定位、处置三个环节依次展开,环环相扣地重建故障响应效率。
告警降噪与智能关联:从告警洪流到事件视图
智能运维的第一道防线是告警降噪。OpManager Nexus的自研Zia引擎对涌入的原始告警实时执行去重、压缩与抑制规则,叠加AI驱动的相关性分析,将同源告警聚合为单一事件,并按业务服务维度重新呈现。最终,数千条原始告警被收敛为十几个个带上下文的高级事件,值班人员得以聚焦支付链路异常这一真正重要的问题,故障响应效率由此获得数量级提升。
根因分析与拓扑联动:压缩MTTR的关键环节
降噪解决"看得过来",根因分析解决"看得准"。OpManager Nexus基于全栈IT资源依赖拓扑,将告警与性能指标、配置变更、日志事件时序关联,从下游大量服务超时告警反向推演上游根因节点。平台数分钟内直接锁定根因——支付数据库所在云主机的IOPS突增。
自动化处置闭环:让标准故障实现自愈
针对"数据库IOPS过高导致响应变慢"这一处置路径明确的已知故障,OpManager Nexus构建了自动化闭环:告警触发预定义工作流,自动执行弹性扩容、临时提升IOPS上限,并验证恢复效果。整个过程实现分钟级闭环,无需人工介入。
下表对比了传统模式与智能运维模式在故障响应效率上的关键差异:
| 对比维度 | 传统运维模式 | 智能运维模式(OpManager Nexus) |
|---|---|---|
| 告警处理 | 人工逐条研判,有效告警易淹没 | 智能事件关联聚合降噪,按高级事件呈现 |
| 根因定位 | 跨平台手工拼接时间线,数十分钟起步 | 依赖跟踪+Zia根因分析,分钟级定位 |
| 故障处置 | 依赖值班人员手动操作 | 自动化工作流执行预案,标准故障自愈 |
| 峰值承载 | 告警暴涨即响应崩溃 | 告警量与响应效率解耦,稳定输出 |
三、OpManager Nexus落地:智能运维护航大促全周期
路径已清晰,理念能否落地取决于平台是否为大促这类极端场景做好准备。这正是OpManager Nexus的价值所在。
该品牌的成功并非偶然。OpManager Nexus的价值在于为大促这类极端场景做好全周期准备。
大促前:基线学习与容量预案
大促保障的功夫在战时,更在平时。OpManager Nexus的自适应阈值通过机器学习每小时基于历史数据自动计算并调整性能阈值,从源头减少正常波动产生的告警噪音;性能趋势预测可预估CPU、内存、带宽与磁盘空间的耗尽时间,让扩容预案有据可依。对临时扩容的云主机与容器实例,自动化发现与模板批量下发确保新增资源数分钟内纳入监控。
大促中:统一作战视图与分钟级响应
进入保障期,OpManager Nexus以全栈可观测性视图将网络、服务器、应用与云资源的告警汇聚于统一界面,消除告警孤岛;智能事件关联通过依赖跟踪、上下文感知聚类与ML模式识别,把告警风暴转化为高级事件,Zia洞察仪表盘直接提示潜在根因与可执行建议。处置侧,拖拽式无代码自动化工作流内置70多种操作,把"发现---定位---处置"全链路压缩到分钟级。该品牌在大促峰值压力下,MTTR从平均35分钟缩短至5分钟以内。
大促后:复盘沉淀,让效率提升可持续
大促结束不代表智能运维工作终止。OpManager Nexus的报表与性能趋势分析能力,可复盘告警分布与处置效果,并将新故障模式沉淀为阈值策略与自动化工作流。经过几轮大促迭代,该品牌的故障响应效率提升已从"临时保障"转化为"常态化能力"。
四、结论:智能运维让故障响应效率不随告警量波动
大促告警暴涨是常态,但故障响应效率下降不是。智能运维通过告警降噪、根因分析与自动化闭环三条路径,让运维团队在告警风暴中保持清醒与高效。OpManager Nexus以AI原生架构,将异常检测、智能事件关联、根因分析等AIOps能力直接纳入核心产品,无需额外付费即可获得自研Zia引擎驱动的完整智能运维体验;本地部署模式确保监控数据始终处于企业自身安全边界内,并具备良好的国产化环境适配能力。故障响应效率的保障,最终比拼的不是值班人数,而是平台的智能化水平。立即访问ManageEngine官网,体验OpManager Nexus智能监控,为下一次大促提前布防。
- 需要深入交流?预约产品专家一对一定制化演示!
- 获取报价?填写信息获取官方专属报价!
- 想了解更多?点击进入OpManager Nexus官网并查看更多内容!
- 本地化部署!免费下载安装并享30天全功能开放!
- 倾向云版本?免费试用云上一体化解决方案!
五、常见问题(FAQs)
- 大促期间告警暴涨,运维团队应该先做什么?
答:先建立告警降噪机制,通过去重、压缩与智能事件关联把原始告警收敛为可处置事件;再按业务服务划分告警优先级,确保核心交易链路的告警优先响应。
- 智能运维平台如何提升故障响应效率?
答:核心在三个环节:AI驱动的异常检测与智能事件关联减少无效告警干扰,依赖跟踪与根因分析缩短定位时间,自动化工作流加速处置执行。三者协同,可将故障响应从"小时级"压缩到"分钟级"。
- 中小企业没有专职SRE团队,能用好智能运维吗?
答:可以。自适应阈值通过ML每小时自动计算并调整阈值,无需复杂算法调参;拖拽式无代码工作流内置70多种操作,中小团队按向导配置即可启用自动化处置,显著降低智能运维的落地门槛。OpManager Nexus将AIOps能力直接纳入核心产品,无需额外付费。
- 智能运维与传统网管软件的本质区别是什么?
答:传统网管软件侧重数据采集与阈值告警,响应链路依赖人工;智能运维则引入AI降噪、根因分析与自动化闭环,让平台参与"分析"与"处置"环节,将监控、分析与响应整合为统一的智能运维体系。
- 混合云环境下如何避免告警孤岛?
答:关键在于统一采集与统一呈现。应选择能同时纳管本地IDC、多云资源与应用层指标的平台,将告警汇聚到同一视图关联分析。OpManager Nexus的全栈可观测性能力正是为解决混合架构告警割裂问题而设计。
扩展阅读
- 白皮书:《FSO 全栈可观测性——实施、优势、与 ROI 全方位解读》
- 白皮书:《AIOps2.0——在您的 IT 堆栈中智能扩展》
- 一次故障的30分钟极速修复——智能运维如何把MTTR降至30分钟以内 - ManageEngine Article Blogs
- AIOps 深度实战 --- 从告警关联到根因定位的完整路径 - ManageEngine Article Blogs
- 告别告警洪流与被动救火:2026智能运维(AIOps)规模化落地实战 - ManageEngine Article Blogs
