
Agentic AI自治运维的下一站:AI可观测性治理 ——从OpManager Nexus看运维Agent的可解释、可审计与可回滚

AI 摘要
Agentic AI 正将 IT 运维从“给建议”推向“直接执行”,但自治的前提是每一次决策都可解释、可审计、可回滚。本文从治理视角出发,剖析 Agentic AI 自治运维的核心矛盾,并以 ManageEngine OpManager Nexus 为例,说明运维团队如何让 Agent 的每一次判断都有可追溯的来路。OpManager Nexus 通过 Zia Agents、智能事件关联、因果 AI、护栏机制与 MCP Server,将自治运维纳入可治理的工程框架,让运维团队在 Agent 执行之后仍然拿得出证据、说得清原因、兜得住后果。

一、当 Agent 开始动手,可观测性的边界必须重新定义
AI 可观测性体系在传统可观测性三支柱之上,增加了 Agent 任务来源、上下文快照、判断依据和执行后果的采集与关联能力。
OpManager Nexus 通过 Zia Agents、智能事件关联、因果 AI、护栏机制与 MCP Server,将自治运维纳入可治理的工程框架。
自治不是让 Agent 放手干,而是让运维团队在 Agent 执行之后仍然拿得出证据、说得清原因、兜得住后果。
凌晨两点,告警风暴。AIOps Agent 自动关联了数十条告警,判断根因是存储节点 I/O 异常,随即触发副本迁移,故障恢复。第二天早上,值班工程师看到一条“已自动处置”的记录。运维团队面临三个无法回避的问题:Agent 为什么选择这个节点?它当时看到了哪些指标?如果三天后审计来查,拿什么证明这次操作是合理的?
Gartner 预测,到 2026 年近 40% 的企业应用将嵌入任务型 AI Agent,而到 2029 年至少 70% 在生产环境中使用 Agentic AI 的企业将经历与运行时控制不足相关的重大服务、安全或成本事件。与此同时,行业调查显示多数企业仍要求对 AI 自动化操作保留人工审批——不是不信任 AI 的能力,而是不信任它的可解释性。自治与信任之间的缺口,正是 AI 可观测性体系需要填补的位置。
本文将从治理视角出发,剖析 Agentic AI 自治运维的核心矛盾,并以 ManageEngine OpManager Nexus 为例,说明运维团队如何让 Agent 的每一次判断都有可追溯的来路。
二、自治运维的治理缺口:看得见,不等于说得清
智能运维(AIOps)解决了“从数据中看清问题”的能力,但当 Agent 开始直接执行变更时,运维的挑战从“看清”变成了“管住”——这正是自治运维需要 AI 可观测性治理的原因。
传统可观测性回答的是“系统发生了什么”——指标、日志、链路、拓扑。但当运维 Agent 开始直接执行变更时,另一个问题变得同样关键:Agent 为什么这样做?
对自主系统无效,必须在运行时环境中嵌入代码驱动的、确定性的护栏。该框架同时警告,不治理的 Agentic AI 将在运营稳定性、财务波动、合规差距、Agentic 安全威胁和 AI 主权五个领域暴露企业风险。
AI 可观测性体系与传统可观测性的区别
AI 可观测性体系是在传统可观测性三支柱之上,增加对运维 Agent 决策过程的观测能力。它不是替代指标、日志和链路,而是在此基础上回答四个治理层面的核心问题。
运维四问:治理框架的核心
它接到了什么任务?谁授权的?——是告警触发还是人工下发?任务边界在哪里?只能查还是能改?授权来源是否可追溯?
它当时看到了什么?——指标、日志、CMDB、变更记录的版本快照是否完整?有没有把测试环境当成生产环境?
它依据什么做决定?谁审批的?——依据了哪条 Runbook、什么阈值?权限校验是否通过?为什么本该触发的审批没有触发?
它做了什么,后果是什么?——执行了什么动作?影响了哪些服务?能不能回滚?谁负责回滚?
这四个问题构成了 AI 可观测性体系在运维场景中的落地框架。治理的核心不是“收集什么数据”,而是“谁能做决定、边界在哪里、出了问题怎么兜底”。
三、OpManager Nexus 如何支撑 AI 可观测性治理
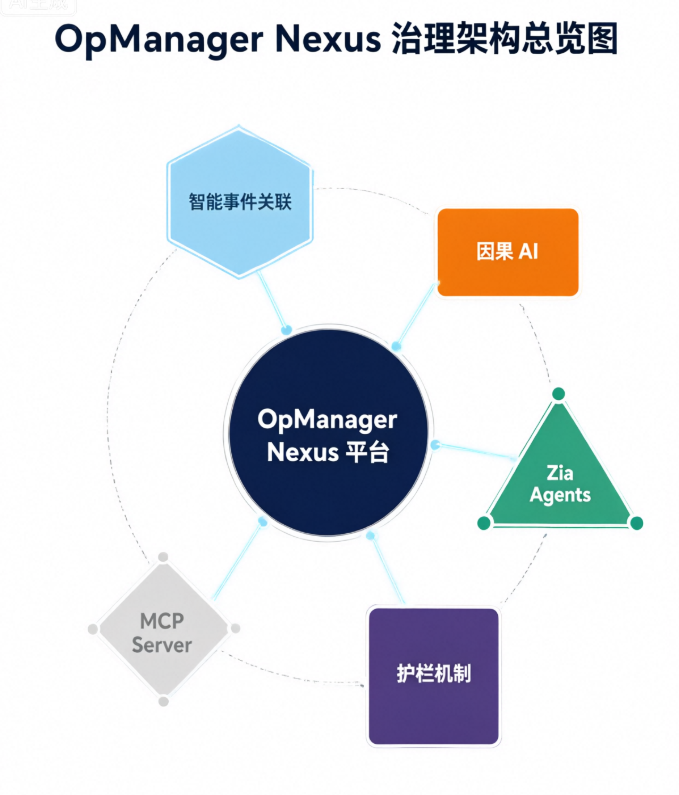
面对上述治理缺口,OpManager Nexus 的设计思路不是简单地“增强自动化”,而是让自动化从一开始就运行在可治理的框架之内。
3.1 智能事件关联与因果 AI:治理从输入质量开始
Agent做出错误决策,往往不是因为模型能力不够,而是因为输入本身就是噪音。OpManager Nexus的智能事件关联引擎将数百条告警收敛为少数可执行的问题。因果AI引擎进一步在时间序列数据上做条件依赖分析,区分“CPU飙升导致慢查询”和“慢查询导致CPU飙升”。这意味着Agent做决策时依据的不是未经验证的原始告警,而是经过收敛和因果分析的运维事实——治理从输入质量开始。
3.2 Zia Agents: 在护栏内执行,每一步留痕
Zia Agents 基于 Agent Studio 无代码构建器部署,连接到 OpManager Nexus 的实时监控数据和工具。关键设计在于护栏机制:每个 Agent 可以访问哪些工具、读取哪些数据、执行哪些动作,都在部署前由运维团队精确设定。超出边界的事件自动升级到人工处理。根据官方说明,每一个 Zia Agent 执行的动作都自动记录完整的审计轨迹,包括时间戳和执行结果,团队可以清楚看到执行了什么、何时执行、改变了什么。
3.3 MCP Server 与上下文可信
OpManager Nexus 的原生 MCP Server 让 AI 客户端通过标准化接口安全访问实时监控数据。对于治理而言,这意味着 Agent 做决策时拿到的是经过认证的实时运维上下文,而非模型生成的推测。同时,平台支持本地部署,确保敏感监控数据不出企业边界。治理依据可信,结论才可信。
3.4 审计留痕与回放:让后果可追溯
当 Zia Agent 执行了服务重启或配置变更之后,运维团队可以追溯到:任务来源是什么、当时的监控上下文是什么、调用了哪个工具、影响了哪些服务。这构成了 AI 可观测性体系的闭环——任务、上下文、依据、动作、后果,五段证据链完整可查。
四、从自动化运维到自治运维:一条落地路径
第一阶段:事件关联与根因分析。把告警风暴收敛为可执行的信号,让 Agent 的输入经过验证。
第二阶段:护栏内 Agent 执行。低风险操作在预设边界内自动执行,高风险操作等待人工审批。
第三阶段:AI 可观测性体系闭环。每一次 Agent 决策都有可回放的证据链——任务、上下文快照、判断依据、权限校验、执行结果、影响范围。OpManager Nexus 的审计日志和 Zia Agents 的完整执行记录,让这一闭环具备工程可操作性。
从服务器监控到网络设备监控,从应用性能到存储健康,AI 可观测性体系的覆盖范围决定了治理的完整度。
总结
Agentic AI 自治运维的终点不是“不用人”,而是“人能兜住”。当 Agent 在凌晨两点自动执行了一次变更,值班工程师、SRE 负责人和合规审计员需要在第二天早上拿到同一份东西:它接到了什么任务,看到了什么,依据了什么,做了什么,造成了什么。
OpManager Nexus 的 Zia Agents、智能事件关联、因果 AI、护栏机制与 MCP Server,正是围绕这一治理需求设计的。它不是替代运维工程师的判断,而是让 Agent 的每一次判断都有来路、有边界、有证据。访问 ManageEngine 官网申请 OpManager Nexus 30 天免费试用,体验 Zia Agents 在护栏内自主执行的完整流程,以及每一次决策的审计回放能力。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- AI 可观测性体系和传统可观测性有什么区别?
答:传统可观测性聚焦指标、日志和链路,回答“系统发生了什么”。AI 可观测性体系在此基础上增加对运维 Agent 的观测——它接到了什么任务、看到了什么上下文、依据什么做决定、执行了什么动作。两者结合,才能让自治运维具备可解释和可审计的基础。
- Agentic AI 自治运维会不会让运维团队失去控制?
答:关键在于护栏机制。OpManager Nexus 的 Zia Agents 在部署前由运维团队精确定设每个 Agent 的权限边界——能访问哪些工具、能执行哪些动作。超出边界外的操作自动升级到人工处理,而不是由 Agent 自行判断。自治的前提始终是可控。
- Zia Agents 执行的操作能追溯吗?
答:可以。每一个 Zia Agent 的动作都自动记录完整的审计轨迹,包括时间戳和执行结果,团队可以清楚看到执行了什么、何时执行、改变了什么。运维团队可以在事后回放整个决策过程,满足合规审计和故障复盘的需求。
- OpManager Nexus 支持本地部署吗?AI 数据会不会外泄?
答:平台支持 Zoho 托管模型和企业自有的本地部署两种模式。本地部署下,Zia Agents 和 AI 模型运行在企业自有环境中,监控数据不出企业边界。MCP Server 通过标准化接口安全访问实时监控数据,兼顾 AI 能力与数据主权。
- AI 可观测性体系需要额外购买工具吗?
答:不需要。OpManager Nexus 将 AI 可观测性治理能力集成在统一平台中。智能事件关联、因果 AI、Zia Agents、审计留痕和 MCP Server 都是平台的原生能力,开箱即用,无需额外集成第三方治理工具。
扩展阅读
