
物理服务器监控的"硬件心电图":趋势比阈值更早

AI 摘要
物理服务器监控正从"通不通"走向"还能撑多久"。硬件劣化早于应用告警数小时到数天,静态阈值却必然误报漏报。OpManager Nexus 以自适应阈值建立动态基线,覆盖25类以上硬件指标与IPMI带外监控,Zia智雅大模型驱动根因分析、MTTR缩短40%-60%,3D机架视图让巡检一屏完成,并适配信创环境。
IT 运维正在同时面对三台“加速器”:设备数量激增、数据量爆炸、告警复杂度成倍上升。传统服务器监控只回答“通不通”,却无法回答“还能撑多久”。ManageEngine OpManager Nexus 给出的答案是:回到硬件本身,用趋势替代阈值,让运维团队第一次在故障发生之前拿到预警。
本文将从故障机理、阈值失效、平台能力、落地路径四个维度,剖析这一转变如何真正赋能运维团队。
关键要点(Key Takeaways)
- 硬件级指标的劣化通常早于应用层告警数小时到数天,是宕机前最早的可观测信号。
- 静态阈值必然同时制造误报与漏报,趋势监测才是可持续的告警方式。
- OpManager Nexus 通过自适应阈值模块与 Zia AI 引擎,为每台设备建立专属动态基线。
- 3D 机架视图将单台设备的健康度还原到机柜 U 位上,让机房巡检从“逐个登录”变成“一屏浏览”。


为什么物理服务器的硬件信号比应用告警更早
理解了“谁先报警”,就理解了为什么要重做物理服务器监控的逻辑。
宕机之前,硬件早已“发烧”
风扇转速持续爬升、电源模块输出波动、磁盘 SMART 属性缓慢劣化——这些变化往往以小时甚至天为单位渐进发生。据行业观察,相当比例的硬件宕机在发生前数小时已出现可测量的前兆,只是没有被持续跟踪。CPU 温度监控、风扇与电源状态、RAID 控制器健康度,共同构成设备的“硬件心电图”:单看某一刻的数值意义有限,连起来看走势才能判断设备正走向故障还是只是负载偏高。
只看可用性监控,等于“事后知情”
Ping 通断、端口探测、服务可用性监控解决的是“现在有没有挂”的问题,对“明天会不会挂”无能为力。一次风扇停转从发生到 CPU 过热保护停机,可能只有十几分钟;而 RAID 阵列降级到数据不可恢复之间,也隔着一段宝贵的处置窗口。只盯可用性,等于把这段时间拱手让出。
这也解释了为什么越来越多团队把硬件健康度监控列为宕机预防的第一道防线——它比应用告警更早,比人工巡检更勤。
静态阈值告警的三大失效场景
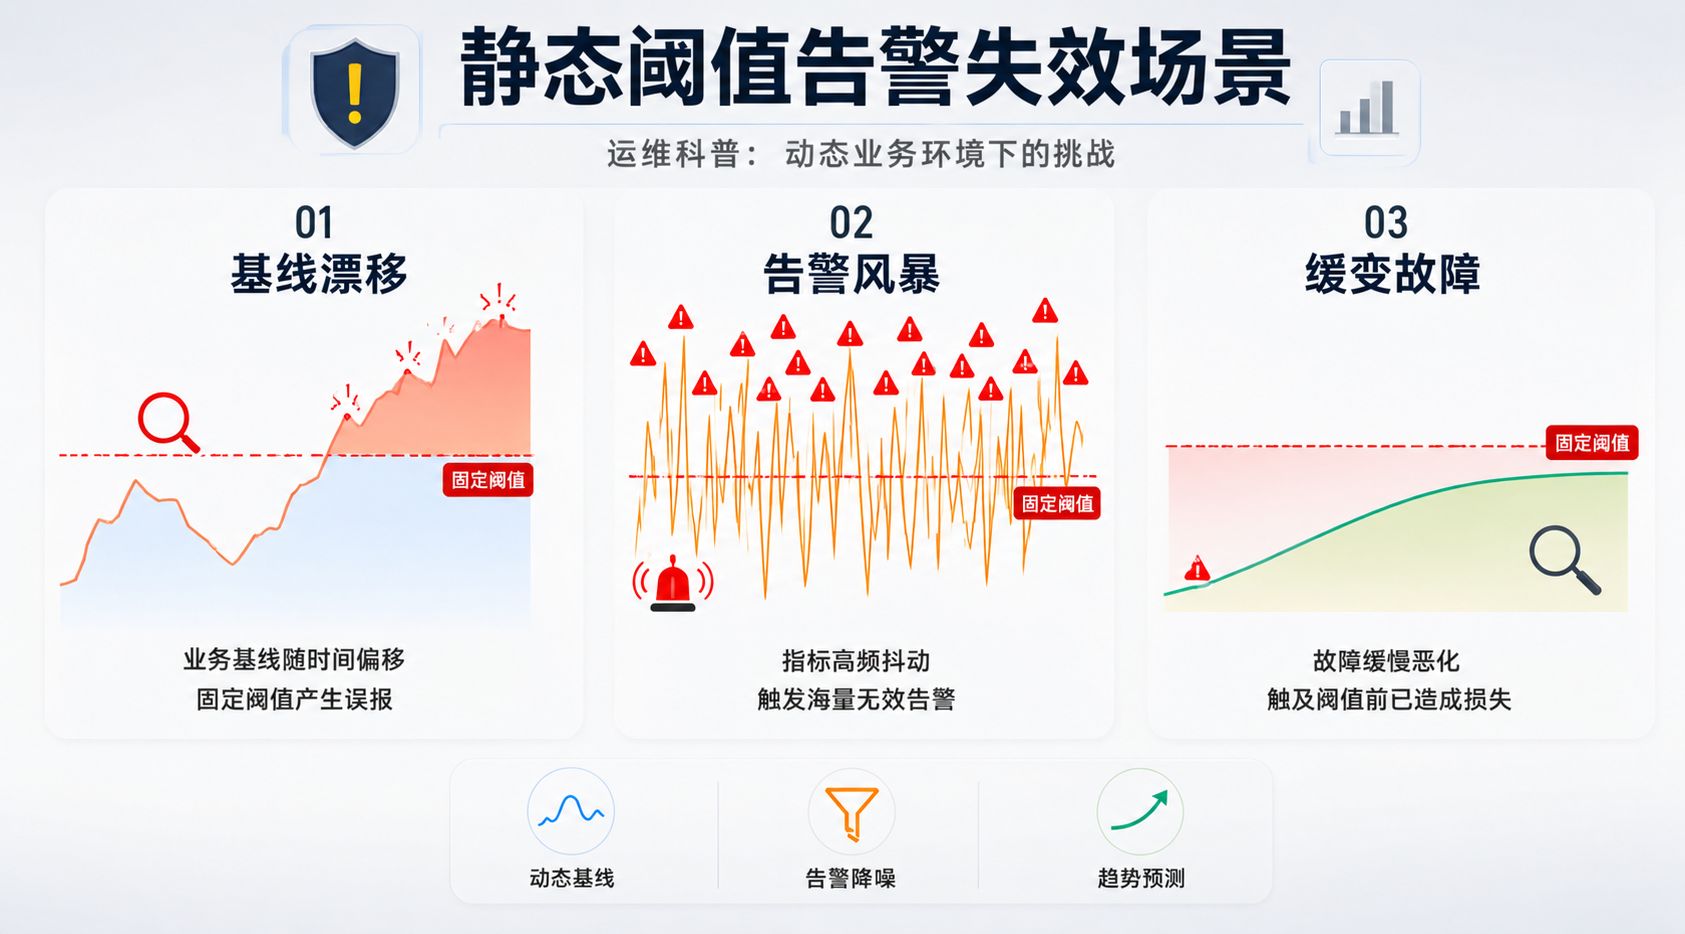
阈值本身没有原罪,问题在于它被写死之后,世界仍在变化。
基线漂移:业务高峰与硬件老化让固定阈值失真
一台设备在启用三年后,同样的 CPU 温度对应的故障风险完全不同。固定阈值要么为“新设备”而设、导致老设备常年误报;要么为“峰值负载”而设、导致日常漏报。阈值没人敢改、也没人记得改,最终成为告警系统的摆设。
告警风暴:误报泛滥如何淹没有效信号
据多数企业运维团队反馈,告警平台中真正需要立即处置的事件占比往往不足十分之一。当大量静态阈值在同一时段触发,运维人员会养成“先忽略、再说”的习惯——而真正的关键告警,就埋在噪声里被一起跳过。
遗漏缓变故障:缓慢劣化从不触发阈值
最危险的故障往往最安静。电容老化、磁盘坏道累积、散热效率逐年下降,都是缓慢劣化型问题:数值每天变一点点,从不越过那条人为划定的线,直到有一天设备突然停止响应。静态阈值对这种故障结构性失明。
OpManager Nexus 如何用“趋势监测”替代阈值告警
既然问题出在“一刀切”的阈值,解法自然是让每台设备拥有自己的动态基线。
自适应阈值模块:AI 学习每台设备的“正常心跳”
OpManager Nexus 的自适应阈值模块会基于设备历史表现,用机器学习为每个指标单独计算正常区间,并随业务周期自动调整。工作日与夜间、月初与月末的基线本就该不同——自适应阈值让“异常”重新定义为“偏离自身历史规律”,而非“超过一个拍脑袋的数字”。这直接压缩了误报,也让缓变故障无处遁形。
25类以上硬件健康指标与 IPMI 带外监控
即使操作系统无响应,带外管理通道依然在线。通过 IPMI 带外监控,OpManager Nexus 可在服务器宕机、系统无法登录时仍读取温度、电压、风扇、电源状态等底层硬件数据,判断是软件问题还是硬件问题,为抢修争取方向感。配合磁盘 SMART、RAID 状态等指标的持续采集,硬件健康度监控覆盖从芯片到阵列的完整链路。
Zia AI引擎:从异常检测到根因提示
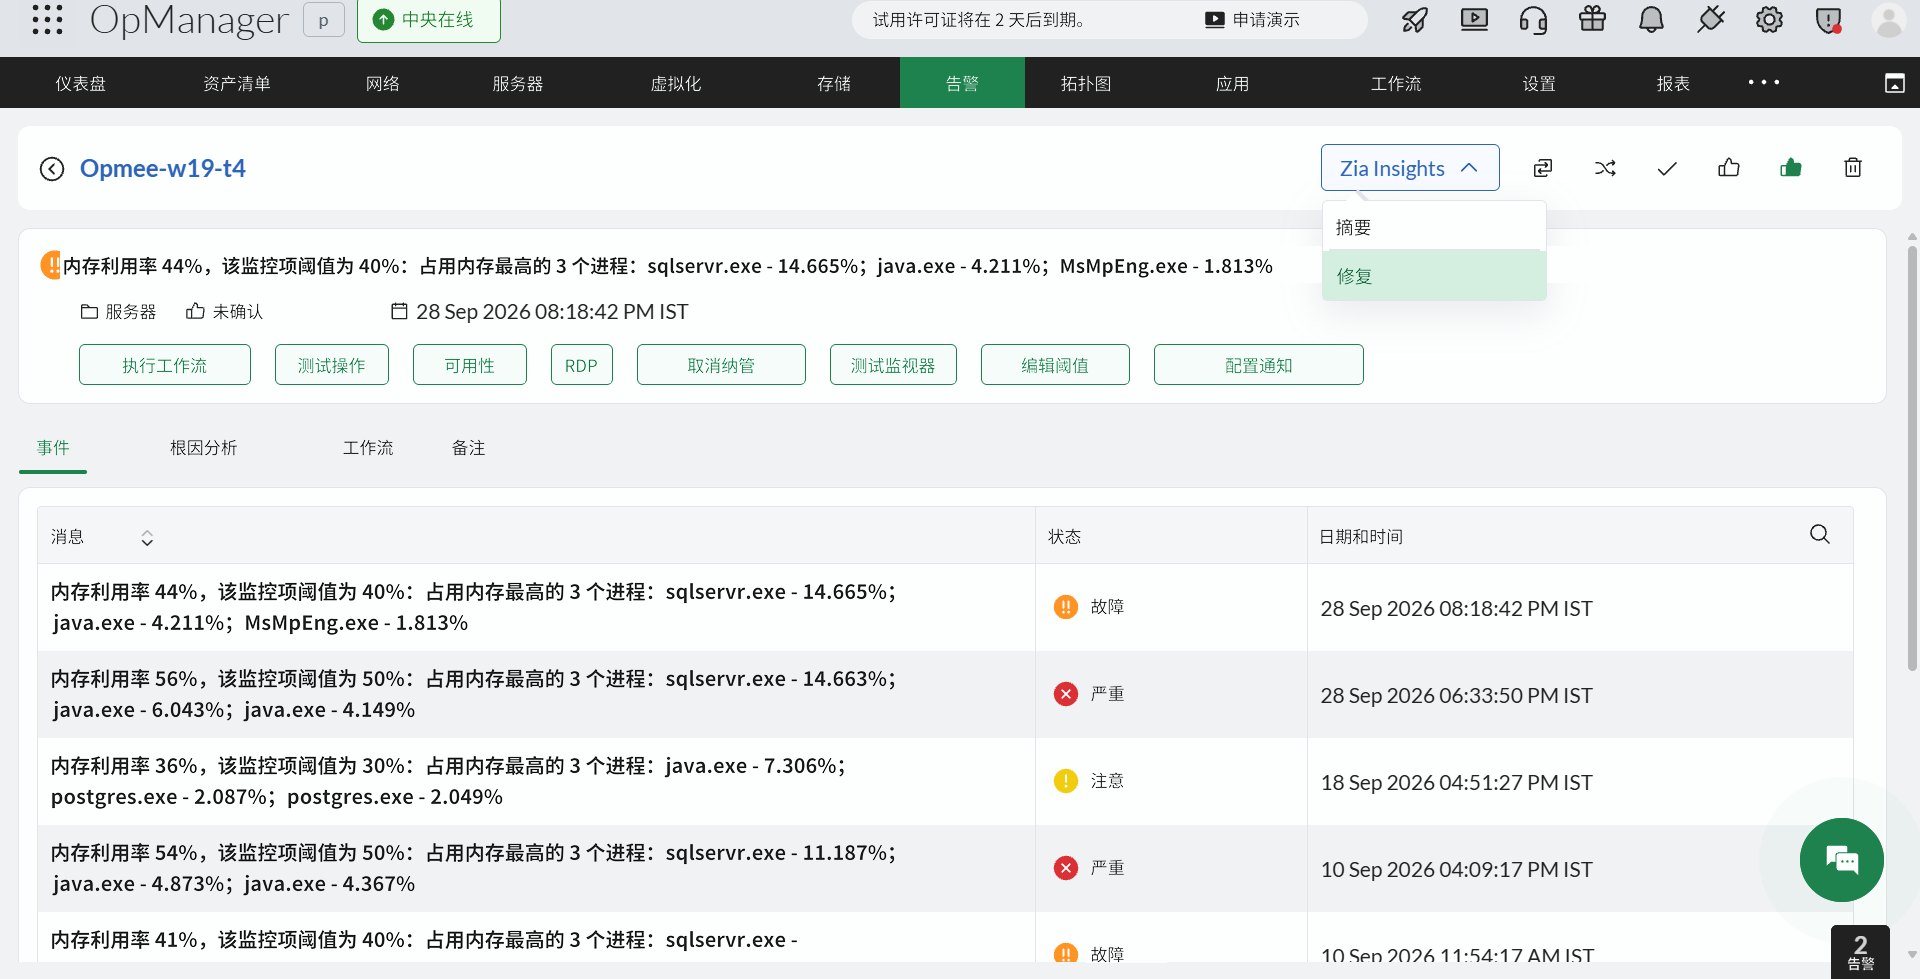
发现异常只是第一步。OpManager Nexus 内置的 Zia AI 引擎由 ManageEngine 自研的 Zia 智雅大模型驱动——该模型支撑卓豪全系列 120 余款产品的 AI 能力、服务超 1.5 亿用户。在物理服务器监控场景中,Zia 对告警进行关联分析与异常模式识别,帮助运维人员从“CPU 温度升高、风扇转速异常、功耗波动”这一组信号中直接收敛到“散热系统故障”这一根因;其对应的根因分析智能体可自主完成“检测—调查—关联分析—处置—归档”的完整链路,将平均故障解决时间(MTTR)缩短 40%-60%,原本耗费数小时的排查工作被压缩至分钟级。对人员有限的中小企业 IT 团队而言,这一步把“看懂告警”变成了“收到结论”。
从单台设备到整个机柜:3D 机架视图与容量管理
监控颗粒度决定运维效率,而机柜是物理世界与数字世界的交界。
3D 机架视图:U 位、温度分布与热点定位
OpManager Nexus 的 3D 机架视图将每台服务器映射到机柜的具体 U 位上,叠加实时健康状态与温度分布,热点机柜一目了然。传统巡检需要逐台登录带外管理界面核对状态,现在打开统一可观测性仪表板即可完成机柜级巡检;U 位占用与剩余空间同步可视,机柜容量规划和设备上架决策也有了数据依据。
不同规模团队的落地路径
对数据中心运维团队,3D 机架视图与多机房拓扑组合使用,可将例行巡检从小时级压缩到分钟级;对中小企业 IT 负责人,开箱即用的设备模板意味着不需要专职监控工程师也能跑起完整链路;对 MSP 服务商,多租户架构让托管客户的物理基础设施在同一平台分权管理,报告输出即可作为服务交付物。值得一提的是,对于习惯用开源方案自建监控的团队,平台的价值不在“能不能采数”,而在省去了阈值调优、告警降噪与界面开发这三项长期维护成本——这类隐性人力开支,往往是自建方案预算表上被低估的部分。
数据安全与信创环境的双重适配
智能化能力要落地,前提是数据不出域、系统跑得动。Zia 智雅智能体运行于自研模型之上,数据全程留存在北京、上海双活数据中心,不向外部第三方模型传输,客户数据亦不用于模型训练,并严格落实网络安全等级保护(MLPS)要求,实现“可用不可见、可控可审计”。
同时,OpManager Nexus 全面适配国内企业 IT 基础设施:支持人大金仓数据库、麒麟与欧拉操作系统、ARM 架构及东方通中间件,兼容 DeepSeek 等主流模型。对于在信创环境内运营的数据中心而言,这意味着趋势监测能力可以部署在现有技术栈之内,而非另起炉灶。
落地建议:把物理服务器监控纳入日常巡检的四个步骤
第一步,通过网络发现自动纳管存量物理机,按品牌型号匹配开箱即用的监控模板,避免逐个手工配置。
第二步,启用自适应阈值模块,用一到两周让 AI 完成基线学习,此期间保留人工观察。
第三步,将硬件健康度指标纳入每日巡检视图,重点关注连续偏离基线而非单点越线的设备。
第四步,把告警对接至现有工单或 IM 通道,并为机柜级巡检建立固定节奏。四步走完后,运维团队的注意力将从“处理告警”迁移到“消化预警”。
总结
物理服务器监控的终点,不是把更多指标搬上大屏,而是把故障发现的时间点从“发生后”挪到“发生前”。趋势先于阈值,本质是把判断标准从人为划线的数字,换成设备自己的历史规律。OpManager Nexus 以 AI 原生的自适应阈值、开箱即用的监控模板,叠加 Zia 智雅大模型带来的零 Token 成本智能体能力——企业无需按用量计费,即可将 AI 深度嵌入日常运维流程;配合对国产服务器、操作系统与数据库环境的全面适配,把这套范式做成了默认配置而非定制工程。如果您的团队仍在告警风暴中人工降噪,现在就可以访问 ManageEngine 官网,预约 OpManager Nexus 演示,亲眼看看“事前预警”是什么样子。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- 1. 物理服务器监控和云主机监控有什么区别?
答:物理服务器监控多一层硬件维度,需采集温度、风扇、电源、RAID 等带外指标。云主机通常无硬件层访问权,监控集中在资源使用率。二者互补而非替代,混合架构需同时覆盖。
- 2. 自适应阈值会不会漏掉突发故障?
答:不会。自适应阈值判断“偏离自身基线”,突发故障同样表现为瞬时异常,且 Zia 智雅大模型驱动的智能体可对多指标信号做关联研判。它防的是误报,不是漏报。极端场景仍可叠加少量人工兜底阈值。
- 3. OpManager Nexus 支持哪些服务器品牌和硬件指标?
答:主流 x86 服务器品牌均可通过 SNMP、WMI、CLI 或 IPMI 纳管,指标覆盖温度、风扇、电源、RAID、磁盘 SMART 等。具体型号兼容性建议以官网设备支持列表为准。
- 4. 没有装 Agent 的服务器可以监控吗?
答:可以。基于 SNMP、WMI 的无代理采集覆盖常规性能指标,硬件层数据通过 IPMI 带外通道读取。Agent 不是必要条件,但装上后颗粒度会更细。
- 5. 3D 机架视图对中小机房是不是过度配置?
答:不是。中小机房恰恰缺专职巡检人力,机架视图把分散设备收拢为一屏,配合健康状态着色,一个人也能完成过去需要多人配合的巡检工作。
扩展阅读:
