OpManager Nexus 产品功能全解析:从网络监控到智能运维的全面进化

AI 摘要
OpManager Nexus 将网络监控、服务器监控、硬件监控、配置管理、流量分析整合到统一控制台,消除工具孤岛。借助 Zia AI 自适应阈值学习14天数据、每小时更新基线,支持3000+指标自动阈值管理;自动生成Layer 2拓扑、业务视图与3D机房视图;探针-中心架构支持多站点分布式监控。本文全面解析其从网络监控到智能运维的进化路径,助力运维团队从被动响应迈向主动洞察。
要点总结:
- 统一平台替代工具孤岛:OpManager Nexus 将网络监控、服务器监控、硬件监控、配置管理、流量分析整合到一个控制台,消除多工具切换的成本。
- 智能运维降低人工负担:Zia AI 自适应阈值学习 14 天数据、每小时更新基线,支持 3,000+ 指标自动阈值管理,从根本上减少误报和漏报。
- 网络可视化让故障定位更快:自动生成 Layer 2 拓扑、业务视图、3D 机房视图,帮助运维人员在故障发生时快速定位问题设备在网络中的位置。
- 硬件监控覆盖主流厂商:Dell、HP、IBM、Cisco、华为、联想、H3C 等设备的温度、风扇、电源、电池状态统一监控。
- 分布式架构支持多站点:探针-中心架构让企业从单一控制台管理多个数据中心网络资源。
- 从设备监控升级为网络健康管理:不再只回答“设备是否在线”,而是回答“整个网络处于什么状态,风险在哪里”。
网络监控的“盲区”在哪里
传统网络监控依赖 SNMP 以分钟级间隔轮询设备。对于大多数日常场景,这套机制运行良好。但它有一个固有的盲区:亚秒级的瞬态事件。网络微突发、接口瞬时拥塞、BGP 短暂抖动——这些事件在两次轮询之间发生又消失,不触发任何告警,但正在缓慢侵蚀网络健康。
问题不在于监控工具不够多,而在于监控的粒度和维度不够。当网络、服务器、应用各自使用独立工具时,跨层关联分析几乎不可能。
痛点:为什么“设备都正常”不等于“网络健康”
01 监控工具孤岛,数据不互通
网络监控用一套工具,流量分析用另一套,配置管理又是第三套。故障排查时需要在多个界面之间切换,时间浪费在“找数据”而非“解决问题”上。
02 传统轮询无法捕捉瞬态事件
分钟级SNMP轮询会漏掉亚秒级的网络微突发。等到下一次轮询发现问题时,流量峰值早已消失,根因无从追溯。
03 缺乏从设备到业务的统一视图
交换机端口状态、服务器CPU、应用响应时间——这些数据分属不同系统,很难回答一个基本问题:“这个业务系统现在到底健不健康?”
解决方案:OpManager Nexus 统一网络监控与智能运维平台
OpManager Nexus是ManageEngine的新一代网络监控与管理平台。它的核心定位是一个“汇聚点”:将网络监控、服务器管理、硬件监控、配置管理、流量分析、应用性能管理等能力整合到统一控制台中。
一个平台,覆盖从设备到业务的全栈可见性。
第一层:智能网络监控 ——看见以前看不见的问题
OpManager Nexus支持超过110,000种设备类型和2,000多项性能指标,预置10,000+设备模板,覆盖Cisco、Juniper、Arista、Huawei、ZTE等主流厂商的交换机、路由器、防火墙、负载均衡器。任何具有有效IP地址的设备都可以被监控。
网络发现与自动发现
系统能够快速发现网络中的数千台设备,自动分类并配置相应的性能监控器。发现规则可以智能关联监控项,将新设备自动纳入正确的业务视图。
网络可视化
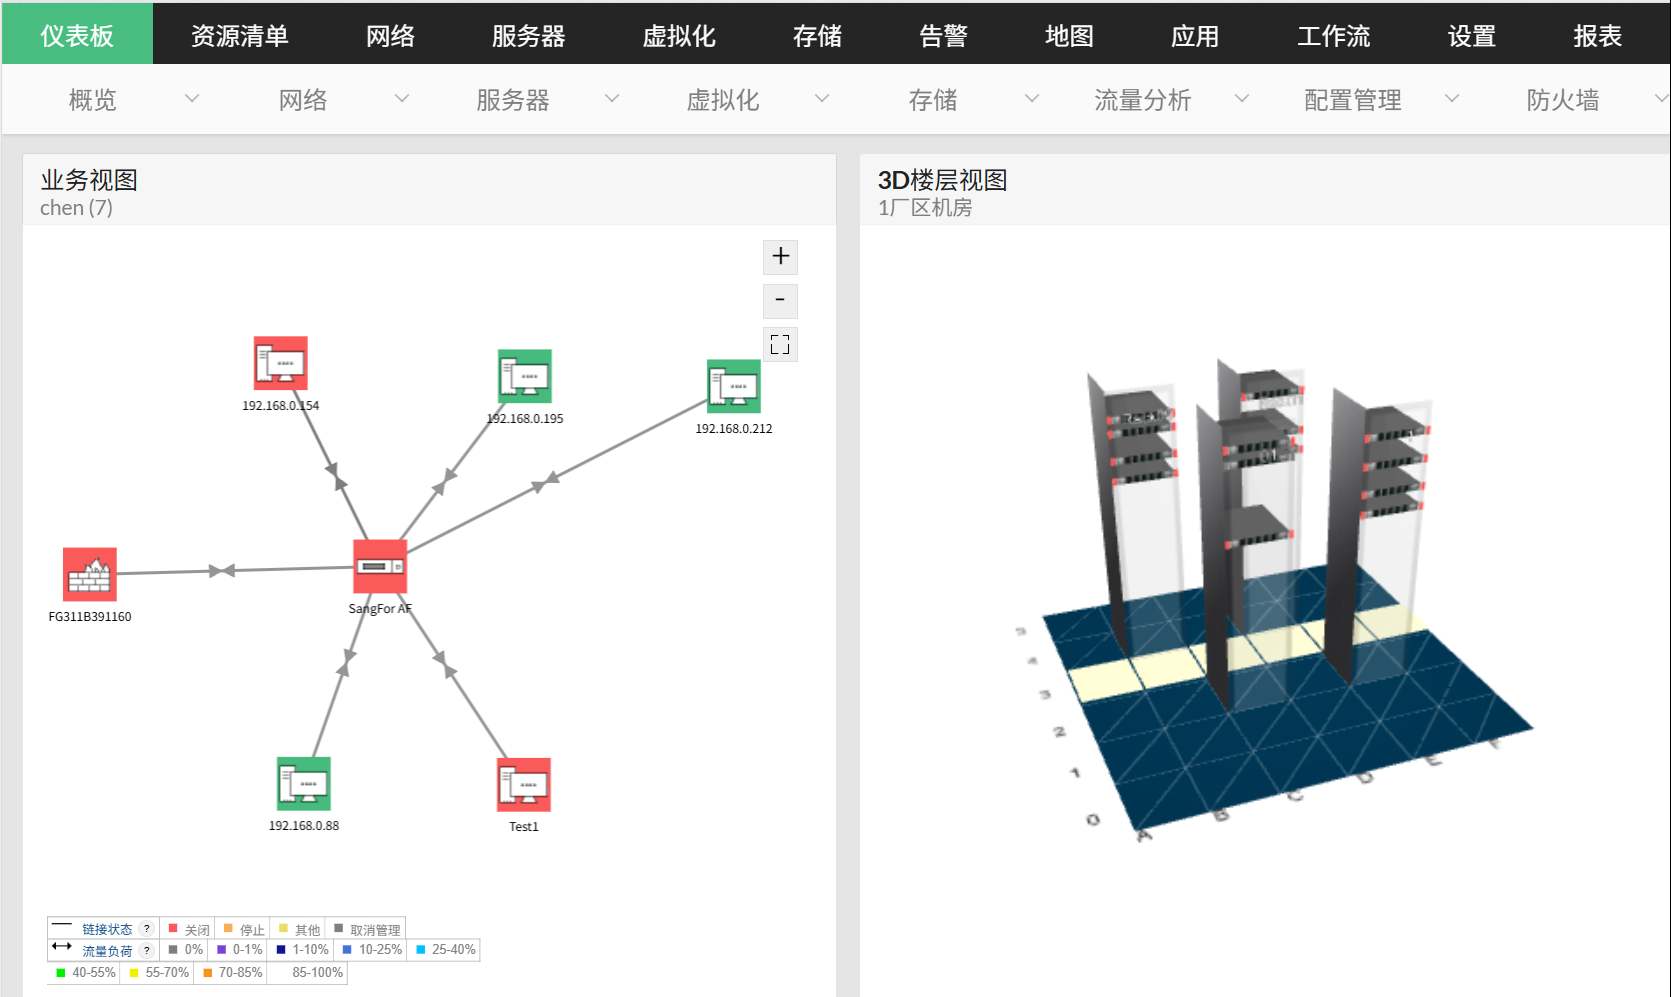
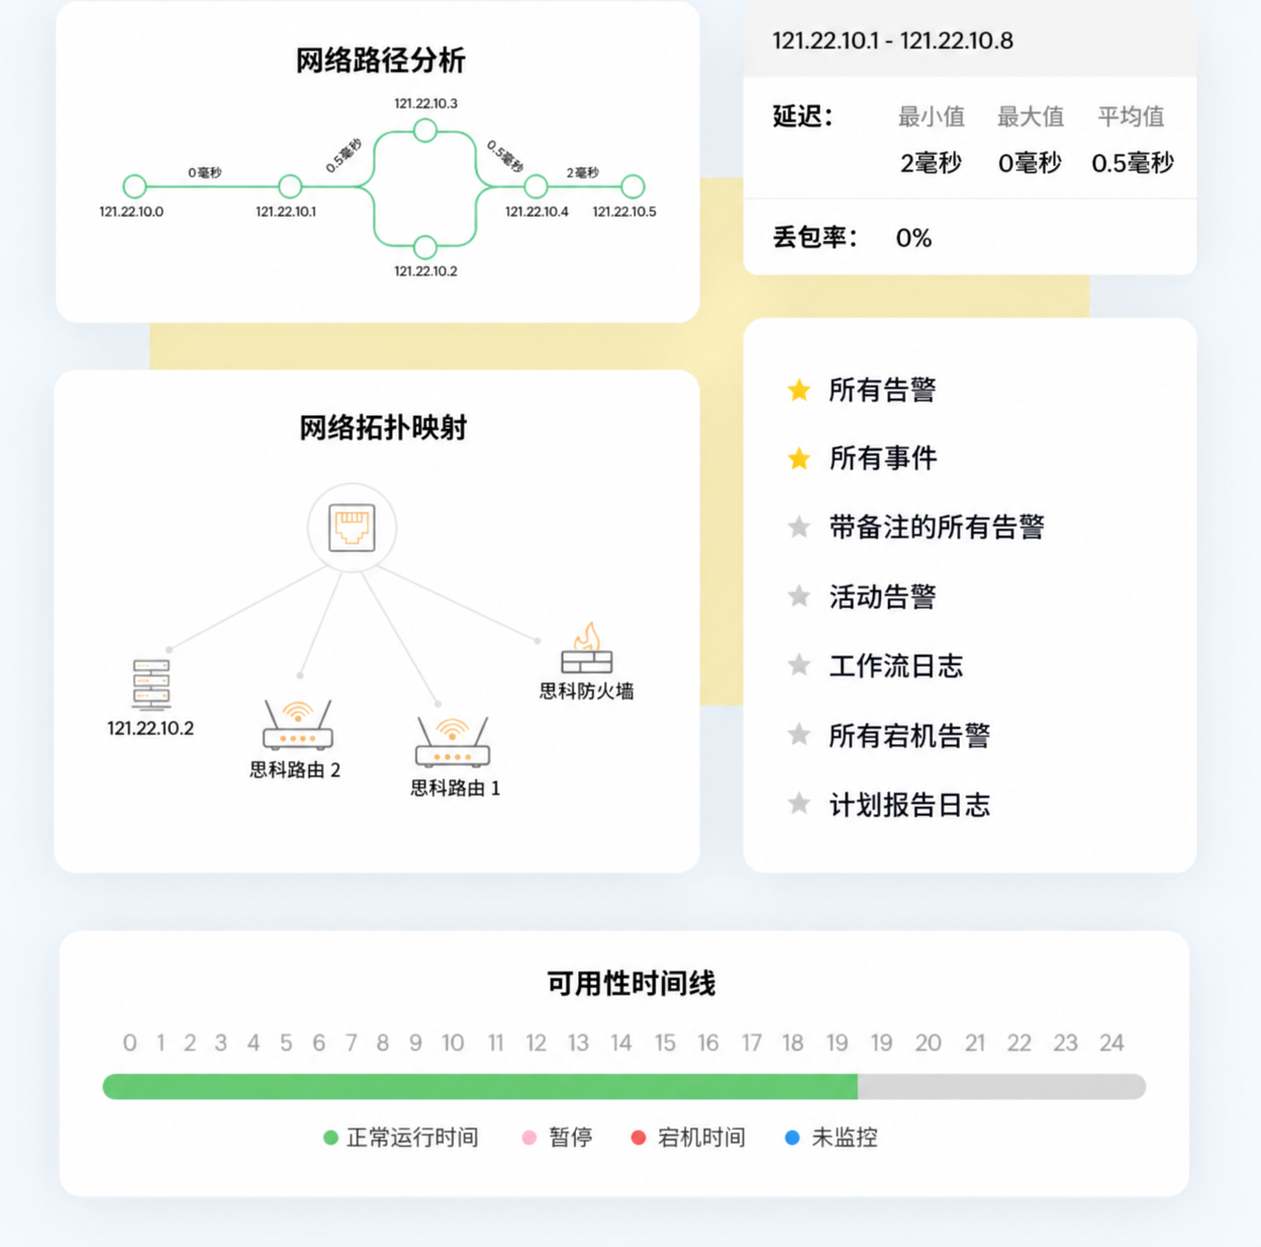
自动生成Layer 2拓扑图,利用CDP、LLDP、IPROUTE、FDB和ARP技术清晰呈现设备连接关系。支持业务视图、3D机房视图、虚拟机映射等多种可视化方式,帮助运维人员快速定位故障设备在网络中的位置。
路由器监控与无线监控
支持Cisco IPSLA技术,实时监控WAN链路的可用性、延迟和性能。无线控制器监控覆盖Cisco WLC及其关联的SSID和AP,帮助掌握无线网络的整体性能。
第二层:智能运维——AI驱动的主动管理
自适应阈值
传统静态阈值面临一个两难:设得太低,高峰期误报洪水;设得太高,低谷期真实问题被漏掉。OpManager Nexus的自适应阈值功能利用Zia AI学习网络数据14天,为每个性能指标建立动态基线,每小时重新计算一次。
这意味着系统能够识别“凌晨3点CPU从 10% 跳到 25%”这样的异常——即便 25% 在白天完全正常。自适应阈值支持超过3,000个性能指标,可一键应用于数千台设备,消除手动配置阈值的管理负担。
Zia聊天机器人
OpManager Nexus内置由Zia驱动的聊天机器人,支持通过自然语言查询设备健康状态、查看最新告警、执行Ping/Traceroute、抑制告警等操作。无需在多个仪表板之间翻查,一个提示即可获取实时洞察。
Zia Agents与自动化工作流
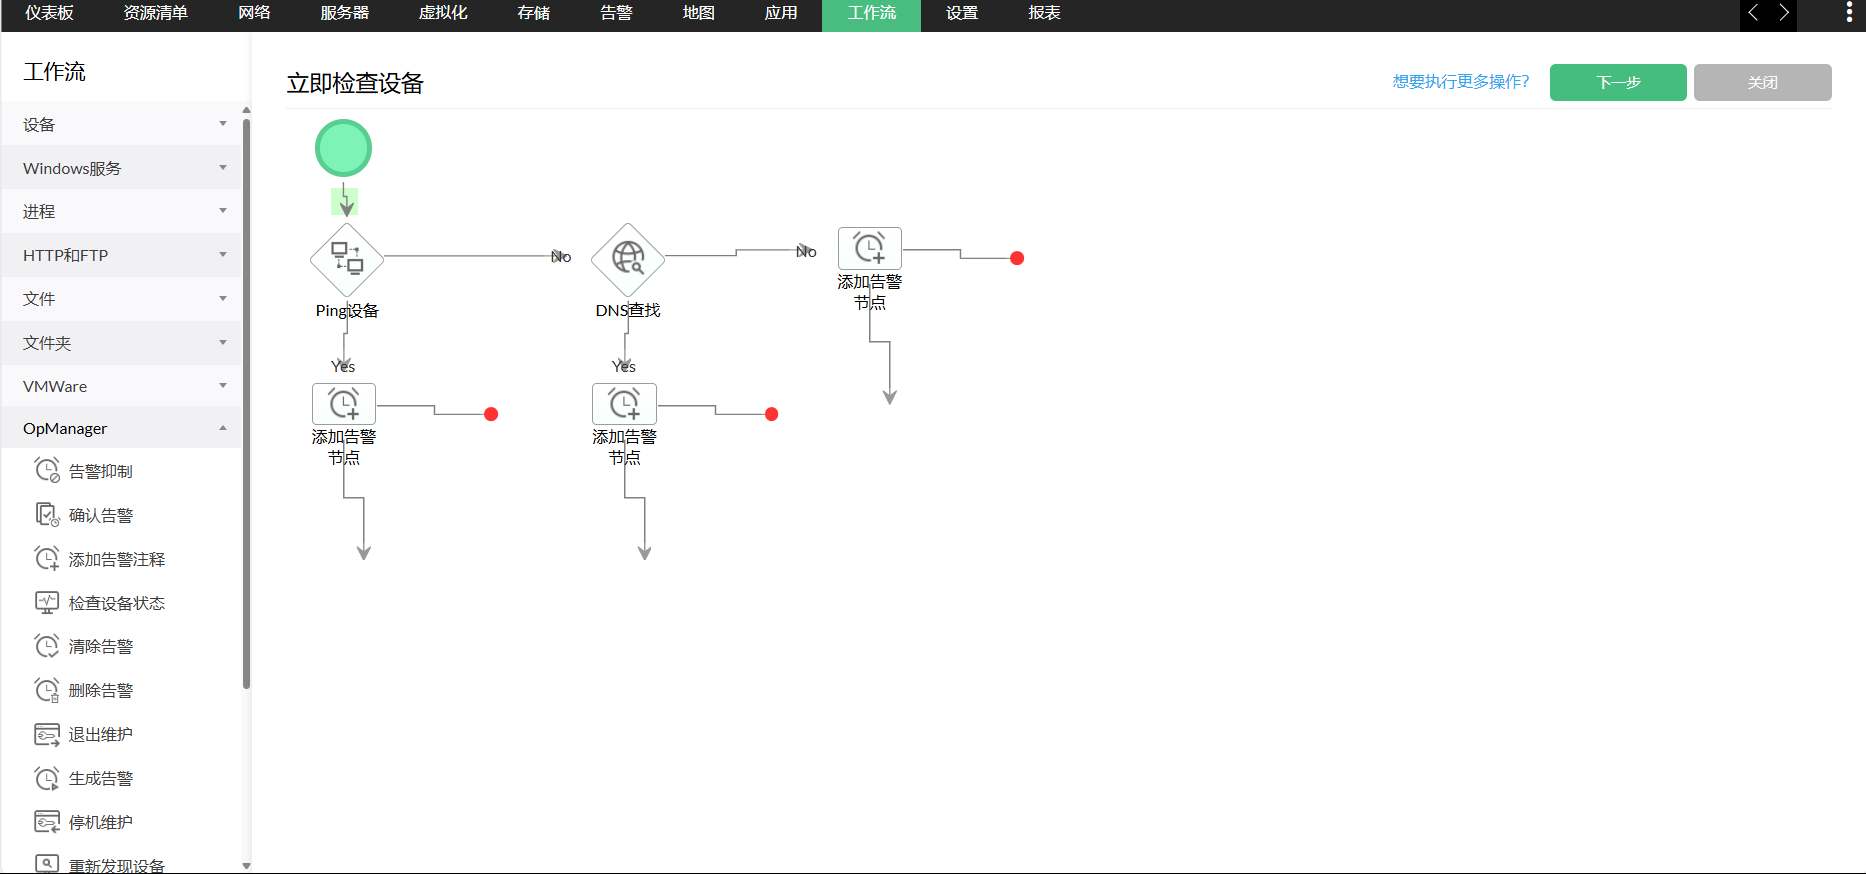
当告警触发时,Zia Agents可以自动介入,推荐或执行修复动作。支持设置护栏(guardrails)要求人工审批,也可在无护栏时自主执行。工作流构建器支持无代码拖拽式操作,实现多步骤修复流程的自动化执行。
智能事件关联
将分散的告警聚合为结构化事件,附带网络、基础设施、应用层的深度影响上下文。利用历史告警数据识别重复序列,自动分组为有意义的问题。
第三层:系统监控与服务器监控
服务器监控
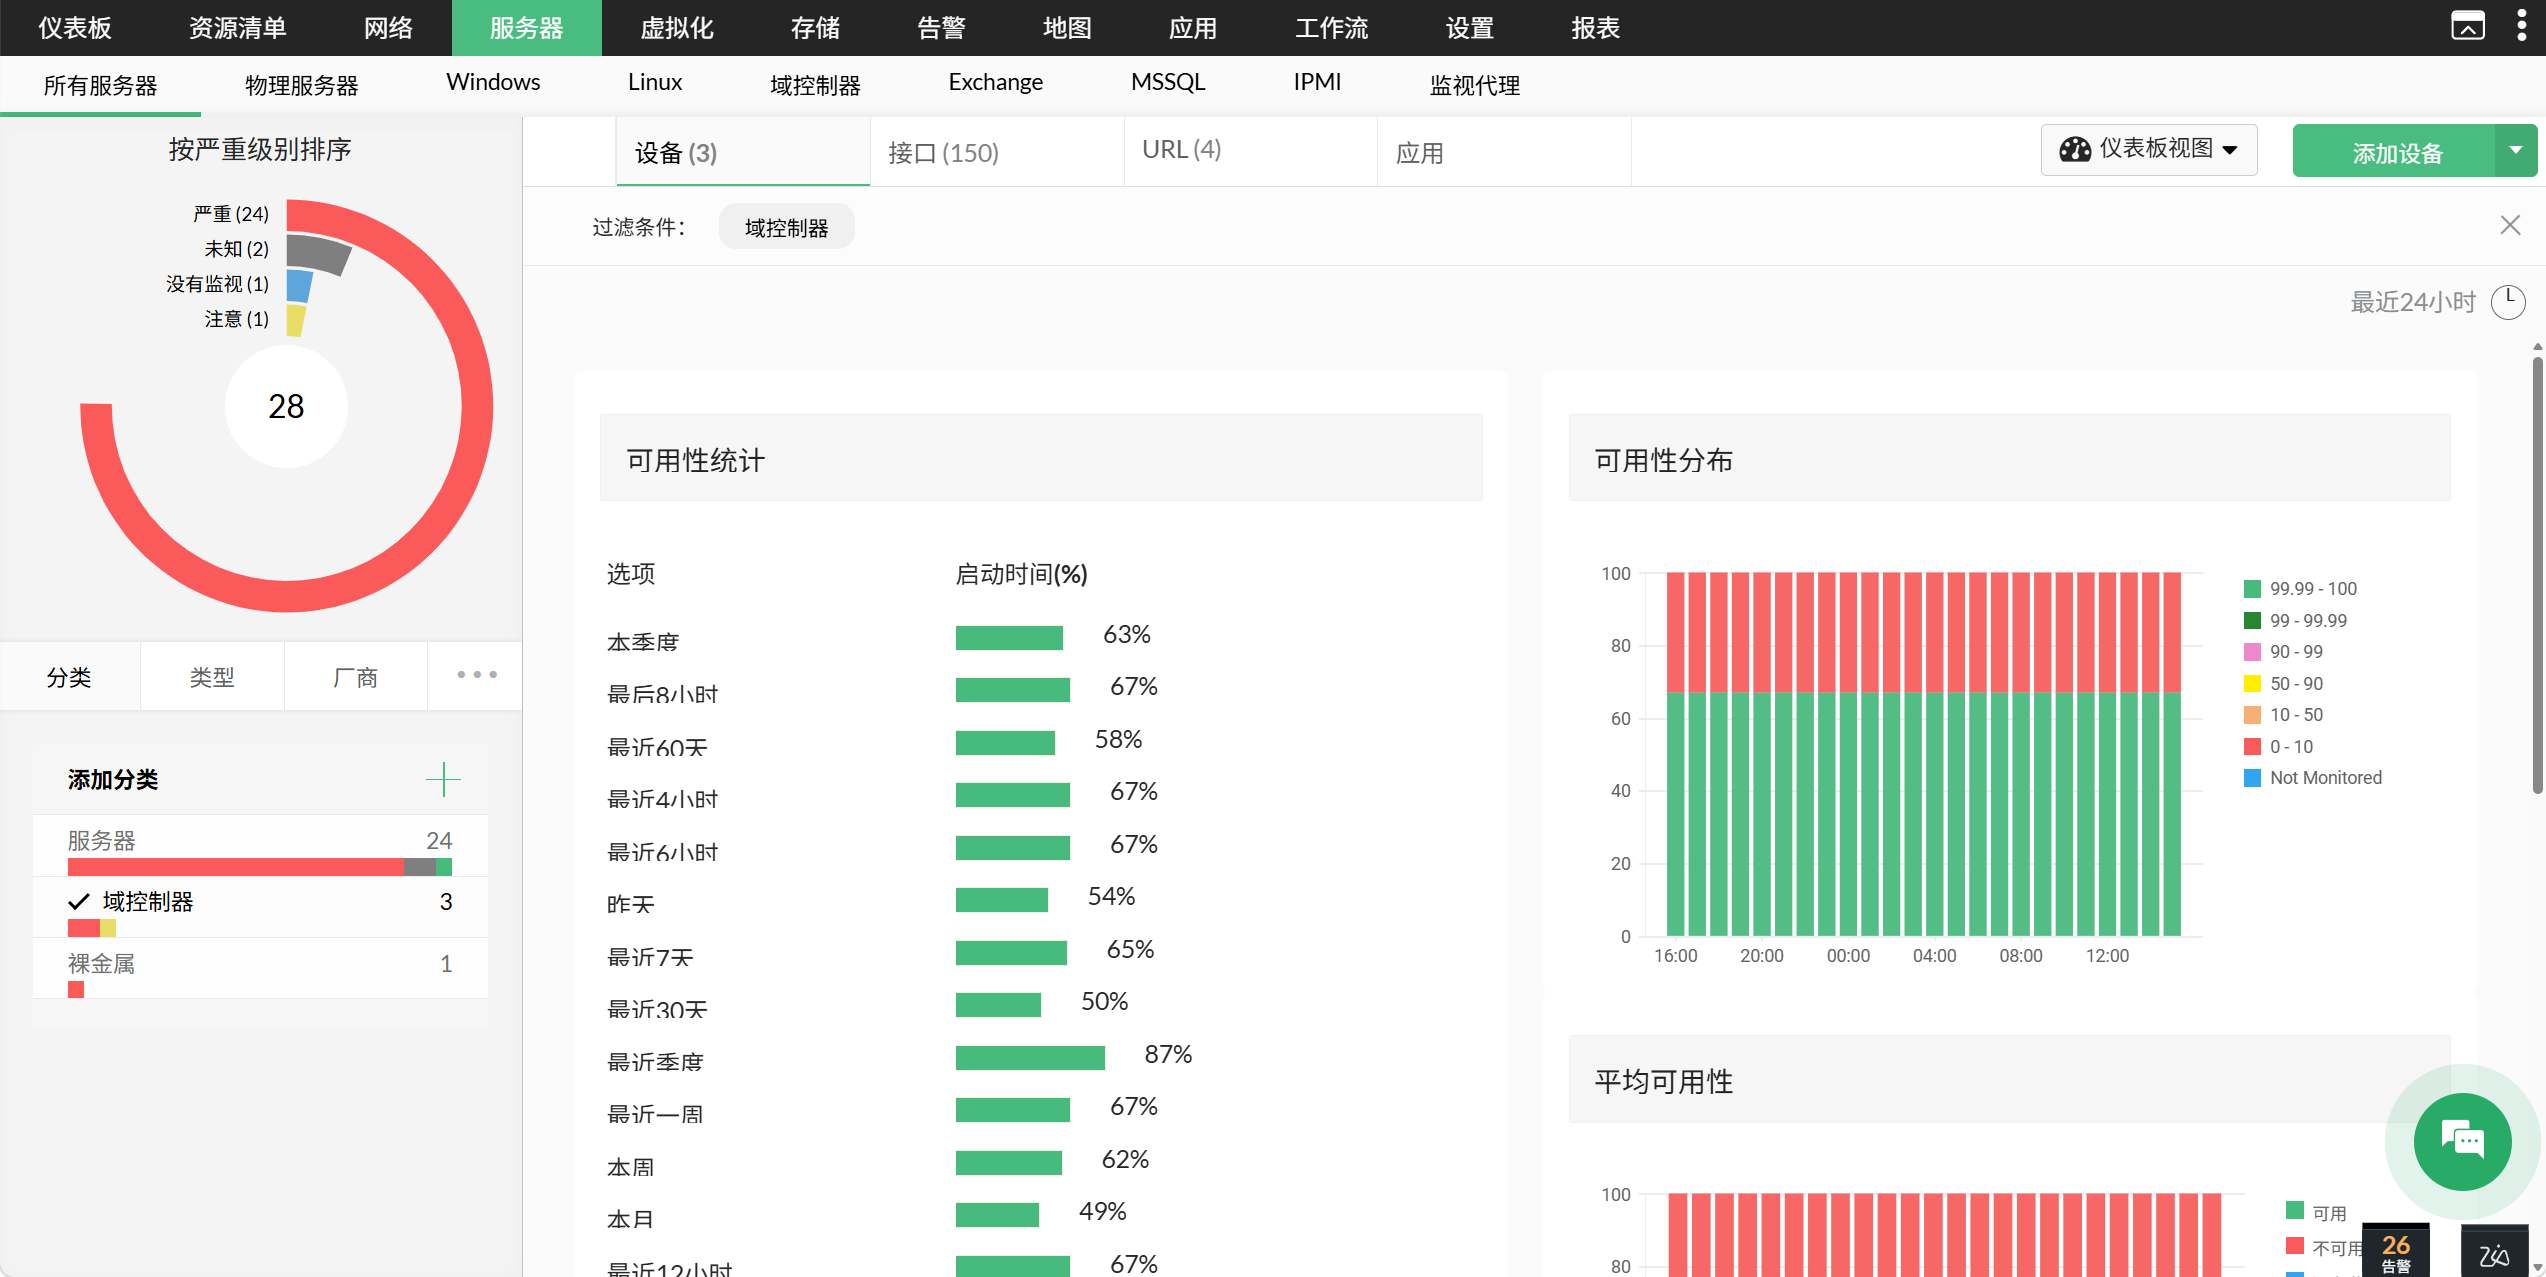
OpManager Nexus 支持物理服务器和虚拟服务器的统一监控。物理服务器覆盖Windows、Linux、Unix、Solaris 等操作系统。虚拟化环境支持 VMware(70+ 深度指标)、Hyper-V、Xen、Nutanix。
系统监控核心指标
监控CPU、内存、磁盘、进程、服务、事件等关键性能数据,帮助运维人员了解服务器资源使用情况,识别哪些进程消耗了最多资源,为硬件升级决策提供依据。
硬件监控
硬件监控工具如同设备的“数字助手”,从嵌入式传感器收集电源、电池、风扇、温度、时钟速度等数据。OpManager Nexus 的硬件监控覆盖Dell、HP、IBM、SuperMicro、Juniper、Cisco、华为、联想、H3C等主流厂商。
监控指标包括:温度、风扇速度、电源电压和电流、电池状态、磁盘阵列等。当硬件出现异常时,通过邮件、短信或声音通知即时告警。
第四层:数据中心监控与存储管理
数据中心监控
支持通过3D机房模型呈现数据中心布局全景,动态展现设施和动力环境的运行状态。多层楼、机架视图、温度热力图等功能帮助运维团队直观掌握数据中心健康。
存储监控
监控RAID控制器容量、性能和配置,磁带库状态,存储容量预测。系统可以准确指出设备存储何时将达到分配存储的 80%、90% 和 100%,帮助规划采购决策。
分布式监控架构
对于拥有多个数据中心的企业,OpManager Nexus采用探针-中心(Probe-Central)架构,允许从单一控制台监控分布式网络资源。中心服务器提供对所有站点的完整可见性,探针提供精确的本地指标。
第五层:网络配置管理与可用性监控
网络配置管理
支持批量配置海量设备,自动备份配置文件,实时跟踪配置变更,快速恢复正常配置。避免由错误配置引起的网络故障,防止未授权的配置变更。
可用性监控
24/7全天候监控网络设备和服务器的可用性。当设备无响应时立即告警,支持多级告警升级机制,确保关键问题不会被忽略。
故障管理与根因分析
提供集中式的故障管理控制台,关联原始网络事件,过滤非相关事件,仅显示关键告警。集成Ping、Traceroute、MIB Browser、交换机端口映射器等工具,帮助快速定位根因。
总结:网络监控的终点,是网络健康管理
回到开头的问题:网络监控工具的价值,究竟应该用什么衡量?
不是监控了多少台设备,也不是采集了多少个指标,而是——当问题还没有演变成故障时,你是否已经看见了它。
OpManager Nexus的答案是把监控从“被动响应”推向“主动洞察”:
- 看得更细:自适应阈值学习14天基线、每小时更新,捕捉静态阈值无法发现的细微异常;
- 看得更全:网络、服务器、硬件、配置、流量统一在一个平台,跨层关联不再是难题;
- 看得更早:Zia AI预测趋势、识别异常,在风险累积阶段就发出信号;
- 管得更少:Zia Agents自动执行修复动作,工作流引擎替代重复性人工操作。
从网络设备监控到智能运维,从系统监控到数据中心监控,OpManager Nexus覆盖的不只是设备列表,而是一张持续更新的网络健康地图。当运维团队不再疲于“哪里告警查哪里”,而是能够回答“整个网络处于什么状态、风险在哪里、下一步该做什么”——网络监控才真正完成了向智能运维的进化。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问题(FAQs)
- OpManager Nexus 支持哪些网络设备厂商?
答:支持超过110,000种设备类型,预置10,000+设备模板,覆盖Cisco、Juniper、Arista、Huawei、ZTE、H3C、Dell、HP、IBM等主流厂商的交换机、路由器、防火墙、负载均衡器、无线控制器等设备。
- 自适应阈值和传统静态阈值有什么区别?
答:传统静态阈值需要手动设置固定数值,容易在高峰期误报或在低谷期漏报。自适应阈值利用Zia AI学习14天数据,为每个指标建立动态基线,每小时自动更新。它能识别“凌晨3点CPU从 10% 跳到 25%”这样的异常,即便 25% 在白天完全正常。
- Zia 聊天机器人能做什么?
答:Zia 聊天机器人支持通过自然语言查询设备健康状态、查看最新告警、执行Ping/Traceroute、抑制告警等操作。运维人员无需在多个仪表板之间翻查,一个提示即可获取实时洞察。
- OpManager Nexus 如何监控分布式多站点网络?
答:采用探针-中心(Probe-Central)架构。中心服务器提供对所有站点的完整可见性,探针部署在各站点提供精确的本地指标采集。适合拥有多个数据中心或分支机构的分布式企业。
- 硬件监控覆盖哪些指标?
答:覆盖温度、风扇速度、电源电压和电流、电池状态、磁盘阵列等。支持Dell、HP、IBM、SuperMicro、Juniper、Cisco、华为、联想、H3C等主流厂商的服务器和网络设备。
扩展阅读:
- AIOps 2.0 白皮书——适用于当今 IT 堆栈的智能扩展
- 什么是智能运维?一文带你看懂 AIOps 的底层逻辑 - ManageEngine Article Blogs
- OpManager 如何用机器学习实现异常检测与根因推荐?
- 智慧运维落地路径:从存储管理到网络管理软件的一体化演进