服务器监控系统怎么搭建?从零部署到自适应阈值配置全流程

AI 摘要
服务器监控系统搭建,难的不是装软件,而是数据收不全、告警太吵、阈值不会设。本文按真实团队落地顺序,从监控对象盘点、选型部署、自动发现,到告警降噪四层做法、自适应阈值“先学后告”配置,再到告警准确率、定位速度、扩容顺畅度三项验收标准,讲清每一步怎么做、怎么验收,帮助运维团队少走弯路,真正搭出一套能用、好用、长期用的服务器监控系统。
先看全局:服务器监控系统到底怎么落地
服务器监控系统搭建,难的不是装软件,而是三件事:数据收不全、告警太吵、阈值不会设。很多团队一上来就装工具、加服务器、设几个告警,结果不是漏报,就是半夜被几百条重复通知吵醒,最后干脆关掉通知。这也是为什么像OpManager Nexus这类一体化平台,会把网络发现、告警降噪和自适应阈值做成内置能力——少一点手工拼装,多一点开箱即用。
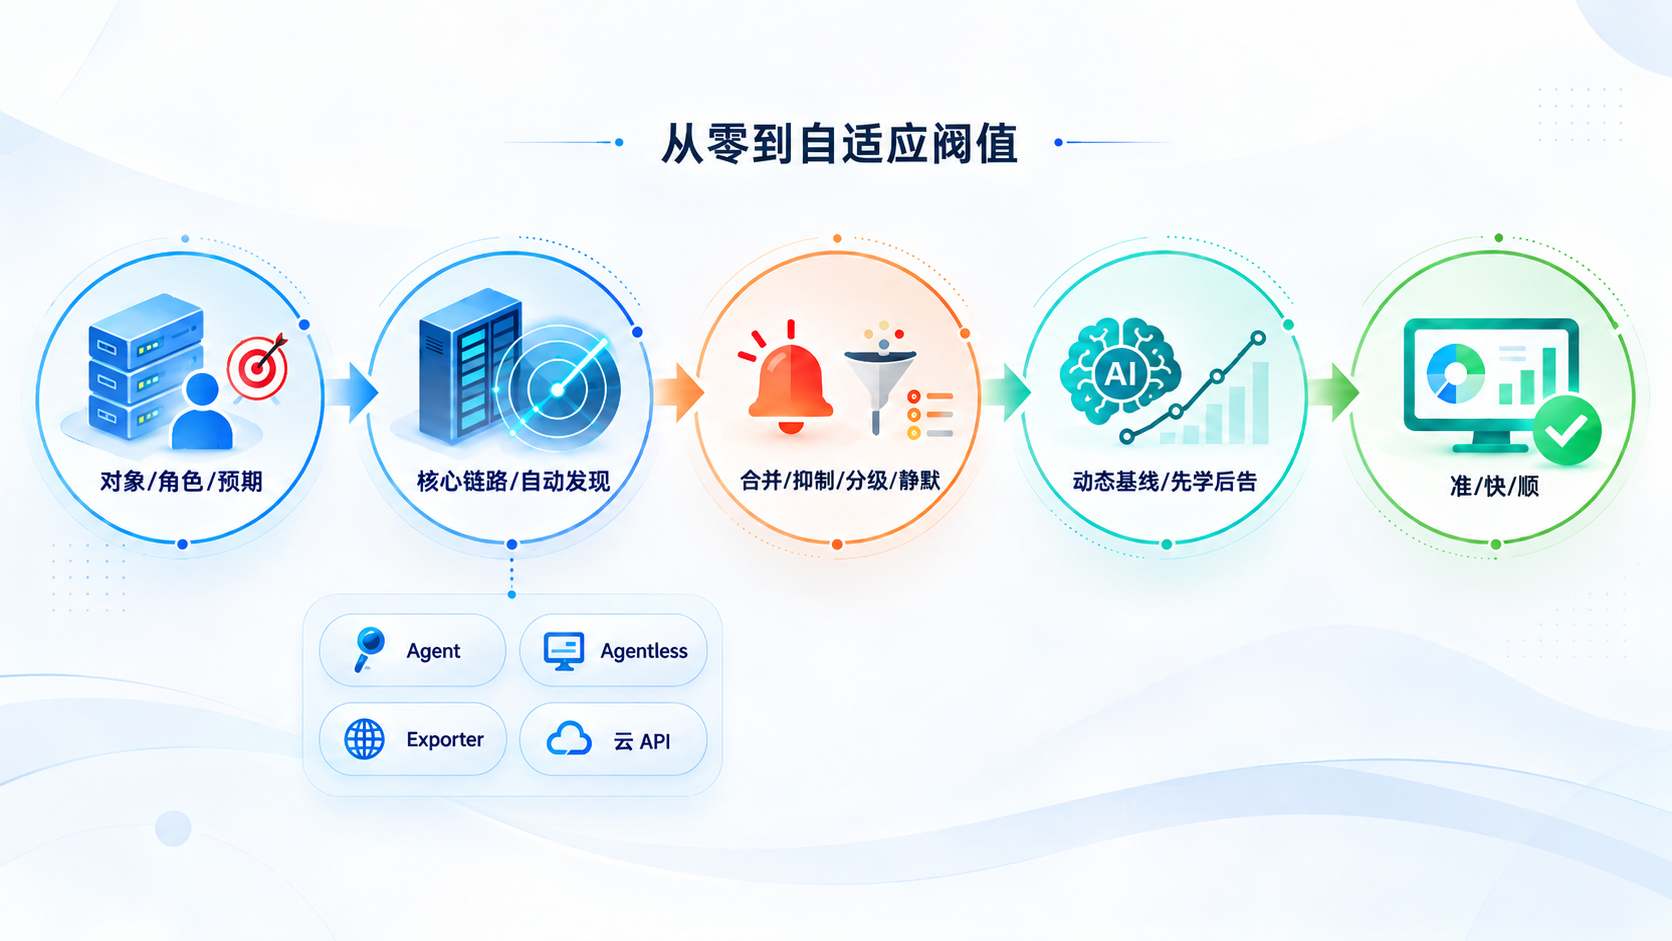
本文按真实团队落地顺序走:先盘监控对象、角色和预期;再选底座、纳管核心链路、自动发现;然后用合并关联、抑制联动、分级通知、静默窗口降噪;阈值交给AI动态基线,先观察再生效;最后用告警准确率、定位速度、扩容顺畅度验收。读完你能照着做,也能判断一套服务器监控系统能不能长期用。
一、动手之前,先想清楚三件事
第一,你要管的是一批服务器,不是一台。物理机、虚拟机、云主机、容器常混在一起。监控只能管物理机,碰到容器就抓瞎,从第一天就是残缺的。选工具前先盘清楚:纳管对象有几类、各多少台、跑在什么环境。
第二,想清楚监控给谁看。值班要“哪里出问题、影响多大”;容量规划要“趋势怎么走”;管理者要一张能说明问题的报表。主要服务谁,后面配告警和报表才不白做。
第三,监控不解决问题,只负责更快发现问题。工具能把故障定位从小时级压到分钟级,排查修复还得靠人和流程。预期摆正,后续推进才顺。
二、部署:先跑起来,再谈精细
搭建监控系统最忌讳一上来就追求“全覆盖、全自动”。正确做法是小范围跑通,再逐步扩展。
选一个能开箱即用的底座
监控系统的核心是三层:采集器 + 存储 + 展示。开源方案比如Zabbix、Prometheus + Grafana灵活度高,但需要你自己拼装、自己升级、自己兜底。一体化商业平台把这些打包好了,装完就能看到数据。
判断标准其实就一条:你的团队有没有专职的人愿意长期维护这套东西。没有的话,优先选开箱即用的。以OpManager Nexus为例,它把自动发现、告警降噪、自适应阈值做成了内置能力,而不是让你拿脚本和插件一点点去攒。
先纳管核心链路,别贪多
不要一上来就把几百台服务器全塞进去。先挑出最不能出问题的几台——数据库、核心应用、支付或交易链路——把它们加进来,配好基础指标:CPU、内存、磁盘、网络、进程。这一周的目标不是“监控全覆盖”,而是验证这套系统在你的环境里跑得稳不稳。
用自动发现代替手工登记
服务器一多,手工一台台录入必然漏、必然错。让系统按网段自动扫描识别,把资产清单交给系统维护,你只负责确认。OpManager Nexus支持按IP段和网段自动发现服务器,扫描到的新机器会自动纳入资产库并开始采集指标。这一步做扎实,后面扩容、审计、故障定位都会省大量力气。
别忘了数据采集本身
数据收不全,问题往往出在采集层。采集方式按要不要装Agent分四类:
- Agent:服务器上装探针,适合Linux、Windows、数据库、中间件,能拿进程、端口、应用指标。
- Agentless:通过SNMP监控、WMI、WinRM、SSH远程采集,适合网络设备监控和不能装Agent的环境。
- Exporter:暴露HTTP指标端点,Prometheus生态常用,适合K8s、中间件、数据库。
- 云平台API:调云厂商接口,采集云主机、负载均衡、数据库、对象存储状态,通常和Agent搭配。
怎么选看环境:网络设备走SNMP工具;Linux用Agent或SSH;Windows用WMI或WinRM;物理服务器可走IPMI、Redfish;容器和K8s靠cAdvisor、node-exporter、kube-state-metrics;云主机建议Agent + 云API。采集频率、存储管理周期、凭据加密、防火墙放行、时间同步,部署阶段就要确认。
三、告警降噪:服务器监控系统能不能用,就看这一步
一套监控系统最容易被团队放弃的时刻,是告警风暴。凌晨三点,一次数据库抖动刷出几百条重复告警,值班的人关掉通知的那一刻,这套系统就已经名存实亡了。
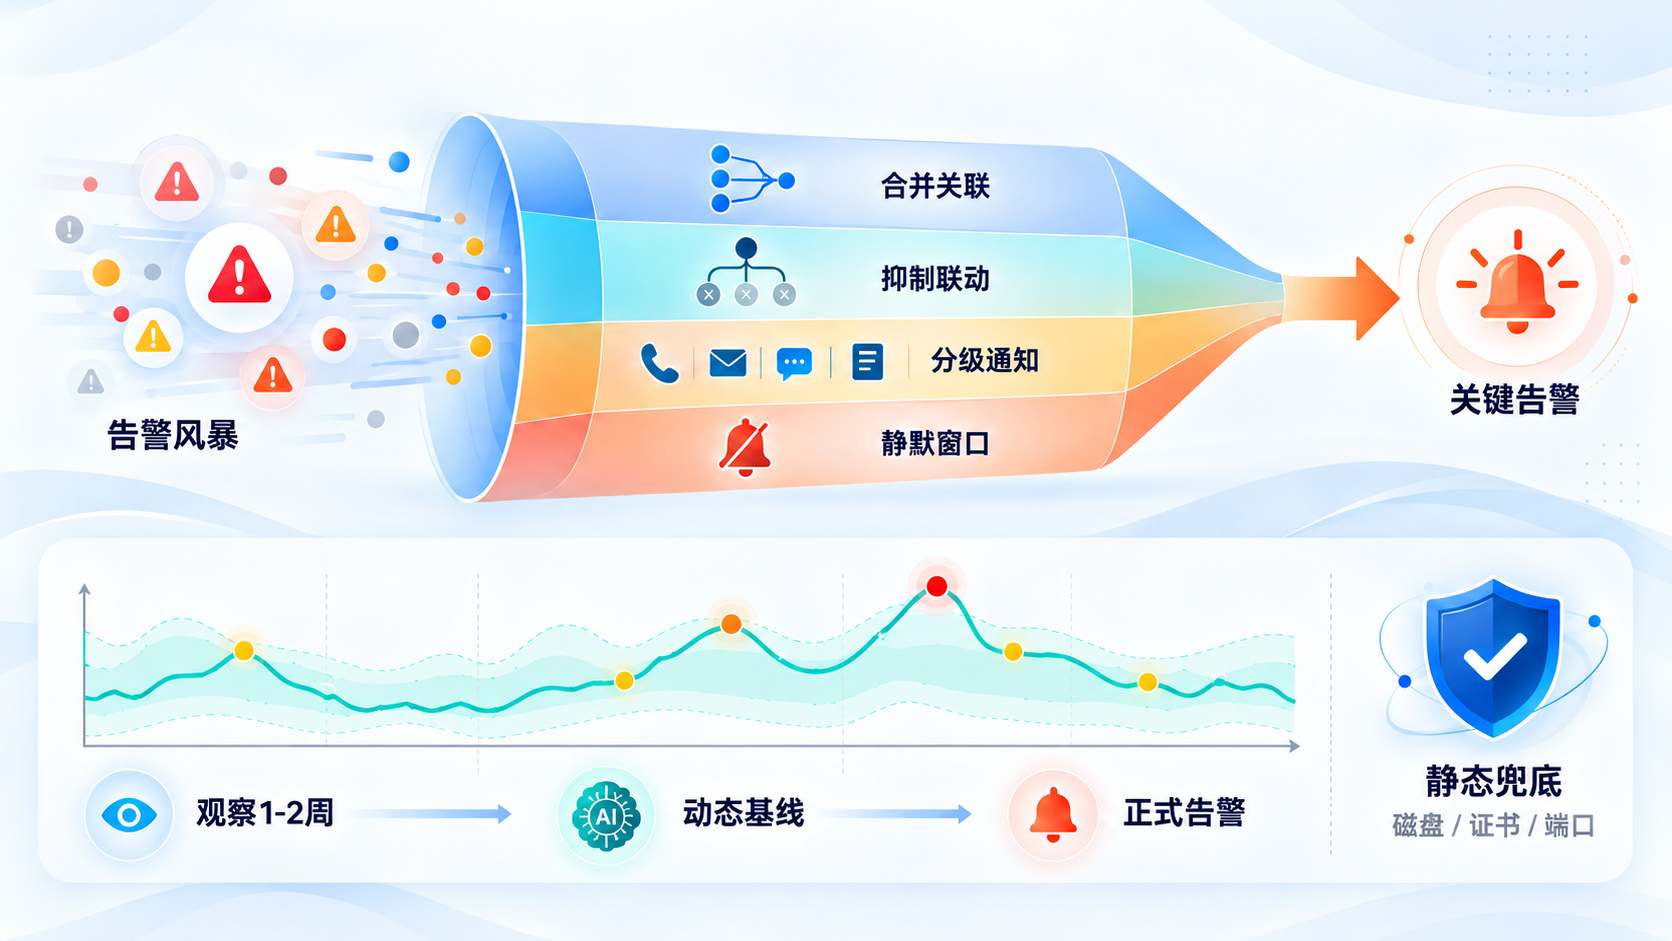
告警降噪是服务器监控系统能否长期运转的生命线。四层做法:
- 合并关联:同一故障多条告警归并成一条,别让CPU、内存、磁盘各叫各的。
- 抑制联动:服务挂了,下游报错只报根因。数据库IO飙升导致依赖服务超时,就合并为一条根因告警。
- 分级通知:P0业务中断走电话+短信,P1走短信+IM,P2工作时间发IM,P3进工单。
- 静默窗口:维护期和已知问题自动静默。
这些事全靠人工写规则,会越堆越难维护。所以越来越多团队转向自适应阈值。OpManager Nexus内置的AI降噪和根本原因分析能力,会把告警合并、抑制和基线学习做在后台。
四、自适应阈值:把人工调参这件事交给系统
传统服务器监控最头疼的是阈值怎么设。设高了漏报,设低了误报,白天和凌晨基线不同,固定阈值两头不讨好。
自适应阈值把“指标正常长什么样”交给系统学。它观察每台服务器走势,学习“工作日白天CPU区间、周末凌晨区间”的动态基线,明显偏离才告警。判断的不是“超过 90% 就报警”,而是“这台机器跟自己正常时比,异常了”。这也让CPU监控、硬件监控从死阈值走向动态基线。
以OpManager Nexus的自适应阈值功能为例,它会持续学习被监控系统的性能数据,为每个指标建立动态基线,并定期重新计算,确保基线始终贴合实际运行状态。你还可以设置不同的偏差级别,让系统在基线之上叠加不同程度的偏离来触发不同级别的告警。
关键步骤:先静默观察,再正式生效。先跑到一两周,只学习、只记录“如果异常会怎么告”,不打扰值班。人工对照真实情况,确认不漏真故障、不把正常波动当异常,再切正式告警。这个“先学后告”的过渡期,决定团队是信任还是抵触。OpManager Nexus让自适应阈值先以观察模式运行,学习基线后再接管告警,正好契合这条路径。
注意:自适应阈值不是万能的。磁盘满、证书过期、端口不可用这类确定性指标,仍要静态阈值兜底。AI管“正常值本身在变”的场景,两者搭配才正确。
五、验收:怎么知道这套服务器监控系统搭好了
搭完不等于搭好。判断一套服务器监控系统是否合格,不看功能列表有多长,看三个能落到数字上的结果:
告警准不准。一天下来,多少告警是真问题、多少是噪音。行业标准里,B级数据中心的告警准确率要求大于 99%,C级也要大于 98%。噪音占比高,说明降噪没做好。
定位快不快。真出一次故障,从告警到定位根因花了多久。监控系统能决定的是发现时长和定界时长,这两项加在一起占MTTR的一半左右。如果还是靠人逐台排查,说明系统没发挥作用。
扩容顺不顺。加一台新服务器,是不是自动发现、自动纳管、自动进入监控。如果每加一台都要手工配半天,说明底座没搭好。
总结
服务器监控系统的搭建,本质不是一次技术安装,而是一次习惯的改变:从“出事了再去查”变成“异常提前看到”,从“手工设阈值”变成“系统自己学”。起点可以很小,先把核心链路跑起来、把告警降噪做扎实、把自适应阈值用对,这套系统就能真正变成团队可以依赖的东西,而不是又一个被关掉通知的工具。
选型的时候,建议别只看功能截图。直接申请试用,在真实环境里跑两周,重点验证上面说的三件事:数据收得全不全、告警吵不吵、阈值好不好设。OpManager Nexus提供免费试用,你可以拿这套路径去测它。在真实环境里验证出来的答案,比任何参数表都可信。
还想再确认几件事?
按您现在最关心的那一项继续。
常见问答(FAQs)
- 开源自建和商业监控平台怎么选?
答:看团队有没有人长期维护。Zabbix、Prometheus + Grafana 灵活,但拼装、升级、兜底都得自己来。没有专职人手,优先选开箱即用的一体化平台。比如OpManager Nexus,把自动发现、告警降噪、自适应阈值做成内置能力,省去拿脚本和插件一点点攒的时间。选型别只看功能截图,直接试用,在真实环境里跑两周更靠谱。
- 告警风暴怎么解决?
答:四层做法:合并关联、抑制联动、分级通知、静默窗口。同一故障引发的多条告警归并成一条;下游依赖报错只报根因;P0业务中断走电话加短信,P1严重降级走短信加IM,P2工作时间发IM,P3记录进工单、不主动通知;维护期和已知问题自动静默。四层叠加下来,告警量通常能降 60% 到 80%,关键信息一条不丢。
- 自适应阈值和传统阈值有什么区别?
答:传统阈值是固定值,比如CPU超过 90% 就报警,白天和凌晨一个标准,容易漏报或误报。自适应阈值是动态基线,系统学习每台机器自己的正常区间,偏离基线才告警。但磁盘满、证书过期、端口不可用这类确定性指标,仍然需要静态阈值兜底。两者搭配用,才更稳妥。
- 服务器监控系统搭好后怎么验收?
答:看三个数字:告警准不准,一天下来多少告警是真问题、多少是噪音;定位快不快,从告警到定位根因花了多久;扩容顺不顺,新服务器能不能自动发现、自动纳管、自动进入监控。前两个最关键,直接对应告警降噪和自适应阈值有没有真正落地。
- 服务器监控需要监控哪些指标?
答:基础四样:CPU、内存、磁盘、网络。再加进程、端口、服务可用性、数据库连接数、中间件队列、容器状态、云资源配额。核心链路还要加业务指标,比如订单成功率、支付响应时间。指标不在多,在于能对应真实故障和业务影响。
扩展阅读