日志管理不是把日志存起来,采了不看等于没采

一句话说清:日志管理是干什么的
日志管理,就是将服务器、防火墙、数据库和业务系统产生的日志集中起来,经过解析、存储、检索和告警,帮助企业在发生故障或安全事件时,快速回答“谁、什么时候、做了什么”。
采集、解析、归档、可视化和告警,都是日志管理的组成部分。企业部署日志管理工具,不只是为了保存日志,更重要的是让这些记录在需要时查得到、看得懂、能够追溯。
“采了不看”是最常见的问题
很多企业并不缺日志,真正缺的是一套能把日志用起来的管理机制。日志分散在不同系统中,平时没人关注,出了问题又难以快速定位,容易让人误以为只要保存了日志就足够了。
典型问题主要有三种:
- 日志散在各处:系统日志保存在服务器本地,防火墙日志留在设备中,数据库日志存放在数据库目录下。发生异常时,管理员只能逐台登录排查。
- 日志格式不统一:Windows 使用事件 ID,Linux 多以文本形式记录,防火墙也有自己的字段格式。缺少统一解析,就很难跨系统查询和关联事件。
- 日志留存时间不足:本地日志可能被循环覆盖,等到发现问题时,关键时间段的记录已经丢失。
这三种情况叠加,最终就会变成:有日志,却缺少完整的调查证据。无论是等保测评、安全事件复盘,还是业务故障分析,都可能因此受到影响。
日志管理工具的作用,就是把分散的日志集中起来,统一管理和检索,减少人工翻查记录的时间。
从采集到告警:日志管理的完整链路
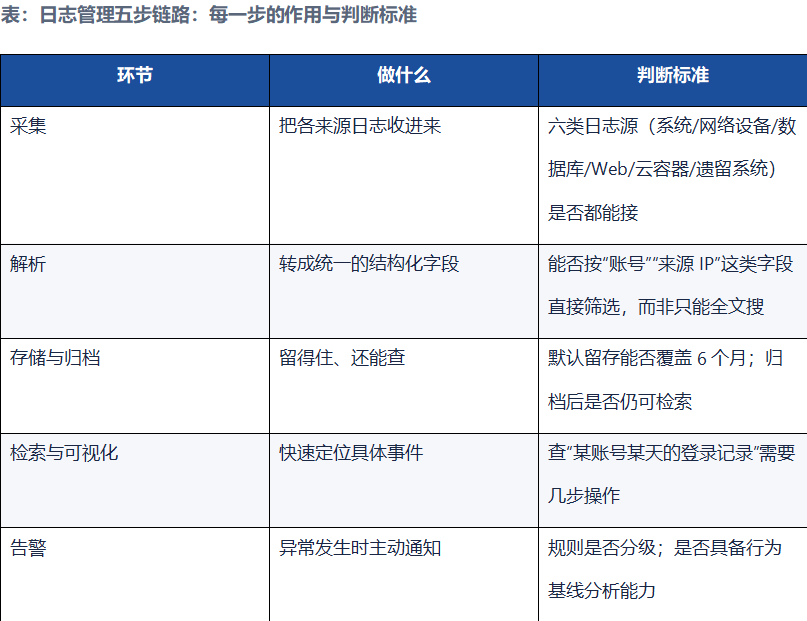
一套完整的日志管理流程通常包括五个环节,任何一个环节存在短板,都可能影响后续的查询和分析。
第一步:采集。 将不同来源的日志集中收集,覆盖操作系统、网络设备、数据库、Web 服务器和云平台等环境。部分成熟日志管理产品支持 200 种以上日志源,实际选型仍需核对具体设备的支持情况。
采集方式主要分为无代理和有代理两种。无代理方式可以通过 Syslog、WMI 等通道采集符合条件的日志,减少生产主机上的额外部署;有代理方式则通过主机端组件获取相应日志,适用于需要更细粒度采集的场景。
第二步:解析。 将格式各异的原始日志转换为结构化字段,例如时间、来源 IP、账号、事件类型和执行结果。这一步直接影响后续检索效果。判断日志管理工具的解析能力,可以尝试按账号、IP 地址等字段筛选。如果只能搜索原始文本中的关键词,就需要进一步确认其字段解析能力。
第三步:存储与归档。 日志不仅要保存,还要满足相应的留存要求,并且在需要时能够查询。对于适用网络安全等级保护相关要求的系统,应结合具体条款确认日志留存期限,相关要求涉及的日志留存期限通常不少于六个月。企业需要提前规划存储容量、自动归档和历史日志检索能力,避免归档后无法查询。
第四步:检索与可视化。 这是日志管理工具日常使用的重要环节。管理员应能够结合时间范围、账号、IP 地址和事件类型等条件快速定位记录。可视化分析则有助于发现异常趋势,例如同一账号在短时间内从多个地区登录,为后续调查提供线索。
第五步:告警。 通过预设规则、事件关联或行为基线分析,在发现异常活动时及时通知管理员。告警并不是越多越好,如果缺少分级和过滤机制,大量重复通知反而会增加运维负担。
为什么“日志管理”和“日志审计”经常被混着说
两者使用的日志数据往往相同,但关注点不同:日志管理偏向日常运维,日志审计更关注安全风险、操作追溯和合规要求。
从运维角度看,日志管理主要用于排查系统故障、分析性能异常和追踪配置变更;从安全与合规角度看,日志审计则更关注异常登录、权限变更、敏感操作,以及相关记录能否作为审计证据。
实际应用中,一套日志管理工具可以同时承担集中管理和部分审计分析工作,具体取决于产品功能及配置。
企业在选型时,建议将运维排障和安全审计需求一并梳理,避免只解决日志查询问题,却忽略审计追溯和合规报表需求。
一个场景:三小时的排查,差在哪里?
某企业的 IT 管理员曾遇到业务系统运行缓慢的问题。检查应用服务器日志后,发现数据库连接超时;登录数据库服务器查看慢查询日志,又定位到一条异常 SQL。但由于缺少关联记录,管理员无法确认执行账号,只能返回应用日志继续查找,而相关记录已经被循环覆盖。
三个小时过去,管理员只确认存在异常 SQL,却无法完整还原操作过程。
如果提前部署了集中式日志管理工具,并接入数据库和应用日志、完成相关字段解析,管理员就可以按时间范围和数据库来源筛选记录,进一步查看执行账号、来源 IP 和操作时间。
在日志采集完整、字段解析正确的情况下,这类排查有机会从逐台翻查变成集中检索,明显缩短定位时间。实际耗时仍取决于日志量、系统配置和事件复杂程度。
差别不在于有没有日志,而在于日志是否提前集中管理,以及能否通过结构化字段快速查询。
日志管理怎么落地?从三个步骤开始
企业不必一次性将所有系统接入日志管理平台,可以按照业务优先级逐步推进。
第一步,优先接入关键日志源。 可以从域控或核心服务器、边界防火墙和核心数据库入手。这些日志有助于排查系统故障、分析登录异常和追踪关键操作。
第二步,确认日志留存期限。 核对现有日志是否满足适用的留存要求,并根据实际日志量配置存储和自动归档。历史日志能否检索,也应纳入验证范围。
第三步,设置高价值告警。 不必一开始就启用所有规则,可以优先关注异常时间登录、连续登录失败、提权操作和关键文件变更等场景,再根据运行情况逐步调整。
按照这个顺序推进,更容易让日志管理从单纯的数据留存转向日常运维和安全分析。
ManageEngine 卓豪EventLog Analyzer可以作为日志管理工具的候选方案之一。根据产品资料,EventLog Analyzer 支持 200 多种日志源,提供有代理与无代理采集方式,并具备合规报表和日志归档等能力,可用于集中管理日志、检索分析和辅助审计。具体支持范围及日志留存配置,应结合实际版本、授权方案和部署环境确认。
常见问题(FAQs)
- 本地服务器已经会输出日志,还需要日志管理平台吗?
本地日志会轮转覆盖,分散在多台设备无法跨系统关联排查;日志平台解决集中采集、结构化解析、统一检索、归档留存与告警,适配故障排查和等保审计要求。
- 日志采集之后,解析不重要吗?
非常重要。没有结构化解析只能做全文关键词搜索,无法按账号、IP、事件类型做筛选,故障排查、审计取证效率会大打折扣。
- 日志告警是不是开的规则越多防护效果越好?
不是。规则过多容易产生海量噪音告警,导致真正高危告警被淹没;优先配置高风险场景告警,持续做告警降噪分级。
相关文章推荐
- 三审合规法检查清单:等保2.0/PCI DSS/HIPAA 合规审计的 30 个关键控制点点此阅读
- 日志管理系统怎么选?先问清这 7 个问题再谈价格点此阅读
- IT运维效率提升指南:日志集中管理与自动化审计如何将故障排查时间缩短70% 点此阅读